

写Python爬虫违法吗?robots.txt协议与合规边界说明
针对写Python爬虫是否违法的疑虑,系统解析爬虫技术的中立性、三大法律红线、robots.txt君子协议的语法机制与Python实操校验,以及技术合规落地的具体规范。
写 Python 爬虫这项技术行为本身并不违法,但使用爬虫获取了什么数据、采取了什么抓取手段以及如何使用这些数据,直接决定了行为是否触碰法律底线。本文通过剖析爬虫触法的实质要件、拆解 robots.txt 协议的语法与技术解析方式,并提供具体的安全合规开发准则,帮助开发者明确合法采集与违法侵权的边界。
一、核心结论:技术中立与爬虫违法的判定依据
在计算机技术语境下,网络爬虫本质上是一段按照既定规则模拟用户向 Web 服务器发起 HTTP 请求、解析响应文本并提取目标数据的自动化程序。从搜索引擎检索到学术资料整理,爬虫属于普遍且中立的基础工具。法律惩处的是借助工具实施的危害行为,而非编写网络请求代码本身。
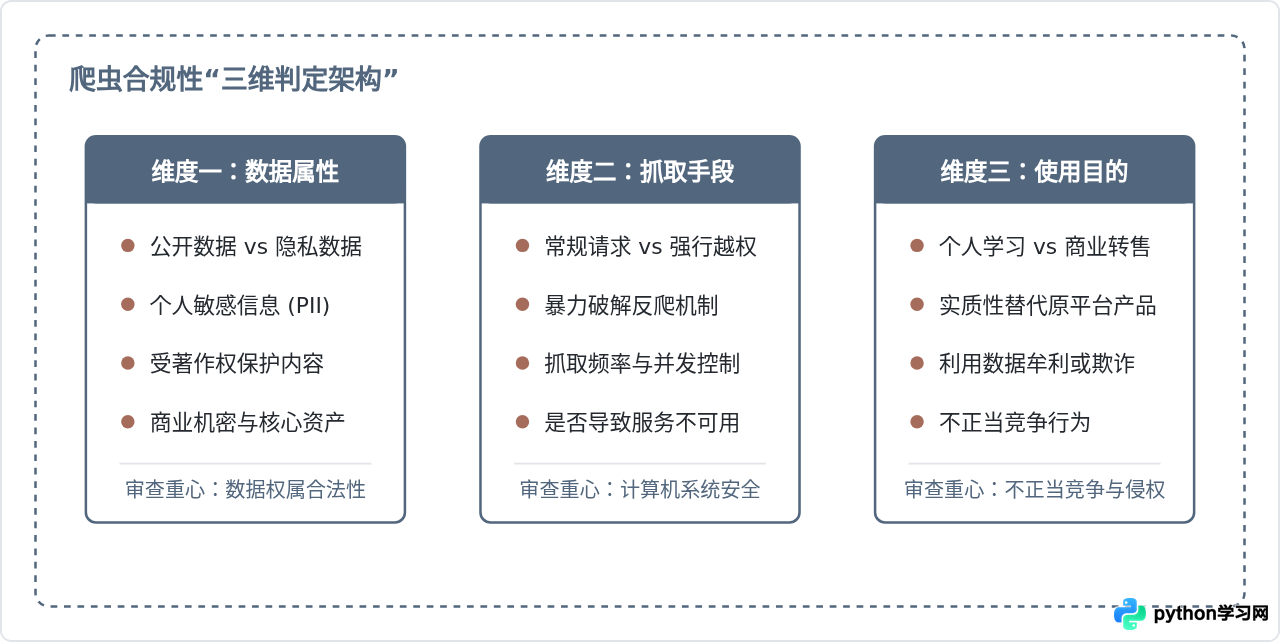
判断一次爬虫行为是否越界,通常可以拆解为三层审查逻辑:目标数据的性质、访问系统的方式,以及对数据的使用方式。如果一段简单的脚本频繁向服务器发送高并发请求导致目标网站崩溃,或者强行破解他人加密通道窃取受保护的隐私,哪怕脚本代码只有十余行,也已经构成了违法行为。
二、不可触碰的三条法律红线
在实际司法判例中,爬虫开发者与运营公司被追究责任的主要法律风险集中在以下三个方面:
1. 侵入、破坏计算机信息系统罪
如果目标网站设置了明确的访问控制措施(如强制登录认证、滑块验证码、IP 频次限制、Token 加密算法),而开发者通过反编译、伪造授权头信息、购买肉鸡代理池撞库、甚至利用系统漏洞强行突破防护拉取数据,可能触犯《中华人民共和国刑法》第二百八十五条(非法获取计算机信息系统数据罪)与第二百八十六条(破坏计算机信息系统罪)。此外,未经节制的超高并发导致目标服务器宕机或瘫痪,同样属于破坏系统正常运行的违法范畴。
2. 侵犯公民个人信息罪
抓取用户姓名、手机号、家庭住址、身份证号、行踪轨迹、通信记录或财产状况等个人敏感数据具有极高风险。《网络安全法》与《个人信息保护法》明确规定处理个人信息必须获得主体授权。一旦未经授权批量爬取个人隐私并在暗网转售、提供给第三方或者用于商业营销,根据《刑法》第二百五十三条之一,数量达到一定门槛(如敏感数据五十条以上,普通信息五千条以上)即构成刑事立案标准。
3. 不正当竞争与侵犯商业机密
即便数据本身是公开展示的(例如点评网站上的商户评论、招聘平台上的岗位信息),如果采集方抓取这些数据直接包装成竞争性产品,导致原平台用户流失,或者破坏了原平台付出了实质性智力与财务成本建立的商业壁垒,原告常会依据《反不正当竞争法》提起民事诉讼并索取巨额赔偿。
三、深入理解 robots.txt 协议
几乎每个主流 Web 站点的根目录下都有一个 robots.txt 文件(例如 https://example.com/robots.txt)。该协议被称为“网络爬虫排除标准”(Robots Exclusion Protocol),用于告知自动化爬虫哪些页面允许访问、哪些页面禁止抓取。
1. robots.txt 的法律性质
在法律上,robots.txt 属于行业通行的“君子协定”或技术性声明,它本身并非具有国家强制力的法律条文。
然而,不遵守 robots.txt 并不代表可以免责:
- 主观恶意的佐证:在民事纠纷中,如果网站在 robots.txt 中明确声明
Disallow: /data/,爬虫程序依然大量抓取该目录,法院会将该条文视为网站主观意愿的明确表达。开发者违背声明抓取,会被判定为具备明知故犯的主观恶意。 - 民事侵权的直接依据:在涉及《反不正当竞争法》的案件中,违反 robots.txt 的限制采集核心商业资产,往往成为不正当竞争认定的关键事实。
2. 协议基础语法解析
robots.txt 文件由若干记录块组成,每个记录块指定适用于特定爬虫代理(User-Agent)的指令集:
| 指令字段 | 作用说明 | 示例 |
|---|---|---|
User-agent |
指定该规则所约束的爬虫身份,* 表示通配所有爬虫。 |
User-agent: Googlebot 或 User-agent: * |
Disallow |
明确禁止访问的 URL 路径前缀。如果值为空,表示全部允许。 | Disallow: /admin/ |
Allow |
在被 Disallow 封锁的父级目录中,破例允许访问的子路径。 | Allow: /admin/public/ |
Crawl-delay |
非官方通用扩展,建议爬虫在相继请求之间等待的秒数。 | Crawl-delay: 5 |
四、实操校验:使用 Python 原生模块解析 robots.txt
编写爬虫时,无需自行手写复杂的正则来匹配网站的规则,Python 标准库中已经内置了 urllib.robotparser 模块,专门用于拉取并解析 robots.txt 文件。
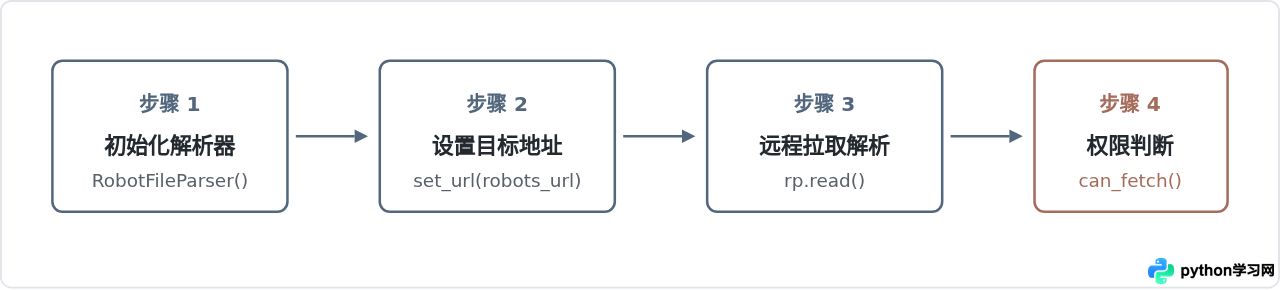
下面是一个完整的验证脚本,演示如何动态拉取目标站点的 robots.txt 并判断具体路径是否允许抓取:
import urllib.robotparser

def check_crawler_permission(robots_url: str, user_agent: str, target_url: str) -> bool:
    """
    检查指定爬虫是否有权限访问目标 URL
    """
    rp = urllib.robotparser.RobotFileParser()
    rp.set_url(robots_url)

    try:
        # 远程读取并解析 robots.txt 内容
        rp.read()
    except Exception as e:
        print(f"读取 robots.txt 失败: {e}")
        # 如果读取发生错误或文件不存在,通常依照规范视为未限制,但在合规设计上建议谨慎处置
        return False

    # 判断该 User-agent 是否被允许抓取 target_url
    can_fetch = rp.can_fetch(user_agent, target_url)
    return can_fetch

if __name__ == "__main__":
    # 以示例站点配置进行测试
    base_robots = "https://www.python.org/robots.txt"
    my_bot = "MyResearchBot"

    urls_to_test = [
        "https://www.python.org/doc/",
        "https://www.python.org/accounts/login/"
    ]

    for url in urls_to_test:
        allowed = check_crawler_permission(base_robots, my_bot, url)
        status = "允许抓取" if allowed else "禁止抓取"
        print(f"[{status}] -> {url}")
urllib.robotparser 默认以 Python 内置的 urllib.request 获取远程文件。如果目标站点拦截了 Python 默认的 User-Agent,可以在调用 rp.parse() 前自行通过 requests 库配置合规请求头下载文本,再将内容传入解析。
五、爬虫开发者的技术合规落地指南
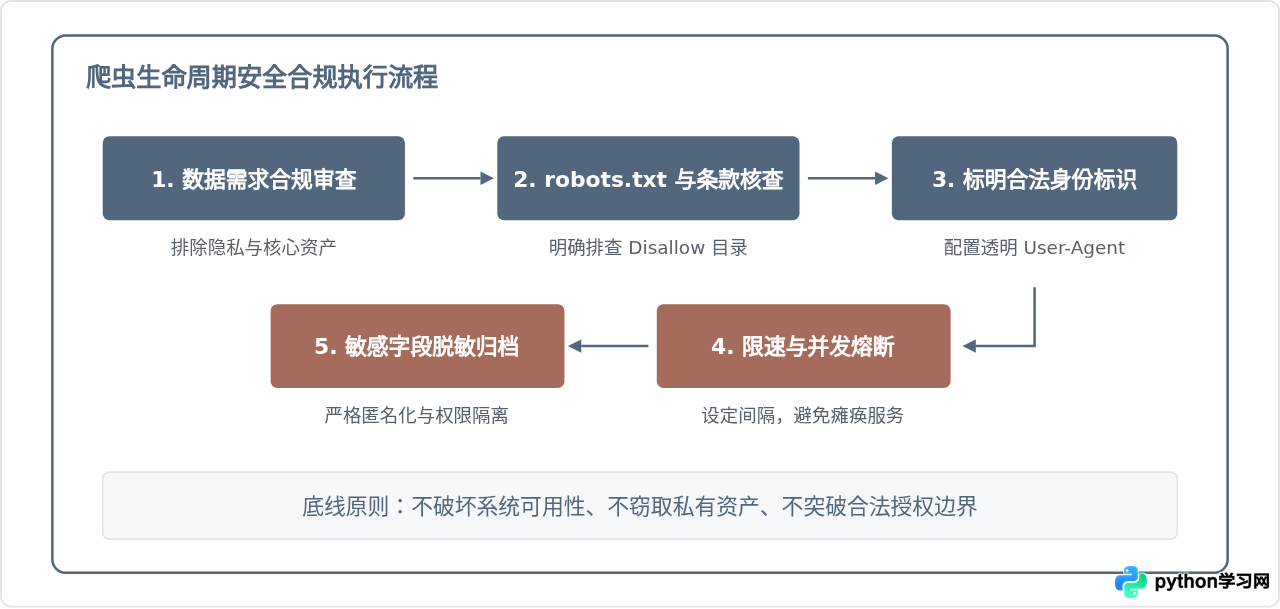
编写爬虫项目时,应在架构层面设立保护性策略,防范技术和法律风险。一套合格的工程化爬虫系统通常遵循以下执行顺序:
-
请求限速与退让策略:绝不能毫无节制地拉取数据。在请求循环中必须加入合理的延时逻辑(如
time.sleep(1)),避免对对方服务器造成 DDoS 式的负载压力。一旦服务器返回429 Too Many Requests或503 Service Unavailable,脚本应当立即进入指数退避(Exponential Backoff)等待或停止运行。 -
真实透明的 User-Agent:对于企业或研究机构的爬虫,应当在请求头中表明真实身份与联系方式(例如:
MyOrgSpider/1.0 (+http://myorg.com/bot.html; bot@myorg.com)),便于对方网管在系统负载过高时进行定向限流或联络,而不是一律伪造主流桌面浏览器的 User-Agent 伪装成普通用户。 - 避开反爬机制而非暴力破解:如果网站要求输入验证码或使用复杂加密方案对数据包签名,说明其有明确的“拒绝未授权采集”意图。此时强行逆向其 JS 混淆逻辑或调用破解平台绕过,极易构成针对安全措施的技术破坏。
- 入库脱敏与权限受控:采集到的结构化数据必须做好访问权限隔离,确保不会因开发者本地电脑遗失、服务器配置不当导致数据二次泄露。对于涉及人名的公开文本,在入库时可根据业务需要进行匿名化掩码处理。
六、总结与认知清单
Python 爬虫是强大的数据工程工具,但技术能力不能脱离合规约束。写爬虫前,建议开发者对照以下清单完成核验:
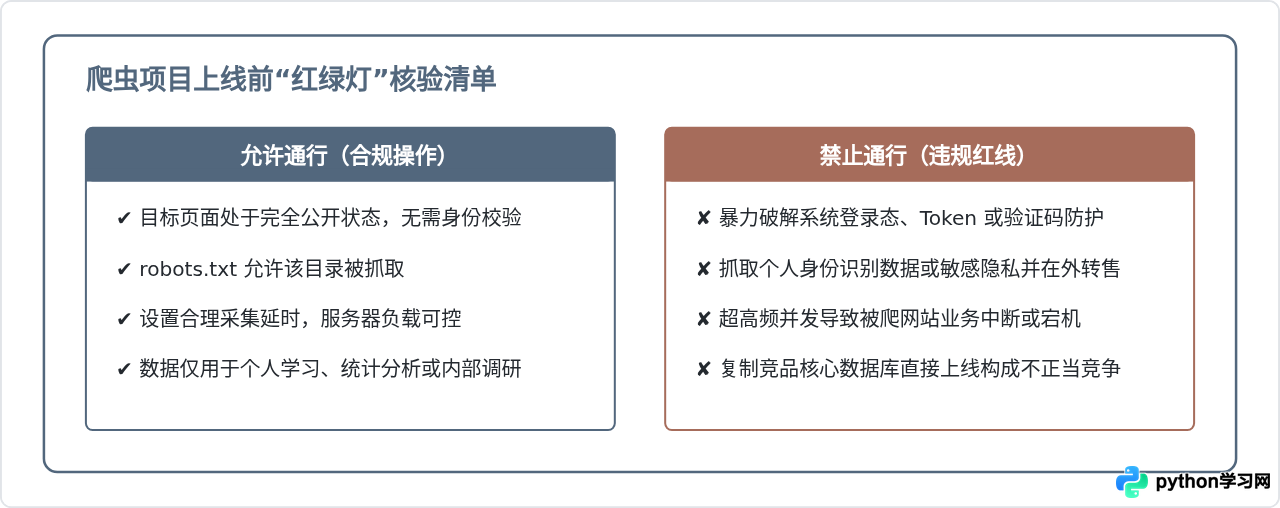
只要遵守技术中立的基本准则,尊重网站的访问意图(包括 robots.txt 规范),克制并发频次,远离个人隐私与未公开数据,Python 爬虫仍然是数据科学和自动化处理领域可靠高效的得力工具。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









