

Python字典常用操作函数汇总:增删改查方法速查表
全面汇总Python字典的增删改查核心操作函数与方法,提供直观的速查表、代码示例、底层原理解析及注意事项,帮助开发者快速掌握字典的日常使用。
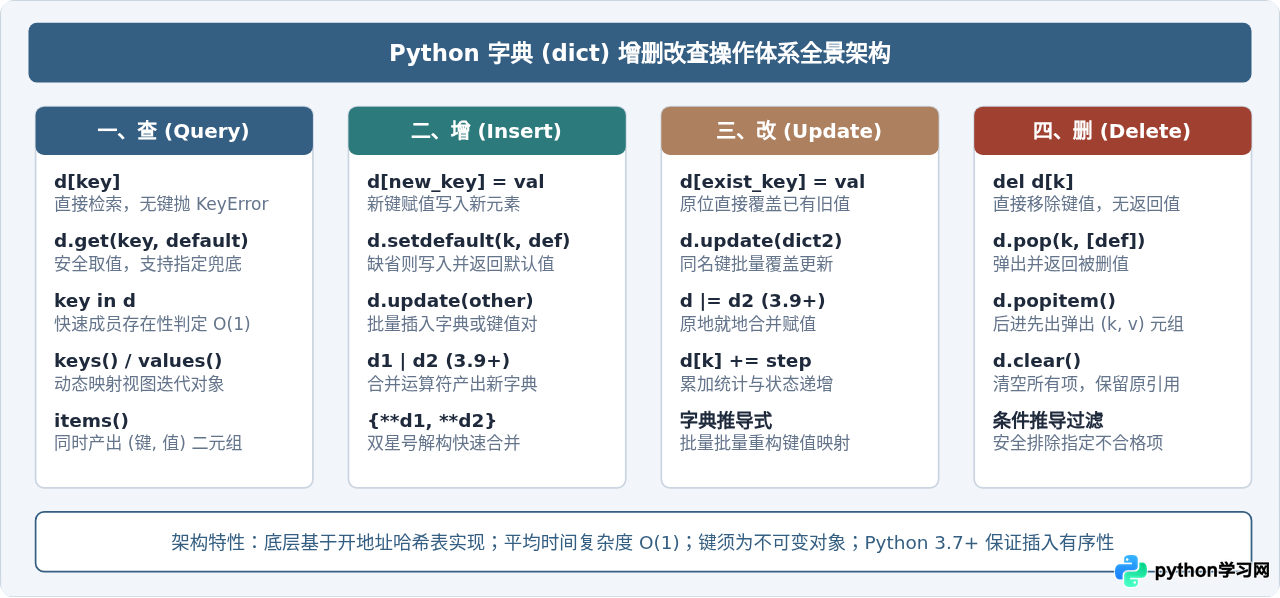
Python 字典(dict)是基于哈希表实现的键值映射容器。在日常开发中,不管是处理接口数据、解析配置文件还是构建业务模型,字典都是使用频率最高的核心数据结构。熟练掌握字典的增、删、改、查方法及其边界行为,能够帮助开发者写出更健壮、更高效的 Python 代码。本文将系统汇总 Python 字典的常用操作函数,分析其返回值、异常处理与执行机制,并提供完整的速查表供日常查阅。
一、查:键值检索、状态判断与遍历
查询是字典最核心的使用场景。Python 提供了多种从字典中检索数据的方式,它们在处理“键不存在”这一情况时的行为截然不同。
1. 直接下标访问:d[key]
通过方括号下标 d[key] 检索是语法最简洁、性能最高的方式。其时间复杂度为平均 O(1)。
注意:如果指定的 key 不在字典中,解释器会立即抛出 KeyError。因此,只有在业务逻辑百分之百确定该键存在时,才推荐直接使用下标访问。
info = {"name": "Alice", "role": "engineer"}

# 正常读取
print(info["name"])  # 示例输出: Alice

# 键不存在时触发 KeyError
# print(info["salary"])  # 报错: KeyError: 'salary'
2. 安全读取方法:d.get(key, default=None)
在面对外部输入、JSON 接口解析等不可控数据源时,get() 是最推荐的读取方法。如果键存在,返回对应的值;如果键不存在,默认返回 None,也可以传入自定义的兜底默认值,不会中断程序执行。
info = {"name": "Alice", "role": "engineer"}

# 键不存在时返回 None,不抛出异常
age = info.get("age")
print(age)  # 示例输出: None

# 指定默认兜底值
score = info.get("score", 60)
print(score)  # 示例输出: 60
3. 成员存在性检查:key in d
在决定是否读取或修改前,可以使用 in 关键字快速测试某个键是否存在于字典中。这是哈希操作,平均耗时仅为 O(1),远快于列表的遍历查询。
info = {"name": "Alice", "role": "engineer"}

if "salary" in info:
    print(info["salary"])
else:
    print("salary 字段未登记")  # 示例输出: salary 字段未登记
4. 遍历与视图对象:keys()、values()、items()
这三个方法返回的是字典的动态视图对象(View Objects)。视图对象不复制底层数据,当原字典发生改动时,视图内容会实时联动更新:
d.keys():提供字典中所有键的集合视图,支持集合的交集、并集等集合运算。d.values():提供字典中所有值的视图。d.items():提供(key, value)二元元组的视图,常用于双变量for循环解构。
scores = {"math": 95, "english": 88, "physics": 92}

# 同时获取键与值
for subject, score in scores.items():
    print(f"{subject}: {score}")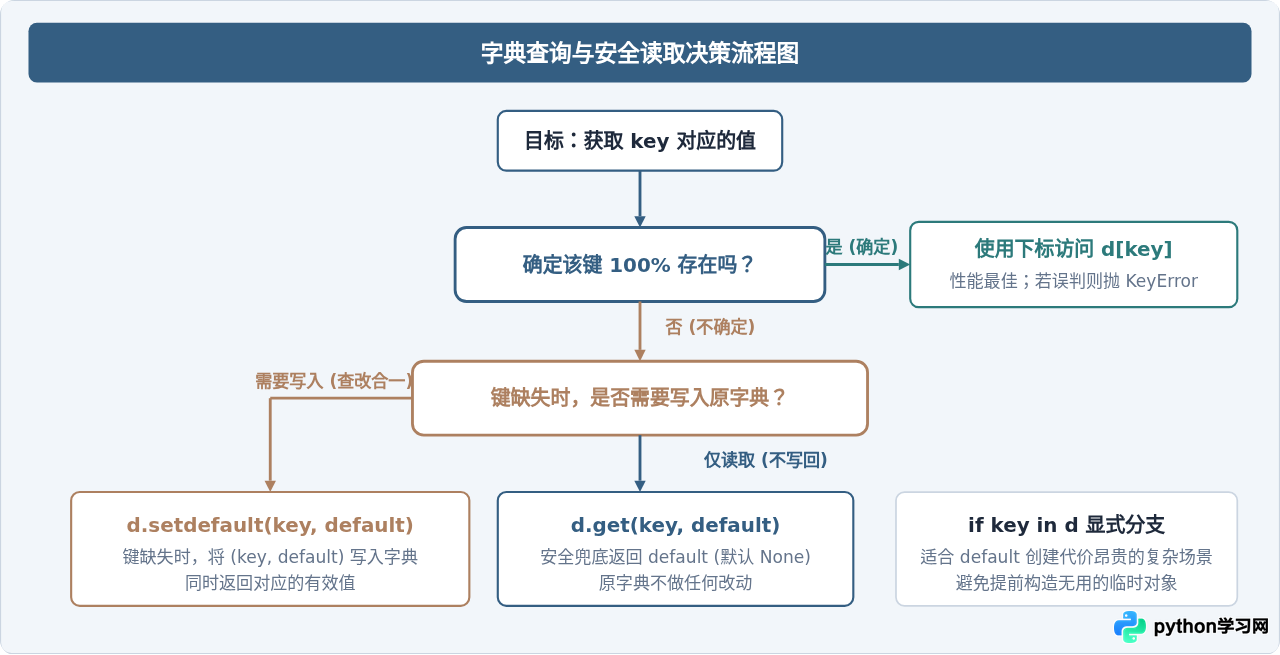
二、增与改:键值写入、批量更新与默认初始化
在 Python 中,“增”与“改”的语法边界非常紧密。由于字典中同一个键是唯一的,因此对已存在的键赋值即为修改,对不存在的键赋值即为新增。
1. 下标赋值:d[key] = value
最直接的基础操作。若 key 已经存在,更新其对应的 value;若不存在,在字典末尾追加该键值对。
config = {"host": "localhost", "port": 8080}

# 增:新增 debug 字段
config["debug"] = True

# 改:修改已有 port
config["port"] = 9000

print(config)
# 示例输出: {'host': 'localhost', 'port': 9000, 'debug': True}
2. 批量合并与更新:d.update([other])
update() 支持接收另一个字典或由 (key, value) 构成的可迭代对象。它会就地修改原字典:重叠的键覆盖为新值,未出现的新键则批量插入。
base_settings = {"theme": "light", "fontSize": 14}
user_settings = {"fontSize": 16, "autoSave": True}

# 将 user_settings 批量合并入 base_settings
base_settings.update(user_settings)
print(base_settings)
# 示例输出: {'theme': 'light', 'fontSize': 16, 'autoSave': True}
3. Python 3.9+ 字典合并运算符:| 与 |=
从 Python 3.9 开始,字典正式原生支持合并运算符:
d1 | d2:返回一个融合了两个字典内容的新字典,若键冲突则以右侧d2为准。原字典不被改变。d1 |= d2:原地就地更新d1,等价于d1.update(d2)。
dict_a = {"x": 1, "y": 2}
dict_b = {"y": 20, "z": 30}

# 非破坏性合并
merged = dict_a | dict_b
print(merged)  # 示例输出: {'x': 1, 'y': 20, 'z': 30}

# 就地合并
dict_a |= dict_b
print(dict_a)  # 示例输出: {'x': 1, 'y': 20, 'z': 30}
4. 条件插入并返回:d.setdefault(key, default=None)
setdefault() 常常被初学者忽视,但它是组织嵌套数据(例如多值映射、分组统计)的利器:
- 若
key存在:不改变原字典,直接返回该键已有的值。 - 若
key不存在:在字典中插入key: default,并返回该default。
# 场景:按部门对员工进行分组
users = [
    ("engineering", "Alice"),
    ("marketing", "Bob"),
    ("engineering", "Charlie")
]

dept_map = {}
for dept, name in users:
    # 若部门不存在则初始化为空列表并返回,随后追加名字
    dept_map.setdefault(dept, []).append(name)

print(dept_map)
# 示例输出: {'engineering': ['Alice', 'Charlie'], 'marketing': ['Bob']}
三、删:键值移除、出栈与字典清空
Python 提供了语句级和方法级的多种删除手段,根据是否需要获取被删元素、是否需要容错来决定具体用法。
1. del d[key] 语句
使用 Python 原生关键字 del,直接从字典底层哈希表中移除该项。它的开销最小,但不返回任何值。若目标 key 不存在,会触发 KeyError。
cache = {"token": "xyz123", "expire": 3600}

del cache["expire"]
print(cache)  # 示例输出: {'token': 'xyz123'}
2. d.pop(key[, default]) 方法
与 del 不同,pop() 会将键对应的值“弹出”并作为返回值。更关键的是,它支持传入可选的 default 参数:当键不存在时,若传了 default 则返回该值,不会引发 KeyError。
cache = {"token": "xyz123", "expire": 3600}

# 弹出并获取值
token = cache.pop("token")
print(f"弹出的令牌: {token}")  # 示例输出: 弹出的令牌: xyz123

# 安全删除不存在的键,指定默认值防报错
removed = cache.pop("non_exist_key", None)
print(removed)  # 示例输出: None
3. d.popitem() 方法
移除并返回字典末尾的最后一对 (key, value) 元组。因为 Python 3.7+ 的字典严格维护插入顺序,所以 popitem() 具备确定性的后进先出(LIFO)行为,类似于栈顶弹出。若在空字典上调用则报 KeyError。
queue = {"task1": "pending", "task2": "running", "task3": "done"}

last_item = queue.popitem()
print(last_item)  # 示例输出: ('task3', 'done')
print(queue)      # 示例输出: {'task1': 'pending', 'task2': 'running'}
4. d.clear() 方法
移除字典中的所有元素,将其变成空字典 {}。注意:d.clear() 是就地清空原内存对象。如果其他变量也引用了这个字典,它们看到的数据也会同步清空;而直接执行 d = {} 只是让变量指向一个崭新的空字典,不会影响已有引用。
original = {"a": 1, "b": 2}
alias = original

# 就地清空原对象
original.clear()
print(original)  # 示例输出: {}
print(alias)     # 示例输出: {} (所有别名同步清空)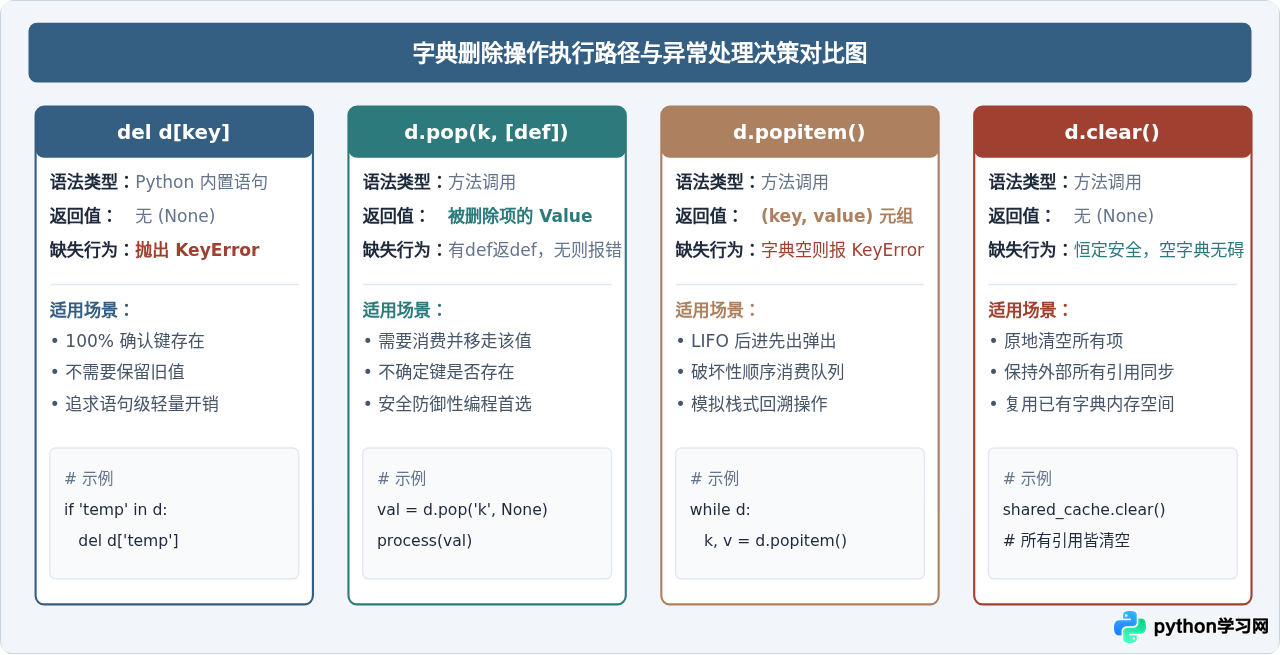
四、Python 字典常用操作函数速查表
下表汇集了日常开发中最常用的字典内置函数与操作语法,涵盖复杂度、返回值及边界行为,方便快速比对与选型:
| 操作分类 | 函数 / 语法 | 时间复杂度 | 返回值 | 键不存在时的行为 | 典型应用场景 |
|---|---|---|---|---|---|
| 查 | d[key] |
O(1) | 对应 Value | 抛出 KeyError |
完全确信键必然存在的高频访问 |
| 查 | d.get(k, default) |
O(1) | 对应 Value 或 default | 返回 default(默认 None) |
不确定键是否存在,提供安全兜底 |
| 查 | k in d |
O(1) | bool |
返回 False |
条件分支前的前置探测 |
| 查 | d.keys() |
O(1) | dict_keys 视图 |
不涉及具体键 | 键集合运算或键列表遍历 |
| 查 | d.values() |
O(1) | dict_values 视图 |
不涉及具体键 | 聚合统计(求和、求最值等) |
| 查 | d.items() |
O(1) | dict_items 视图 |
不涉及具体键 | 双变量同时解构键与值 |
| 增 / 改 | d[key] = val |
O(1) | 无 (None) |
作为新键直接插入 | 最常用的单个键值写入与覆盖 |
| 增 / 改 | d.update(other) |
O(M) | 无 (None) |
批量写入所有新键 | 批量合入配置、字典合并 |
| 增 / 改 | d1 | d2 (3.9+) |
O(N+M) | 合并后的新字典 | 右侧覆盖左侧,合并所有项 | 不可变函数式合并,保留原对象 |
| 增 / 查 | d.setdefault(k, def) |
O(1) | 对应已有值或 def | 插入 k: def 并返回 def |
分类分组、嵌套容器初始化 |
| 删 | del d[key] |
O(1) | 无 (None) |
抛出 KeyError |
快速剔除无用字段,不关心旧值 |
| 删 | d.pop(k, [def]) |
O(1) | 被删除的 Value | 有 def 返 def,无则抛 KeyError |
取走旧值并剔除,支持安全兜底 |
| 删 | d.popitem() |
O(1) | (key, value) 元组 |
字典为空时抛出 KeyError |
按后进先出 (LIFO) 顺序消费字典 |
| 删 | d.clear() |
O(N) | 无 (None) |
空字典正常执行,不报错 | 原地重置字典内容,保持外部引用一致 |
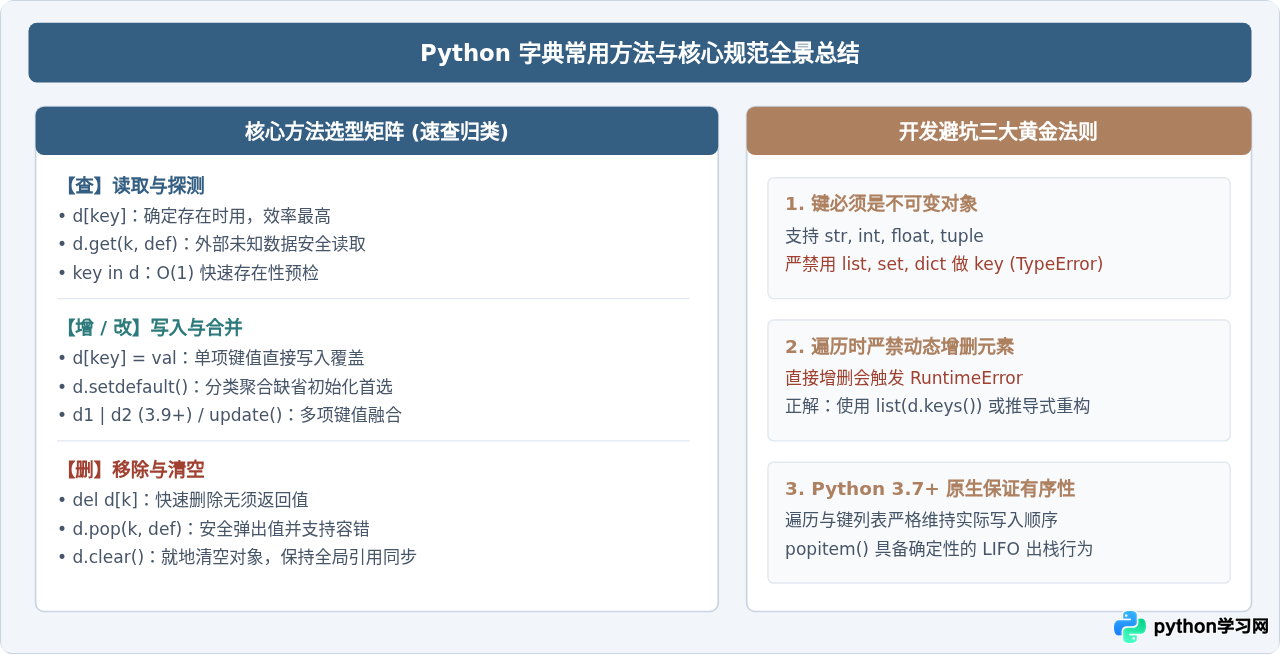
五、核心机制与避坑实践指南
Python 字典的底层依赖散列函数 hash(key) 计算哈希槽位。因此,作为键的对象生命周期内哈希值必须恒定不可变:
- 合法键:
str、int、float、tuple(元素也必须全为可哈希对象)、frozenset。 - 非法键:
list、dict、set。若将它们用作键,会立即触发TypeError: unhashable type: 'list'。
在直接遍历字典的过程中(如 for k in d:),如果尝试执行 del d[k] 或插入新键,Python 会立即检测到哈希表结构变更并抛出异常:
# 错误示例:引发 RuntimeError
d = {"a": 1, "b": 2, "c": 3}
for k in d:
    if d[k] % 2 == 0:
        del d[k]  # 报错: RuntimeError: dictionary changed size during iteration

# 正确做法 1:将键视图转为静态列表快照
for k in list(d.keys()):
    if d[k] % 2 == 0:
        del d[k]

# 正确做法 2:使用字典推导式生成新字典
d = {k: v for k, v in d.items() if v % 2 != 0}从 Python 3.7 开始,字典不仅拥有 O(1) 的常数级查找性能,且语言规范正式承诺保留元素的插入顺序。这意味着:
- 遍历字典时产出键的顺序,严格与它们最初被写入时的顺序一致。
d.popitem()具备严格的后进先出(LIFO)特征,即弹出最后一次新写入的键值对。
结语
Python 字典之所以强大,在于其平衡了简洁优雅的语法表达与极其出色的常数级运行性能。在日常编码中,优先使用 get() 和 in 防御未知键,利用 setdefault() 简化复杂数据聚合,借助 update() 与运算符 | 处理多源数据整合,并遵循安全删除与遍历规范,即可写出兼具可读性、健壮性与高性能的工程代码。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









