

llama.cpp b12489、b12490、b12491、b12492、b12493、b12494、b12496、b12497、b12498 预发布构建如何对应模型和后端?
llama.cpp b12489、b12490、b12491、b12492、b12493、b12494、b12496、b12497、b12498 均为预发布构建,分别涉及服务器、语音模型及特定后端;适用范围须按模型、硬件和请求条件区分。
这组预发布构建的适用性取决于任务类型:服务器请求检查与调度、三类语音模型,以及若干限定模型或 GPU 后端的计算路径。构建号更高并不意味着每项任务都会更快;九份发行说明都属于预发布记录,不能当作正式稳定版承诺。
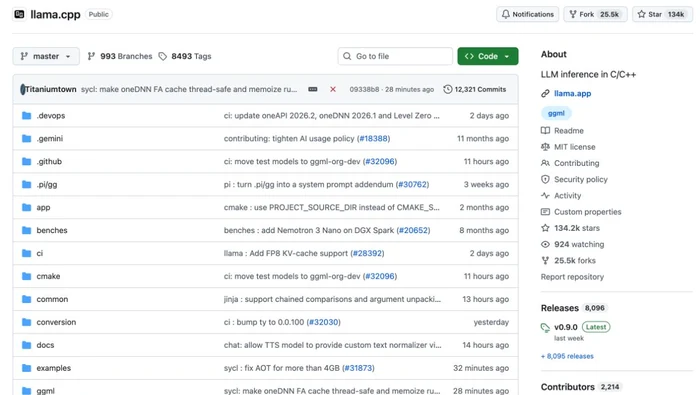
先理解九个完整构建号的范围
llama.cpp 本次记录覆盖 b12489、b12490、b12491、b12492、b12493、b12494、b12496、b12497、b12498。它们有各自的变更主题和发行资产;模型支持、参数校验和计算内核变化,解决的是不同层面的问题。
服务端的两条记录各解决什么?
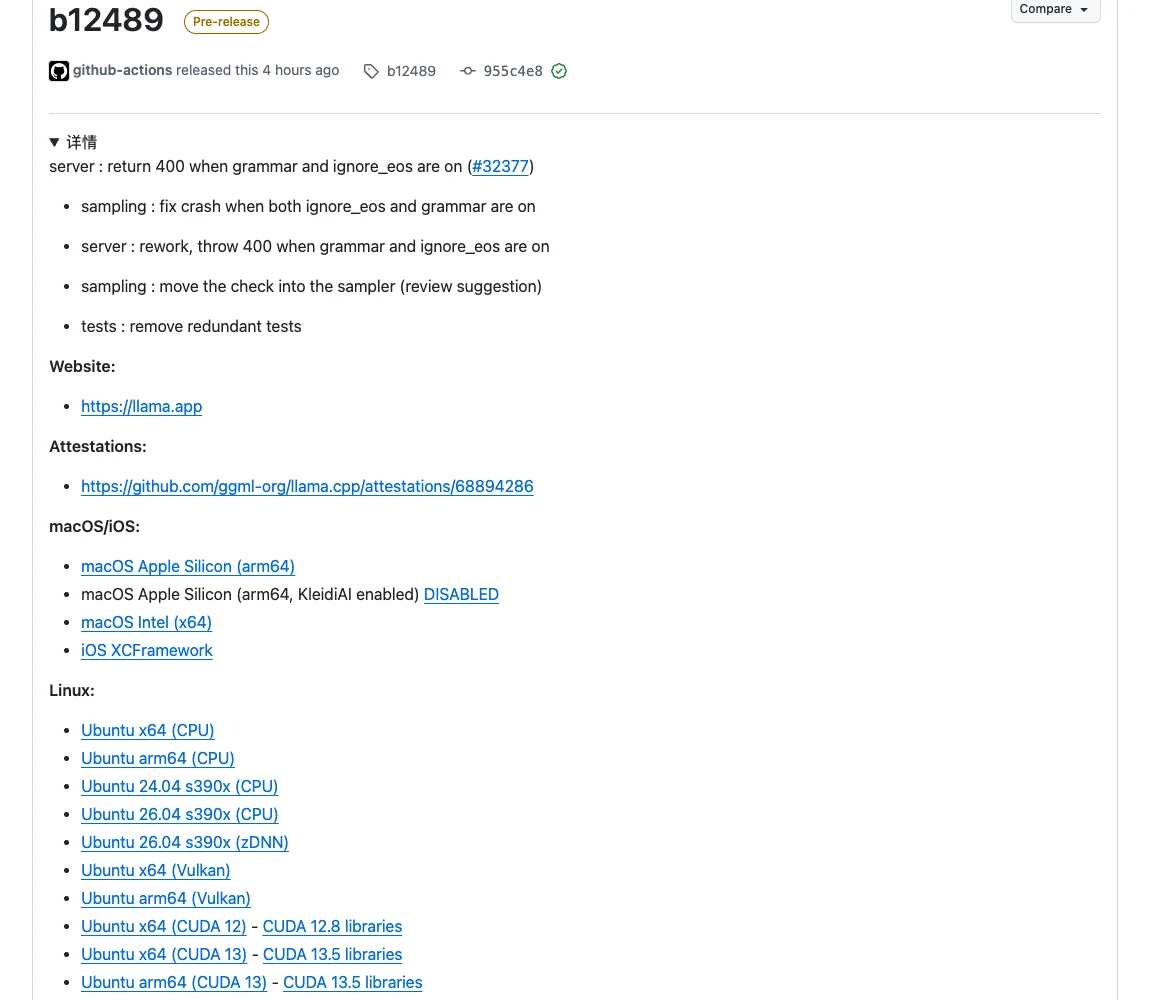
b12489 对 grammar 与 ignore_eos 同时启用的场景作出处理:修复相关采样崩溃,并让服务器返回 HTTP 400,检查位置进入采样器。因此,返回错误是对该参数组合的明确拒绝,不能理解为允许它们同时生效。
b12498 的主题是 slot_sched,涉及 LoRA 与 recurrent 的服务器调度修复。发行说明同时提到混合 SWA 检查点测试:缓存与非缓存运行分成不同的 ubatch 时,在 CUDA 上会走不同的内核条件,从而影响相近概率的排序。
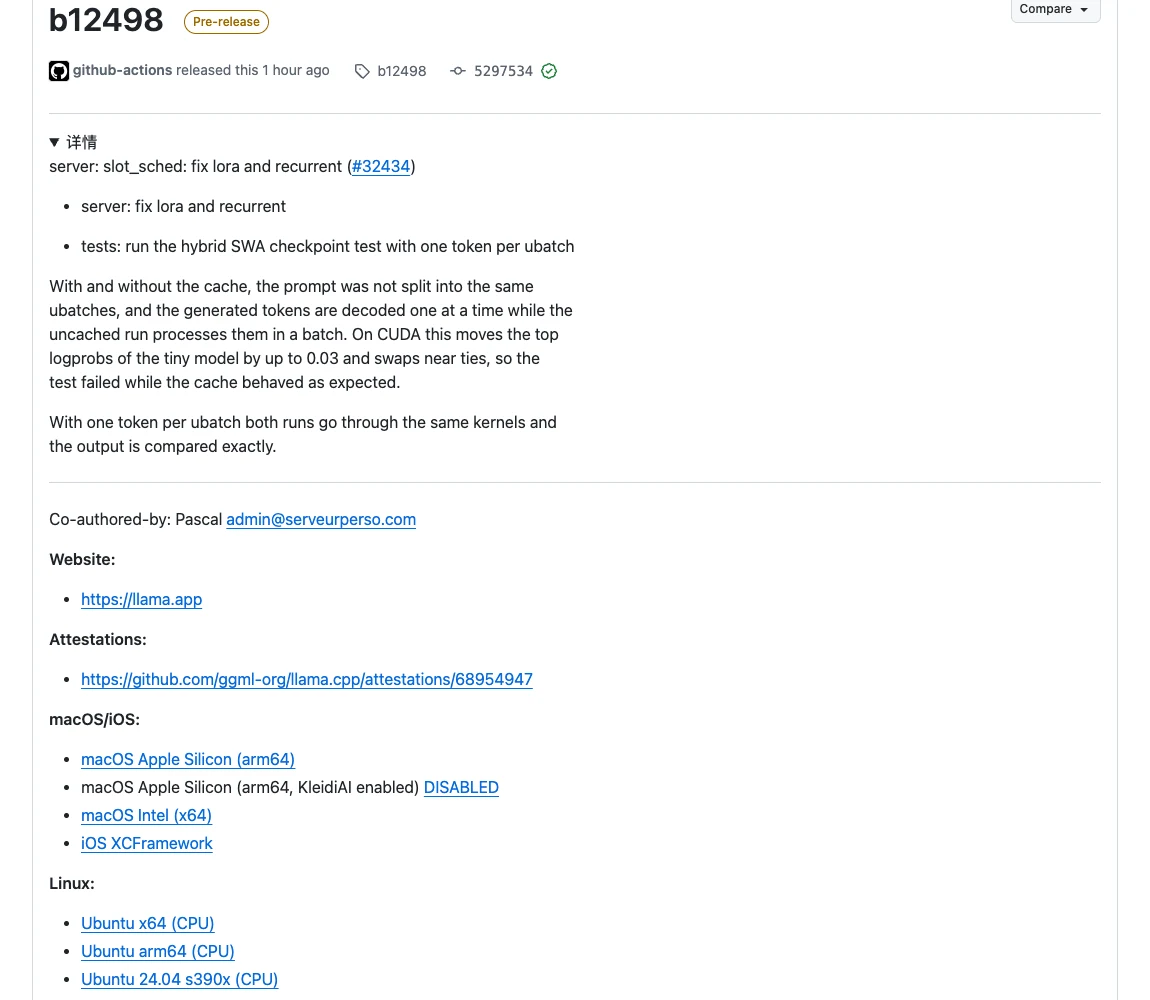
测试改为每个 ubatch 一个 token,是为了让比较使用同样的内核路径并能精确比较输出。这个测试条件的收紧,不等于对所有模型的数值一致性作出保证,也不能反推旧缓存必然错误。它与调度修复应分别看待。
语音需求应该对应到具体模型
b12491 为 mtmd 加入 Qwen3-TTS 的 ICL/reference mode,修改还覆盖正确性及转录信息的附着。该范围是 Qwen3-TTS 的参考模式,而不是通用语音接口自动拥有全部模型能力。
b12494 提供的是 Kokoro TTS 支持。其变更内容包含 G2P 模板、文本规范化相关说明、模板作用域查找和批处理 API 迁移。与前一个条目相比,模型和文本处理路径都不同,不能套用为 Qwen3-TTS 的参数介绍。
b12497 面向 tiny-voca,增加该模型支持并改进 G2P。对于依赖语音能力的应用,三项记录有助于确认支持对象,但不能单凭“新增支持”就认定任意模型权重和输入形式均兼容。
后端优化为什么必须带着条件理解?
b12490 修复 qwen4exp 中 n-gram 表缩放引起的图重新分配:缩放通过 ggml_scale 应用,缩放值在加载后读取一次。这是指定模型路径的修复,不是对所有 Qwen 系列行为的结论。
b12492 为 OpenCL 增加 A7 Q5_K non-MoE 二进制内核。这里同时限制了后端、量化格式和模型类型,发行主题并没有覆盖全部 OpenCL 配置。
b12493 调整 CUDA 卷积路径,让 F32 卷积核也能进入 implicit GEMM conv2d。实现说明包含在池缓冲区中将 F32 卷积核转换成 F16,随后保留 F32 累加。因此它不等同于所有中间操作数均使用 F32;也没有提供任意模型的统一加速倍率。
b12496 在 HIP 中调整 stream_k 和 MMQ 配置,目标是 AMD GCN 的相应路径。说明中特别提到 CDNA 测试没有改善,因而该变化不能泛化为每种 AMD GPU 都会受益。
源码里的支持为什么不等于所有安装包都可用?
标签所指的源码修订、源码归档和预编译分发包有不同含义。新增代码说明仓库实现发生了变化;某个具体程序包是否包含相应能力,还取决于发行资产的系统、架构及后端类型。正式版与预发布状态也应以发行记录为准。
这组信息适合用于建立问题与构建的对应关系:参数组合看 b12489,调度看 b12498,语音看模型条目,计算看对应后端和硬件。官方说明没有替读者完成目标设备的测试,因此兼容性与实际收益仍不能从构建编号直接得出。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









