

python必背源代码定义类和实例化代码
完整总结Python中定义类与实例化的必背核心源代码、执行生命周期与实战代码模板。包含标准类定义、构造函数__init__、self形参机制、属性与方法绑定及常见避坑要点。
class 声明、初始化构造函数 __init__、显式实例形参 self 的绑定机制,以及如何通过类名调用生成拥有独立状态属性的实例对象。
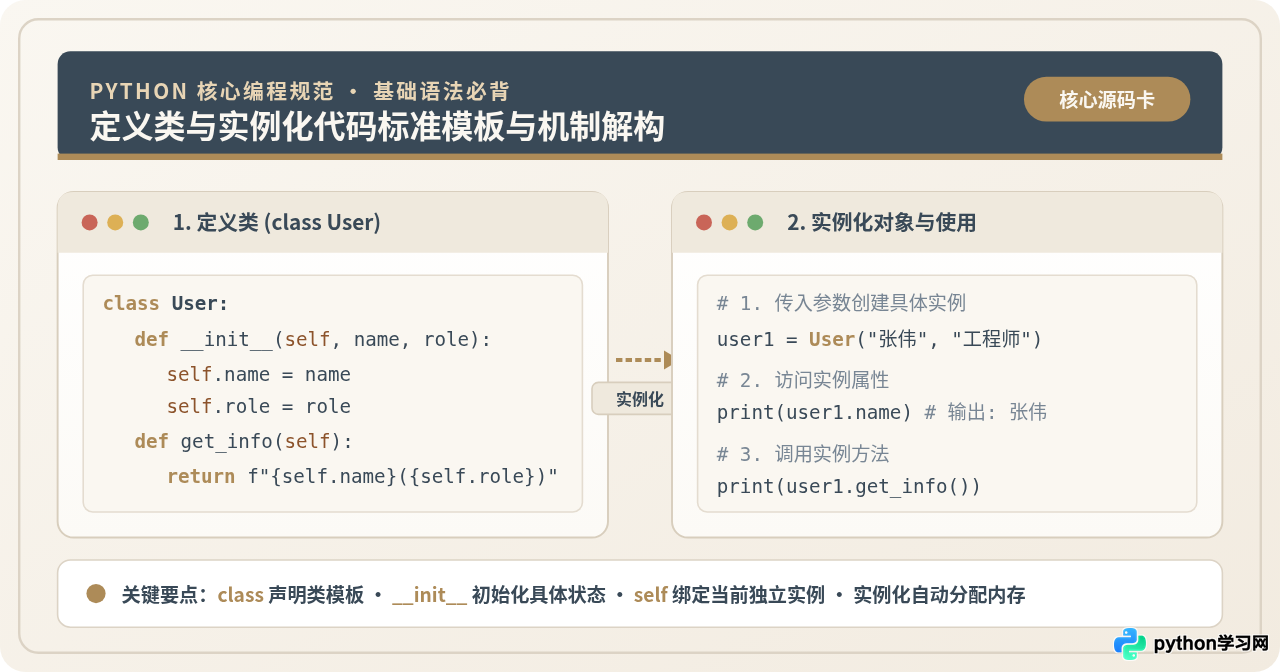
一、定义类与实例化的核心必背源码模板
以下是在 Python 中定义类和实例化的最标准、最精简源码。该代码可以直接在 Python 3 环境中复制运行,它涵盖了类定义、构造初始化、实例属性赋值、实例方法定义、对象实例化以及属性与方法调用的完整闭环:
# 1. 定义类:使用 class 关键字,类名使用大驼峰命名规范
class Student:
    """学生信息与成绩管理类"""

    # 构造初始化方法:当创建新实例时自动执行
    def __init__(self, name: str, age: int, score: float):
        # 将传入的实参绑定到当前实例对象(self)的属性上
        self.name = name
        self.age = age
        self.score = score

    # 实例方法:首个参数必须为 self,表示调用该方法的当前实例
    def get_info(self) -> str:
        return f"学生姓名: {self.name}, 年龄: {self.age}, 成绩: {self.score}"

    def is_passed(self) -> bool:
        return self.score >= 60.0


# 2. 实例化对象:通过 类名(参数列表) 调用,自动分配内存并触发 __init__
student1 = Student(name="张小明", age=16, score=88.5)
student2 = Student(name="李小华", age=17, score=54.0)

# 3. 访问实例属性(直接通过 实例名.属性名)
print(student1.name)   # 访问 student1 的独立姓名属性
print(student2.score)  # 访问 student2 的独立成绩属性

# 4. 调用实例方法(直接通过 实例名.方法名())
print(student1.get_info())
print(f"小华是否及格: {student2.is_passed()}")54.0
学生姓名: 张小明, 年龄: 16, 成绩: 88.5
小华是否及格: False
在这段基础源代码中,Student 是类的名称,承担“图纸”或“模具”的角色;而 student1 与 student2 则是通过该模具压制出的两个具体“实体”。尽管两者共享类中定义的 get_info() 与 is_passed() 方法,但各自持有的 name、age、score 属性完全独立,存放在各自的实例内存空间中。
二、类定义与实例化的执行全流程步骤
要真正写出无故障的面向对象代码,不仅需要背诵语法模板,更需要清晰理解 Python 解释器在背后执行类声明和实例化调用时的具体步骤顺序。
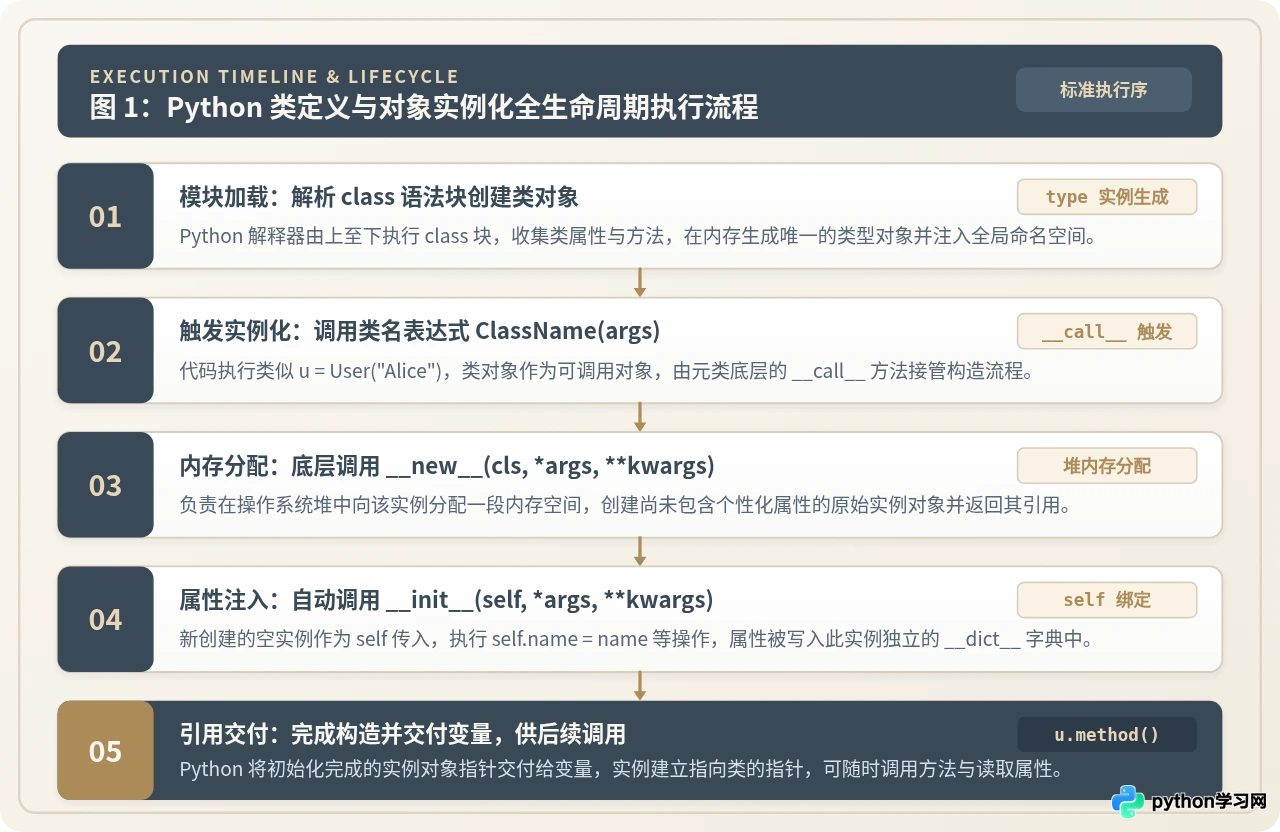
如图 1 所示,整个生命周期分为明确的五个步骤:
- 模块加载与类定义:当 Python 解释器读到
class Student:代码块时,会从上到下执行其中的代码,并将所有定义的函数与变量打包进该类的命名空间字典,生成一个全局唯一的type实例(即类对象Student)。 - 触发实例化调用:当执行到
s = Student("张小明", 16, 88.5)时,括号表达式将类对象作为可调用对象触发,执行其元类的__call__方法。 - 分配底层内存(
__new__):解释器首先调用类的底层静态构造方法__new__(cls),向系统堆内存申请一块干净的地址,生成未初始化的空实例对象。 - 属性绑定与初始化(
__init__):紧接着,解释器自动调用__init__(self, ...),并将上一步生成的空实例作为第一个实参传递给self,随后将传入的业务数据赋值给self.attr。 - 交付实例引用:初始化完成后,构造方法隐式返回该实例的内存引用并赋值给目标变量
s,此时该实例即可自由访问属性与执行方法。
三、核心语法要素详细剖析:class、__init__ 与 self
初学者在背诵类定义代码时,往往容易混淆 class、__init__ 以及 self 三者的实际作用与关联。以下是对这三大关键要素的具体拆解:
1. class 关键字与命名规范
class 是 Python 用于声明类的保留关键字。根据 PEP 8 官方编码规范,类名必须使用大驼峰命名法(PascalCase),即每个单词首字母大写且不使用下划线(例如 UserProfile、DataAnalyzer、Student)。类名后面紧跟冒号 :,随后所有属于类体的内容均需保持统一缩进(通常为 4 个空格)。
2. __init__ 构造初始化方法
__init__ 是 Python 的特殊魔法方法(Dunder Method,即双下划线方法)。需要格外注意的是:
- 它不是用来从零创建实例的(创建实例由
__new__完成),而是用来给刚创建好的空实例进行属性初始化赋值的。 __init__方法必须始终返回None,切勿在其中显式编写return value,否则 Python 解释器在实例化时会直接抛出TypeError: __init__() should return None。
3. self 形参的本质与隐式传递
self 并不是 Python 的系统关键字,而是一个强约定的形参名称。在任何实例方法中,第一个参数都必须声明为 self,它的物理含义是“当前调用此方法的具体实例对象本身”。
class Device:
    def __init__(self, device_id: str):
        # 此时 self 指向新分配的空内存实例
        self.device_id = device_id

    def reboot(self):
        # 在实例方法内部,通过 self 获知正在操作哪一台设备
        print(f"设备 [{self.device_id}] 正在重启...")

# 实例化
d1 = Device("DEV-001")
d2 = Device("DEV-002")

# 常规方法调用写法(语法糖)
d1.reboot()

# 等价的底层实际调用写法(揭示 self 的真相)
Device.reboot(d1)设备 [DEV-001] 正在重启...
由此可见,代码 d1.reboot() 在底层被 Python 自动转换为了 Device.reboot(d1)。实例本身被隐式作为第一个参数传入,这就是为什么定义方法时必须写 self,但调用方法时却不需要手动传递 self 的根本原因。
四、类对象与实例对象的底层内存架构与绑定关系
为了加深对实例化机制的理解,图 2 展示了类在定义后以及多次实例化后,Python 运行时堆内存中的数据结构分布与指针映射关系。
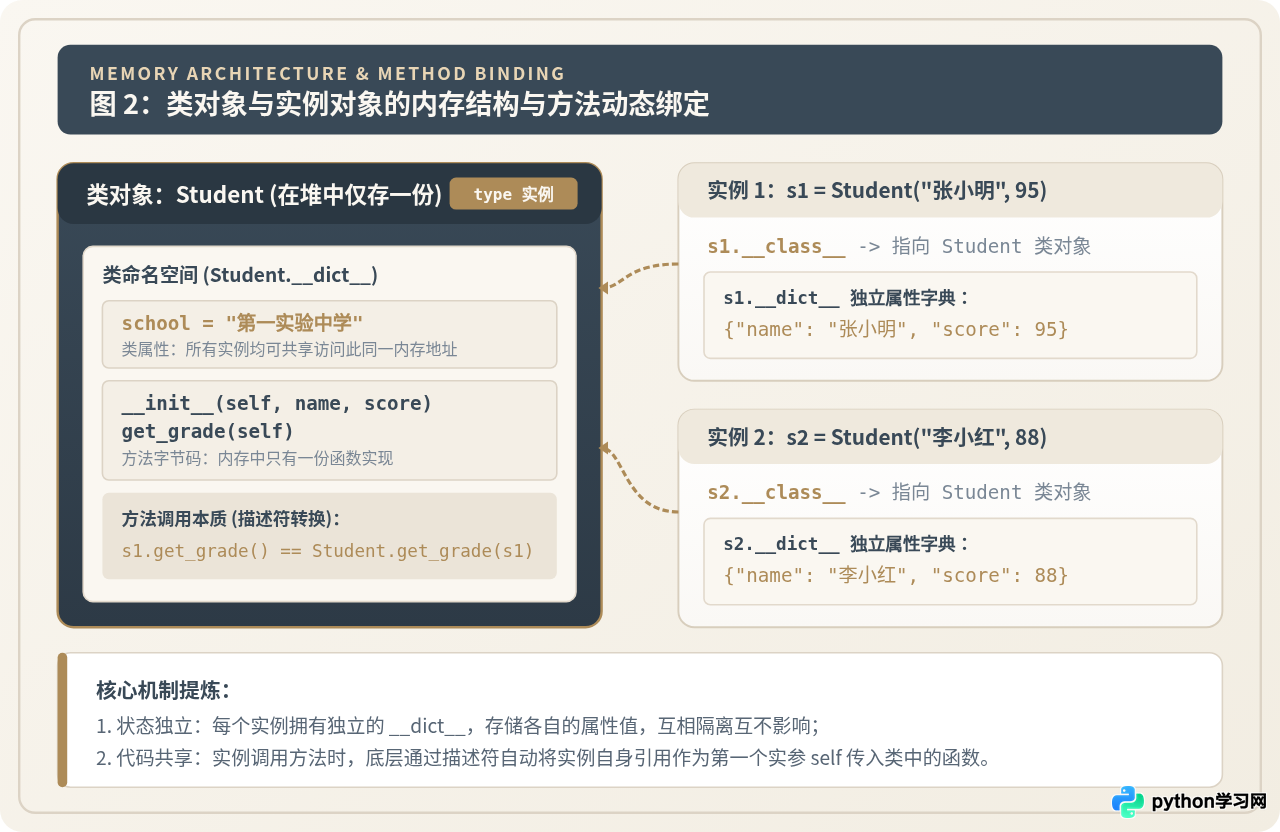
__dict__ 属性字典,通过 __class__ 指向所属类。
从图 2 可以清晰观察到 Python 对象的内存组织规律:
- 代码复用性:无论实例化 10 个还是 10,000 个对象,类中定义的函数与方法字节码在内存中永远只有一份,保存在
Student.__dict__中。 - 状态隔离性:每个实例
s1、s2拥有专属于自己的__dict__哈希表,分别存放{"name": "张小明", "score": 95}与{"name": "李小红", "score": 88}。修改s1.name绝对不可能波及s2.name。
五、必背的高频实战源码模式
在实际工程项目中,仅掌握最基础的属性赋值往往不够。以下整理了四种在日常开发和面试中最常考、最实用的 Python 类与实例化代码范式:
模式 1:带默认参数与可选属性的标准数据类
在定义类时,合理为 __init__ 设置默认值,可以让对象的实例化更加灵活,支持缺省构造:
class ServerConfig:
    """服务器配置类:展示默认参数与可选参数"""
    def __init__(self, host: str, port: int = 8080, use_ssl: bool = False, max_clients: int = 100):
        self.host = host
        self.port = port
        self.use_ssl = use_ssl
        self.max_clients = max_clients

    def get_url(self) -> str:
        protocol = "https" if self.use_ssl else "http"
        return f"{protocol}://{self.host}:{self.port}"

# 实例化方式 1:全部使用默认参数(只需传必要项 host)
srv1 = ServerConfig("127.0.0.1")
print(srv1.get_url())  # 输出: http://127.0.0.1:8080

# 实例化方式 2:使用关键字参数覆盖默认项
srv2 = ServerConfig("api.example.com", port=443, use_ssl=True)
print(srv2.get_url()) # 输出: https://api.example.com:443https://api.example.com:443
模式 2:类属性(共享状态)与实例属性(独立状态)
直接在 class 块下缩进定义的变量称为类属性,所有实例共享此属性;而在 __init__ 中挂在 self 上的变量称为实例属性。
class Employee:
    # 类属性:统计已实例化的员工总人数(全类共享)
    total_count = 0
    company_name = "未来科技集团"

    def __init__(self, name: str, salary: float):
        # 实例属性:每个员工各自的姓名和薪水
        self.name = name
        self.salary = salary

        # 每次成功实例化一个对象,将类属性计数器自增 1
        Employee.total_count += 1

# 实例化 3 个员工对象
e1 = Employee("赵一", 12000.0)
e2 = Employee("钱二", 15000.0)
e3 = Employee("孙三", 18000.0)

print(f"公司名称: {Employee.company_name}")
print(f"当前在职总人数: {Employee.total_count}")
print(f"员工1姓名: {e1.name}, 所在公司: {e1.company_name}")当前在职总人数: 3
员工1姓名: 赵一, 所在公司: 未来科技集团
模式 3:使用 @property 装饰器封装只读属性与数据校验
在面向对象设计中,直接暴露内部属性容易导致被外部代码赋入脏数据。必背的标准解法是结合单下划线命名约定与 @property 装饰器:
class BankAccount:
    """银行账户类:演示属性只读封装与设值校验"""
    def __init__(self, account_no: str, initial_balance: float = 0.0):
        self.account_no = account_no
        # 单下划线前缀表示内部受保护属性
        if initial_balance < 0:
            raise ValueError("初始余额不能为负数")
        self._balance = float(initial_balance)

    # 声明只读属性:外部可通过 account.balance 读取,无法直接赋值
    @property
    def balance(self) -> float:
        return self._balance

    def deposit(self, amount: float):
        """存入现金"""
        if amount <= 0:
            raise ValueError("存款金额必须大于零")
        self._balance += amount

    def withdraw(self, amount: float):
        """支取现金"""
        if amount <= 0:
            raise ValueError("取款金额必须大于零")
        if amount > self._balance:
            raise ValueError("账户余额不足")
        self._balance -= amount

# 实例化与操作
acc = BankAccount("6222020011223344", 500.0)
print(f"当前可用余额: {acc.balance}")

acc.deposit(200.0)
acc.withdraw(150.0)
print(f"交易后余额: {acc.balance}")

# 尝试直接赋值非法只读属性将触发错误
# acc.balance = 999999 # AttributeError: can't set attribute交易后余额: 550.0
模式 4:实现 __str__ 与 __repr__ 友好调试字符串
默认情况下,直接 print(instance) 只会输出无意义的内存地址(如 <__main__.User object at 0x7fa890>)。工程必背代码是通过重写 __str__ 返回人类易读的展示文本:
class Product:
    def __init__(self, sku: str, title: str, price: float):
        self.sku = sku
        self.title = title
        self.price = price

    # 当被 print() 或 str() 调用时触发
    def __str__(self) -> str:
        return f"商品[{self.sku}]: {self.title} (售价: ¥{self.price:.2f})"

    # 当在控制台直接输入变量或交互调试时触发
    def __repr__(self) -> str:
        return f"Product(sku={self.sku!r}, title={self.title!r}, price={self.price})"

p = Product("SKU-9081", "人体工学办公椅", 899.0)
print(p)          # 自动触发 __str__
print(repr(p)) # 自动触发 __repr__Product(sku='SKU-9081', title='人体工学办公椅', price=899.0)
六、类属性与实例属性的查找链与遮蔽机制对比
在读写属性时,Python 存在严格的就近查找机制与赋值行为差异。理解这一机制对于规避各类诡异 bug 至关重要。
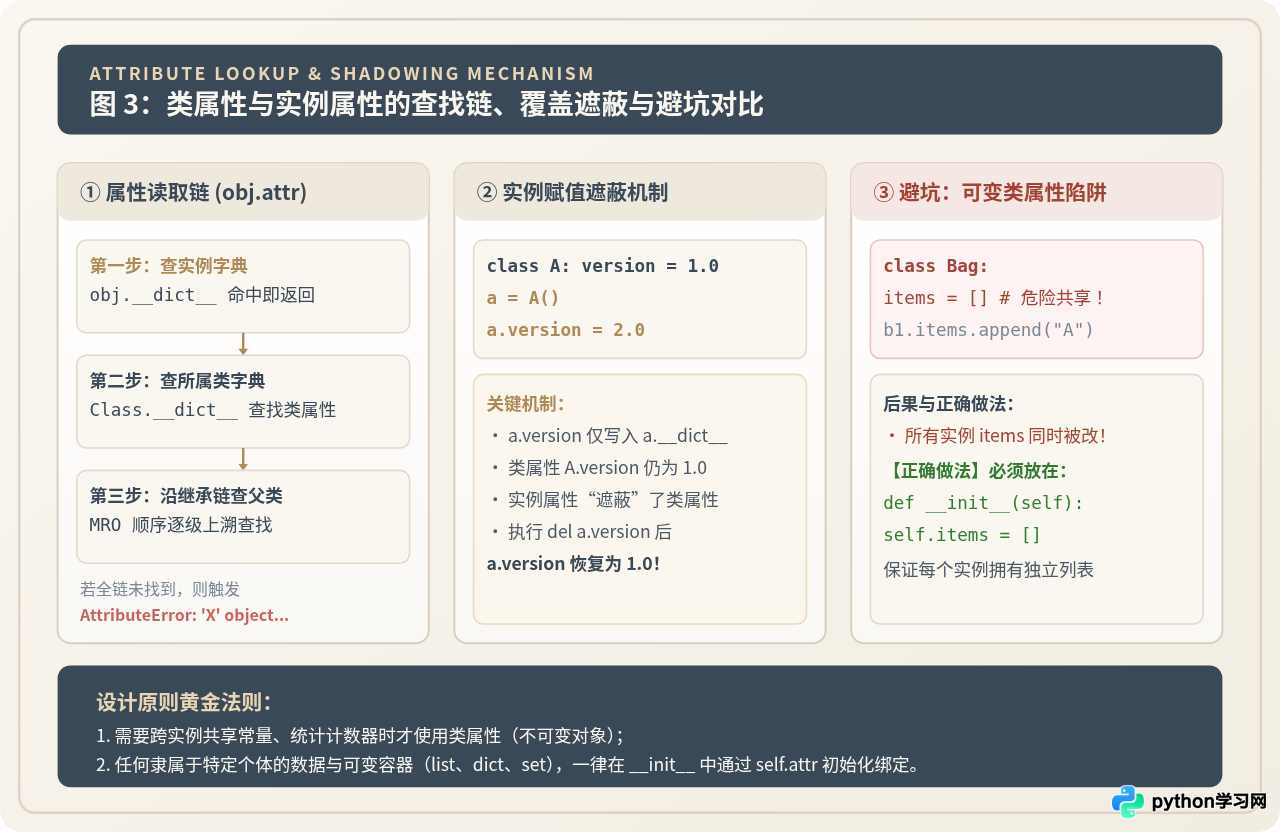
具体查找与遮蔽逻辑总结如下:
| 操作类型 | 代码表现 | 底层行为机制 | 影响范围 |
|---|---|---|---|
| 属性读取 | val = obj.attr |
首先在当前实例字典 obj.__dict__ 查找;若无,则向上查找所属类字典 Class.__dict__;若仍无,则沿继承链查找。 |
无副作用,安全读取。 |
| 实例属性赋值 | obj.attr = new_val |
仅作用于当前实例!将属性与值写入 obj.__dict__。即使 Class 存在同名类属性,类属性也不会被改变,而是被当前实例属性“遮蔽”。 |
仅影响当前单个实例对象,其他实例不受影响。 |
| 类属性显式修改 | Class.attr = new_val |
直接写入 Class.__dict__。 |
所有未遮蔽该属性的现有实例与新实例均会同步看到新值。 |
| 可变类属性陷阱 | obj.items.append(x) |
若 items = [] 声明在类层级,则读取到的是共享类列表,append 原地修改了同一块列表内存! |
所有实例被同时污染!绝对应当禁止,必须改在 __init__ 中初始化。 |
七、新手必防的高频报错与避坑清单
在编写类与实例化代码的过程中,初学者最常遭遇以下四种错误,建议对照排查:
()错误代码:user = User (此时 user 只是类对象 User 的别名引用,根本没有分配新内存,也没有执行 __init__)。
正确做法:必须书写括号并传递必要参数:user = User("Alice")。
self 参数错误表现:def get_data(): return 123。当通过实例 u.get_data() 调用时,解释器会自动传入实例作为第一参数,导致报错:TypeError: get_data() takes 0 positional arguments but 1 was given。
正确做法:普通实例方法首位参数必须为 self:def get_data(self): return 123。
__init__ 中错误编写 return 返回值错误表现:在 __init__ 末尾显式写了 return self 或 return "ok",将直接触发致命异常:TypeError: __init__() should return None, not '...'。
正确做法:__init__ 只负责就地给 self.attr 赋值,不需要编写任何 return 语句。
错误表现:在 class 下直接写 tags = []。由于列表在内存中是可变引用,当 user1.tags.append("管理员") 后,user2.tags 中也会不可思议地出现“管理员”。
正确做法:凡是属于每个个体独有的容器数据,一律在 __init__ 内通过 self.tags = [] 独立实例化。
八、总结与全景知识速查图谱
综上所述,Python 面向对象语法的核心可以高度凝练为四个支柱:用 class 定义结构规范、用 __init__ 承接实例初始化、用 self 建立个体上下文绑定、用带括号的类名调用完成实例化。
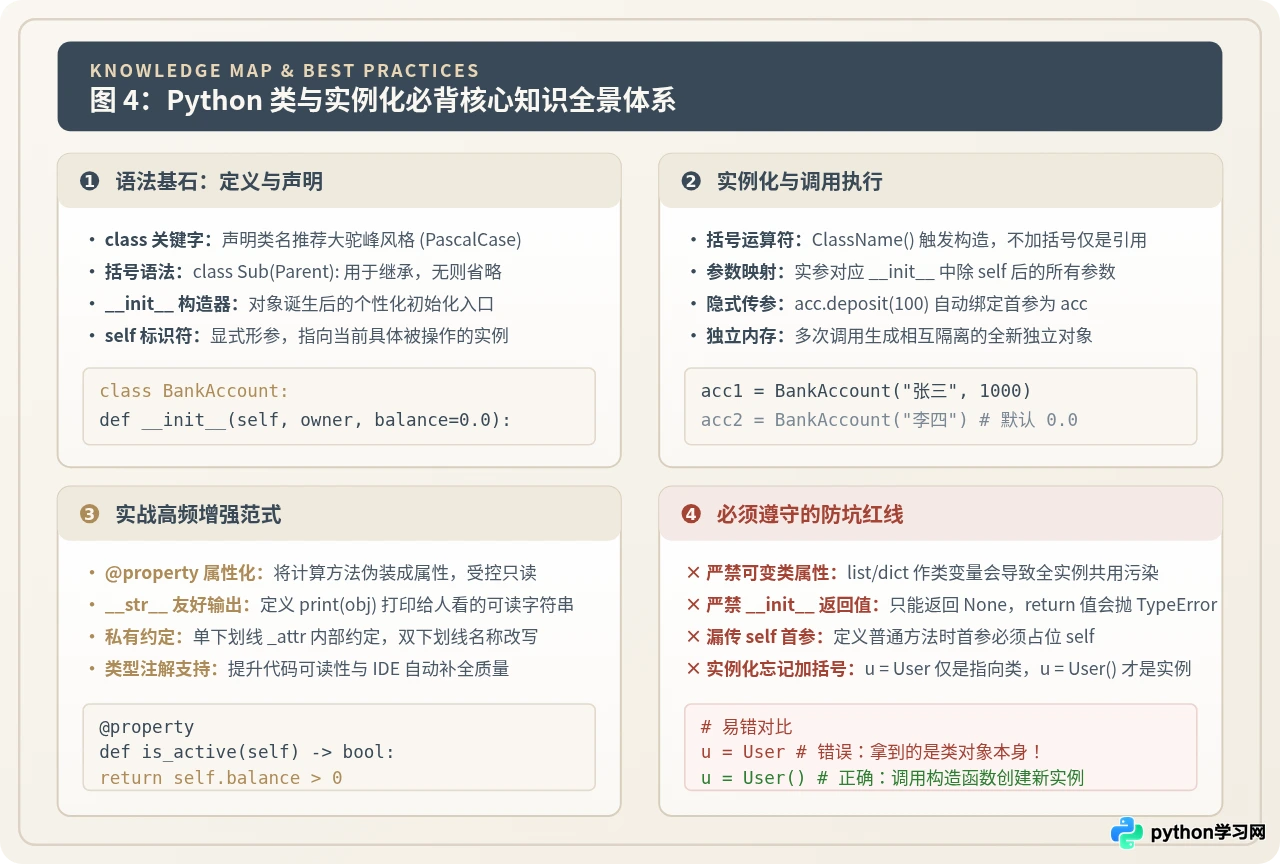
在日常编码时,建议时刻遵循“状态归实例、方法归类、常量做类属性、封装用 property”的黄金准则。通过掌握上述标准源代码模板与执行机制,即可规范自如地构建出健壮、清晰且符合工业标准的 Python 面向对象程序。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









