

python定义函数和普通代码块区别
全面解析Python中定义函数与普通代码块的本质区别,详细剖析执行时机、块级无作用域真相、内存栈帧与局部命名空间隔离,配合清晰流程图与实战重构对比。
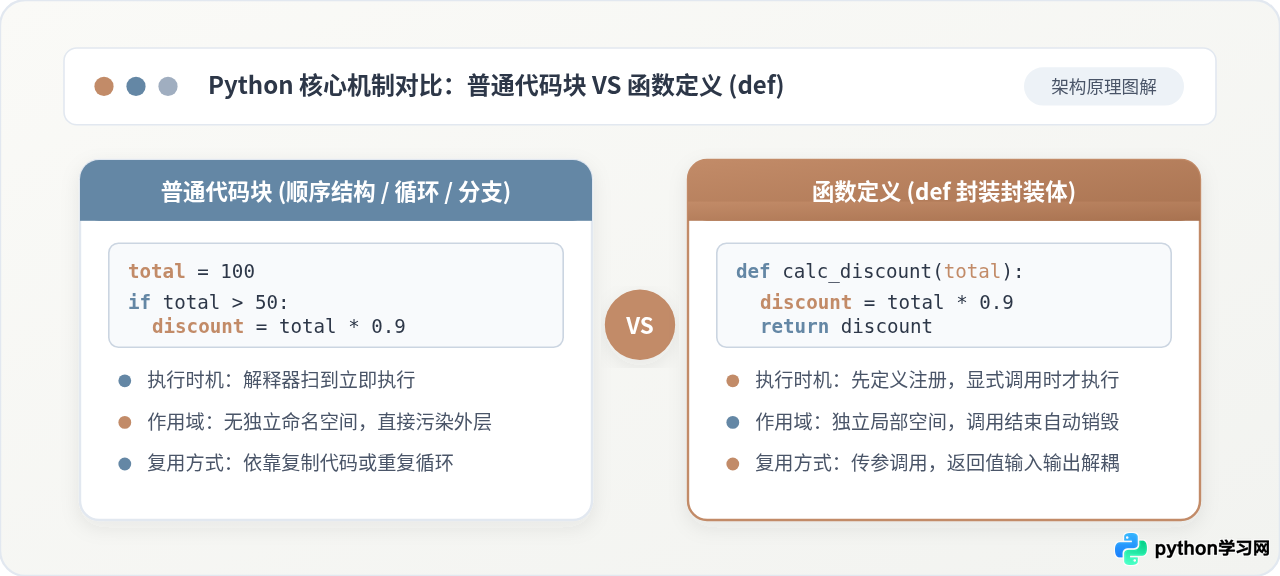
在 Python 编程中,普通代码块(如 if 分支、for/while 循环、with 上下文或平铺书写的连续语句)与函数定义(使用 def 语句声明的代码体)是构建程序的两种基本组织单元。初学者往往只把函数看作“给几行代码起个名字”,而忽视了 Python 运行机制在执行时机、内存栈帧以及作用域隔离上的根本差异。实际上,二者最关键的区别集中在两点:执行时机不同(即时执行 vs 声明待调),以及作用域与生命周期不同(无块级隔离 vs 独立局部栈帧)。理解这些差异,是写出整洁、无状态污染的高质量 Python 代码的基石。
一、执行时机与控制流机制差异
Python 解释器在读取脚本时采用逐行解释运行的模型。普通代码块与函数定义在遇到解释器扫描时,所触发的底层行为截然不同:
- 普通代码块(即时执行):当解释器行进到普通代码块所在的行时,会立刻计算条件表达式,并根据条件直接进入块内执行具体语句。执行完成后,控制流继续向下推进。这段逻辑无法被赋予独立标识,也无法在后续随意按需再次“激活”,除非外层显式包裹了循环语句。
- 函数定义(两阶段机制):当解释器遇到
def func_name():语句时,它执行的是一条声明语句。此时解释器会将函数内部的语句编译为一个代码对象(PyCodeObject),在当前命名空间中将该对象与名称func_name进行绑定,但绝不会执行函数内部的业务代码。只有当后续代码显式执行func_name()时,才会真正触发函数体。
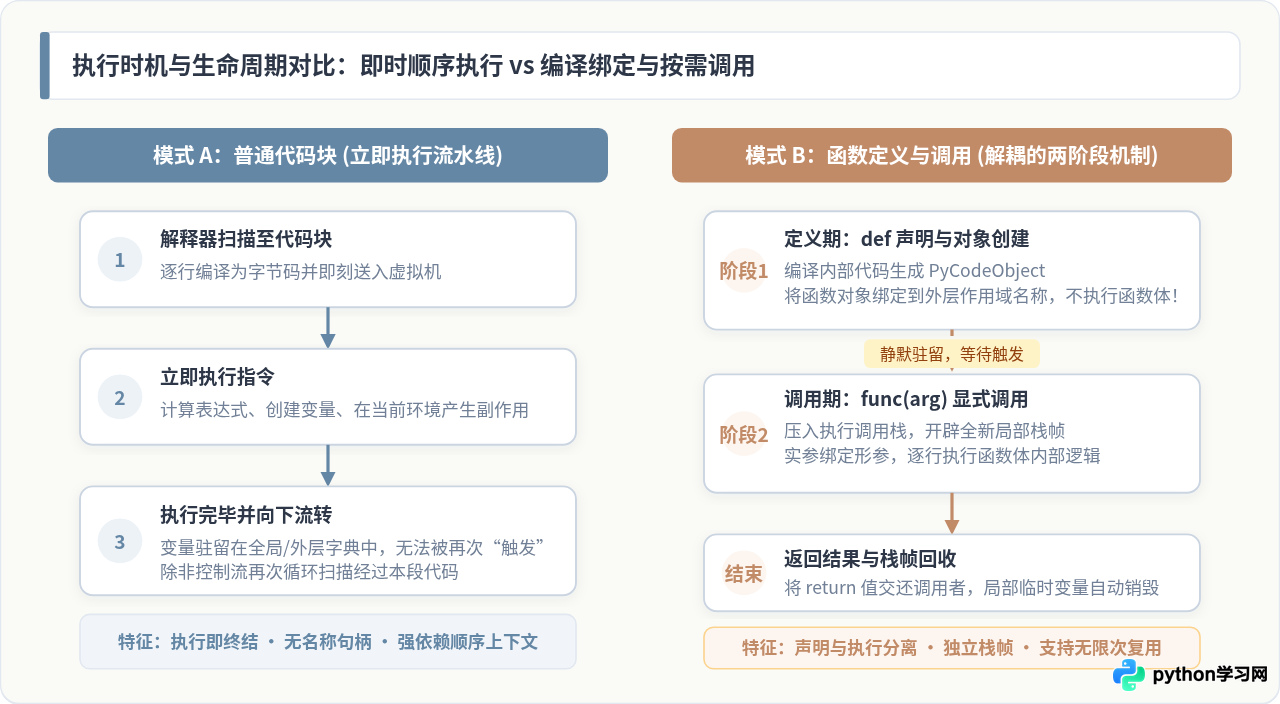
我们可以通过下面的简短代码直观观察这一时序差异:
# 场景 1:普通代码块在脚本加载时立刻执行
print("=== 准备进入 if 代码块 ===")
if True:
    print("【普通代码块执行中】这行日志在加载阶段立即打印")
print("=== if 代码块已结束 ===\n")

# 场景 2:函数定义在声明时不执行,仅在显式调用时才执行
print("=== 准备执行 def 声明语句 ===")
def greeting():
    print("【函数体执行中】只有调用我时,我才会输出!")
print("=== 函数定义已完成,此时内部并未运行 ===\n")

print(">>> 接下来显式触发调用:")
greeting()  # 此时才真正执行函数体
greeting() # 可以随意多次重复触发二、变量作用域与命名空间隔离
许多习惯了 C、C++ 或 Java 的开发者容易在 Python 的普通代码块上踩坑,原因在于:Python 并没有块级作用域(Block Scope)。在条件分支、循环或 with 块内部创建的变量,并不会被封闭在该代码块中,而是直接注入到外层的函数作用域或全局作用域中。
相比之下,函数在每次被调用时,Python 虚拟机都会在调用栈上为该次执行开辟一个专属的执行帧(PyFrameObject),并初始化一个独立的局部命名空间(Local Scope)。在该局部空间中创建的所有变量,对外层完全不可见,且在函数执行完毕返回后随栈帧销毁。
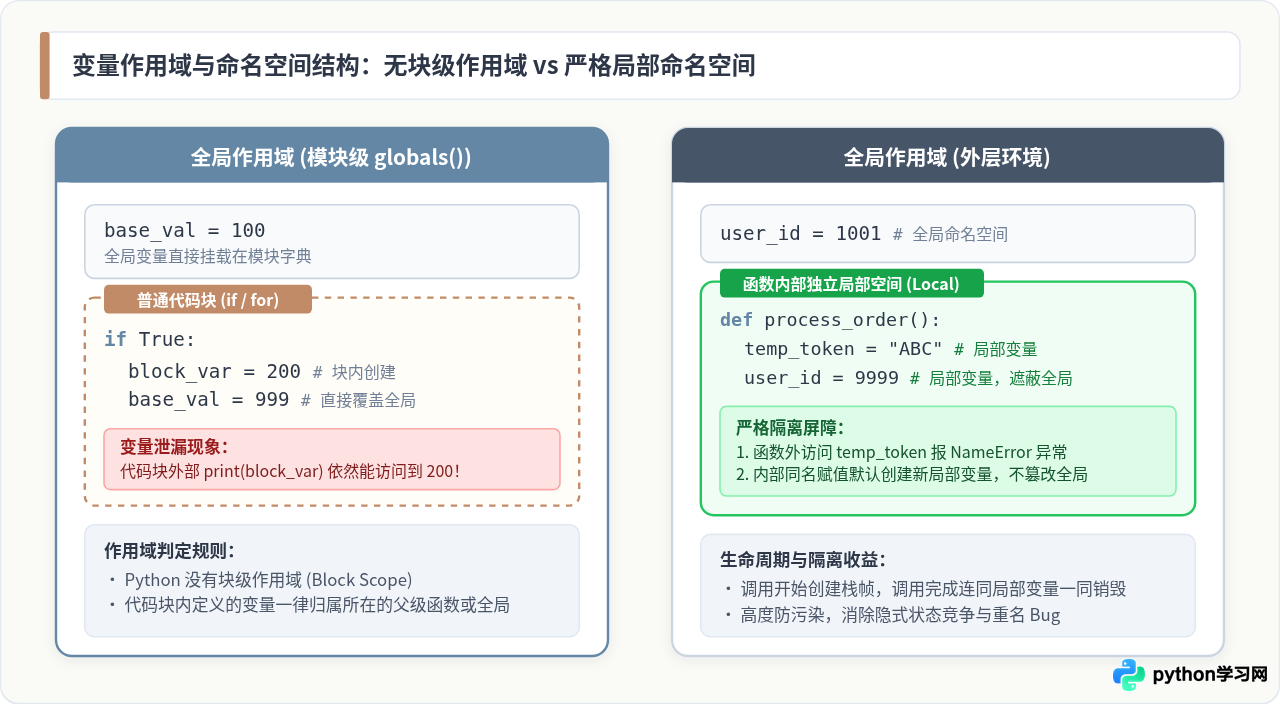
1. 普通代码块中的“变量泄漏”现象
观察以下 for 循环和 if 代码块,其内部定义的临时变量在块结束后依然在外部“阴魂不散”:
# 循环变量与分支变量泄漏到当前全局作用域
for i in range(3):
    status = "processing"

print("循环结束后依然能读取 i:", i)          # 输出: 2
print("代码块外部依然能读取 status:", status)  # 输出: processing

if True:
    temp_result = 999
print("if 外部依然能读取 temp_result:", temp_result)  # 输出: 999
这种设计意味着如果在一个长脚本中反复使用普通的临时代码块,变量名极易互相覆盖,造成难以排查的隐式状态竞争。
2. 函数的沙箱隔离与生命周期管理
当把逻辑收敛到函数内部时,变量的作用域被严格锁定在局部命名空间中:
def calculate_area(width, height):
    # 局部变量,存放在当前调用栈帧中
    inner_area = width * height
    return inner_area

result = calculate_area(10, 20)
print("计算结果:", result)  # 输出: 200

# 尝试访问函数内部变量将直接引发异常
try:
    print(inner_area)
except NameError as e:
print("外部无法访问局部变量:", e) # 输出: name 'inner_area' is not definedUnboundLocalError: local variable referenced before assignment。若确实需要修改全局变量,必须显式声明 global(或在嵌套函数中声明 nonlocal)。但在实际工程中,过度依赖全局修改属于反模式,应当优先使用参数与返回值进行数据流转。
三、参数输入、返回值与接口封装
代码组织的终极目的是降低认知负荷与提高复用性。普通代码块是“开放式”的,而函数是“契约式”的封装黑盒:
- 输入机制:普通代码块无法接收外部实参,它只能硬编码地引用上下文中的变量。如果要更换处理对象,必须显式修改外部变量的赋值,容易引发级联错误。而函数通过形参列表(支持位置参数、关键字参数、默认参数和
*args, **kwargs动态参数)建立了清晰的输入契约。 - 输出机制:普通代码块内部禁止使用
return语句(在函数外部使用 return 会直接导致SyntaxError: 'return' outside function),其产出只能通过副作用直接写入外部变量。而函数通过return返回明确的计算产物,未写 return 时隐式返回None。 - 独立测试:由于普通代码块深度依赖外部状态,无法对其进行隔离的单元测试;而纯函数只依赖输入参数产生返回值,可以随时针对各种边界值编写自动化测试用例。
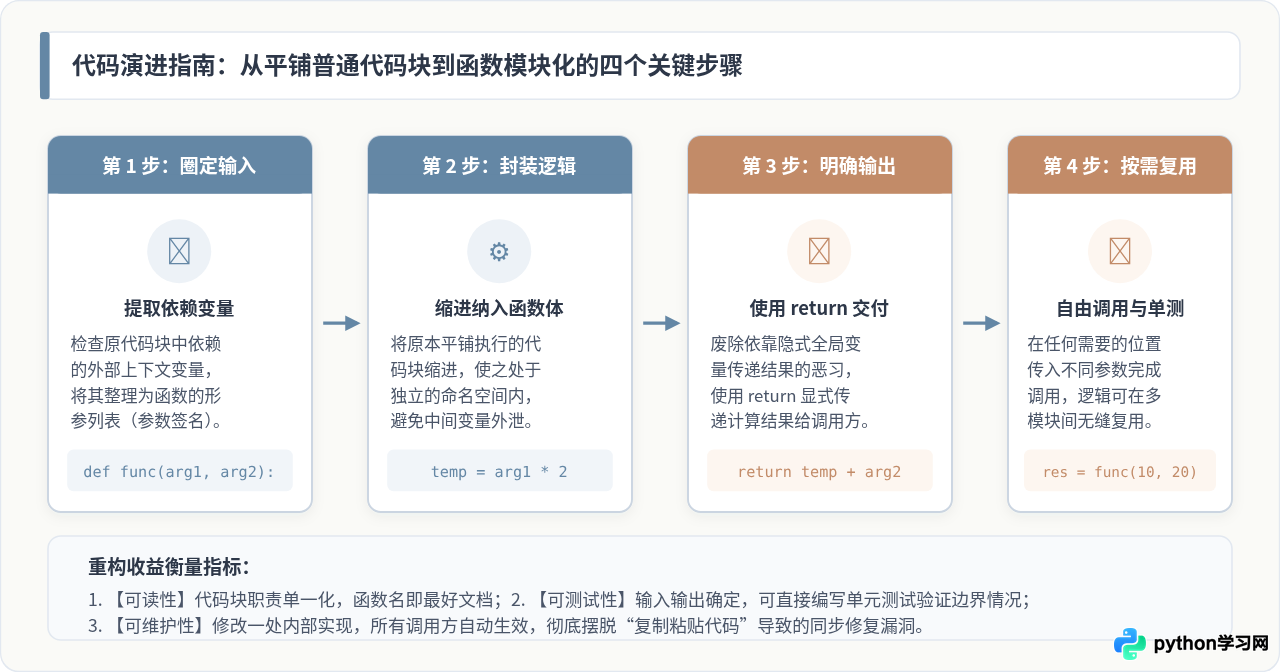
以下展示了从一段充斥着硬编码与全局副作用的普通代码块,向规范函数封装演进的对比示例:
# === 重构前:平铺普通代码块 ===
# 缺点:依赖全局硬编码、难以复用、修改商品需反复修改代码
order_price = 300
user_level = "VIP"

if user_level == "VIP":
    final_price = order_price * 0.8
else:
    final_price = order_price * 0.95
print("普通块计算结果:", final_price)

# === 重构后:标准化函数封装 ===
# 优点:无外部依赖、输入输出明确、支持无限次复用与单元测试
def calculate_order_price(price: float, level: str = "NORMAL") -> float:
    """根据用户等级计算订单折后总价"""
    if price <= 0:
        return 0.0
    discount_ratio = 0.8 if level.upper() == "VIP" else 0.95
    return round(price * discount_ratio, 2)

# 在任意业务场景中清晰调用
vip_total = calculate_order_price(300, "VIP")
normal_total = calculate_order_price(300, "NORMAL")
print(f"函数复用调用:VIP支付 {vip_total} 元,普通用户支付 {normal_total} 元")
四、全维度特性对比总结
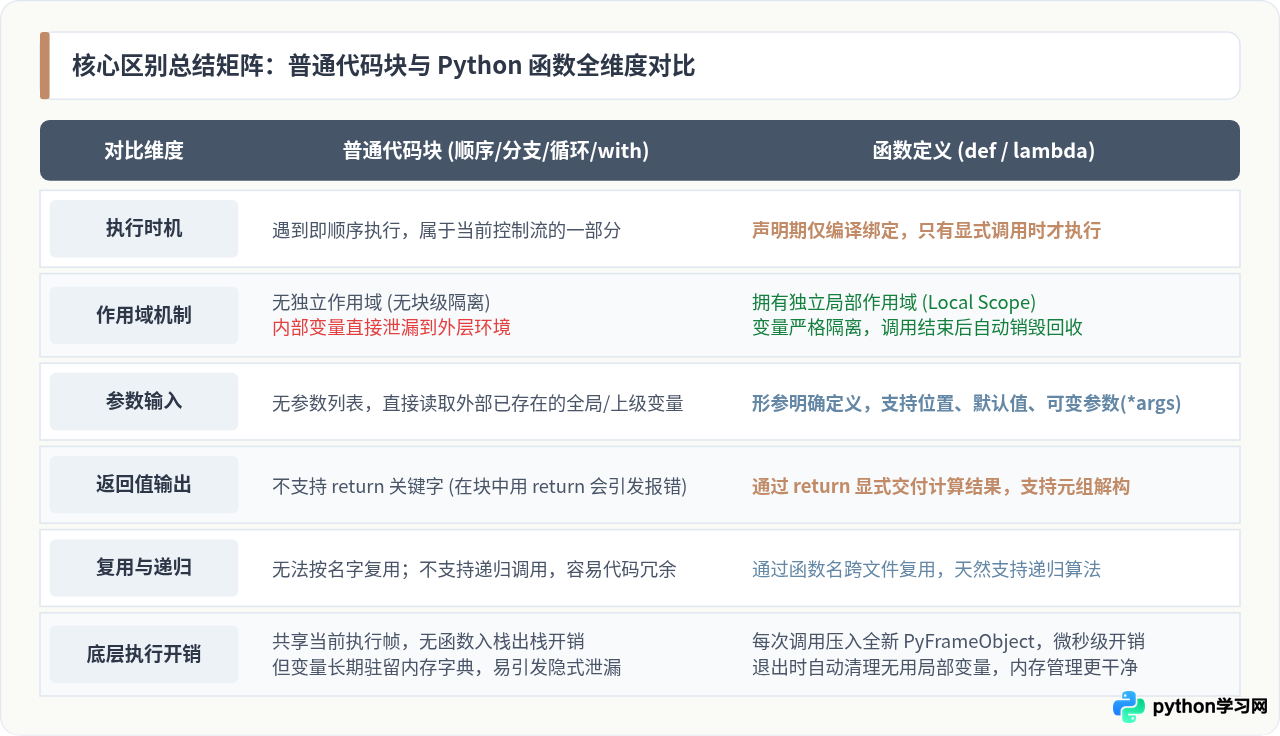
综合以上各层面的剖析,普通代码块与 Python 函数的核心差异可归纳为下表所示的六大维度:
五、选型判断与工程实践建议
在日常开发中,究竟何时使用普通代码块,何时应当提取为函数?可以参考以下三条实践准则:
- 当逻辑仅作为单次控制流分支时:如果一段逻辑仅仅是处理单次条件筛选(如只在特定配置下初始化一个本地对象)或者资源托管(如简单的
with open(...) as f:),且总长度在数行以内、不需要被再次调用,使用普通代码块最为轻量自然。 - 当逻辑在多处重复出现或行数超过单个视野时:一旦发现同一套公式、校验规则或格式化逻辑在两处以上出现,必须坚决抽离为函数,杜绝复制粘贴。即使只调用一次,只要逻辑具有完整的语义(如数据清洗、订单计费、权限校验),将其封装为命名清晰的独立函数也能显著提升主流程的可读性。
- 关注变量生命周期与内存回收:如果要在循环中处理大型数据集(如大型列表、图像数据),在普通代码块中定义的临时变量会一直驻留在外层字典中直到脚本结束。将其放入函数内部执行,可以在每次调用结束时自动释放栈帧中的大型对象,有效避免内存占用居高不下。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









