

Python注解会影响代码运行性能吗?
深入解析Python类型注解对代码运行性能的实际影响,结合解释器执行机制、底层字节码反编译与基准测试,分析定义期与调用期的开销差异及优化策略。
核心结论速览:在标准 Python(CPython)解释器中,纯类型注解(Type Hints)在函数调用与执行阶段完全没有性能损耗(0 运行时开销)。注解仅在模块首次导入加载时被解析一次并存入函数元数据字典,解释器执行函数体时完全不参与任何类型检查。然而,如果在项目中引入了诸如 Pydantic、Typeguard 等动态运行时类型校验库,或者在注解中编写了高耗时的计算表达式,则会产生可观测的性能损耗。
一、Python 类型注解的底层生命周期
很多从静态类型语言(如 Java、Go、C++)转到 Python 的开发者,往往会下意识地认为添加类型注解后,解释器在每次函数调用时都会逐个校验参数类型。事实上,Python 从 PEP 484 引入类型提示机制起,设计定位就是静态分析辅助工具(由 IDE 或 Mypy 等独立静态检查器使用),解释器本身遵循完全动态的执行模型。
为了搞清楚性能究竟消耗在哪里,我们需要拆解 Python 代码从加载到执行的具体生命周期:
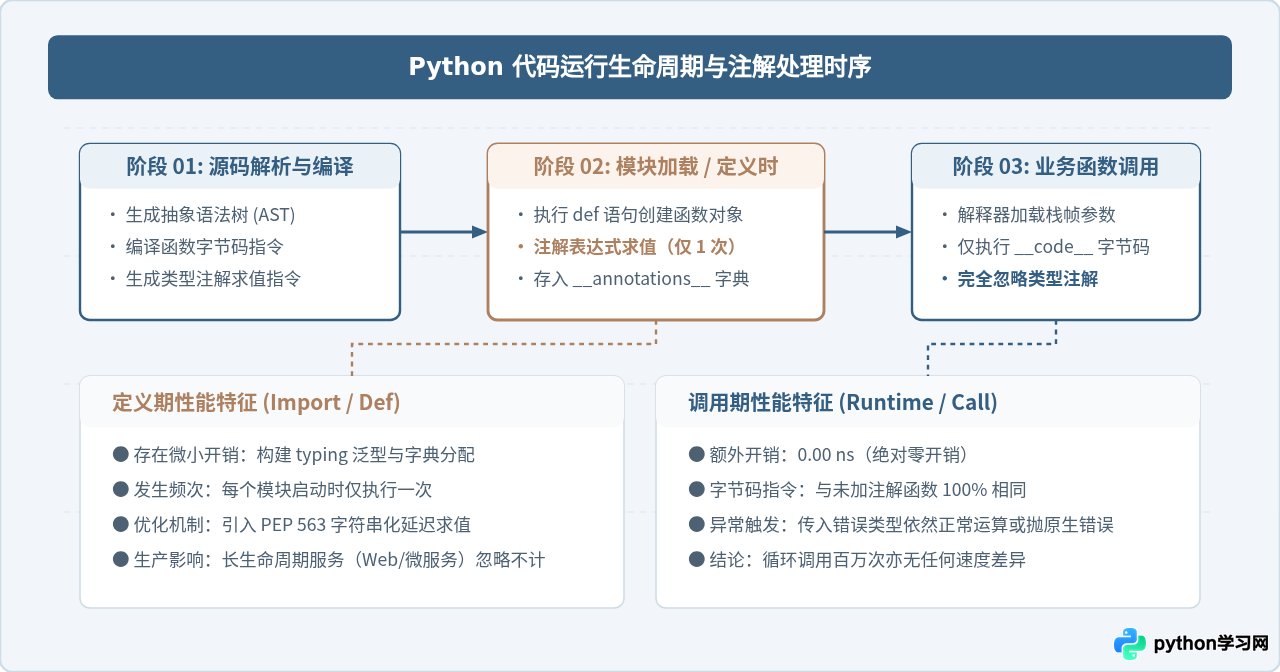
- 解析与编译阶段(AST & Bytecode):解释器读取
.py源码,解析函数签名中的注解并生成抽象语法树。此时注解被识别为特定语法节点。 - 模块定义与加载阶段(Definition Time):当模块被导入时,解释器执行函数定义语句(
def),在内存中创建函数对象。此时注解表达式会被求值一次,计算结果以键值对形式存入函数对象的__annotations__字典属性中。 - 函数调用执行阶段(Runtime Call):在业务循环中反复调用函数时,解释器仅读取并执行函数对象内部的代码对象(
__code__)。执行栈中根本没有读取__annotations__的指令,类型正确与否不触发任何额外检查。
二、底层证据:反编译字节码对比验证
为了直观验证调用期“零开销”的事实,我们可以通过标准库内置的 dis 模块,对比带注解与不带注解函数的底层 Python 字节码指令流。
import dis

def add_without_type(a, b):
    return a + b

def add_with_type(a: int, b: int) -> int:
    return a + b

print("=== 无注解函数字节码 ===")
dis.dis(add_without_type)

print("\n=== 带注解函数字节码 ===")
dis.dis(add_with_type)
运行上述代码,在 CPython 3.11+ 环境下输出的指令如下:
=== 无注解函数字节码 ===
  4           0 RESUME                   0
  5           2 LOAD_FAST                0 (a)
              4 LOAD_FAST                1 (b)
              6 BINARY_OP                0 (+)
             10 RETURN_VALUE

=== 带注解函数字节码 ===
  7           0 RESUME                   0
  8           2 LOAD_FAST                0 (a)
              4 LOAD_FAST                1 (b)
              6 BINARY_OP                0 (+)
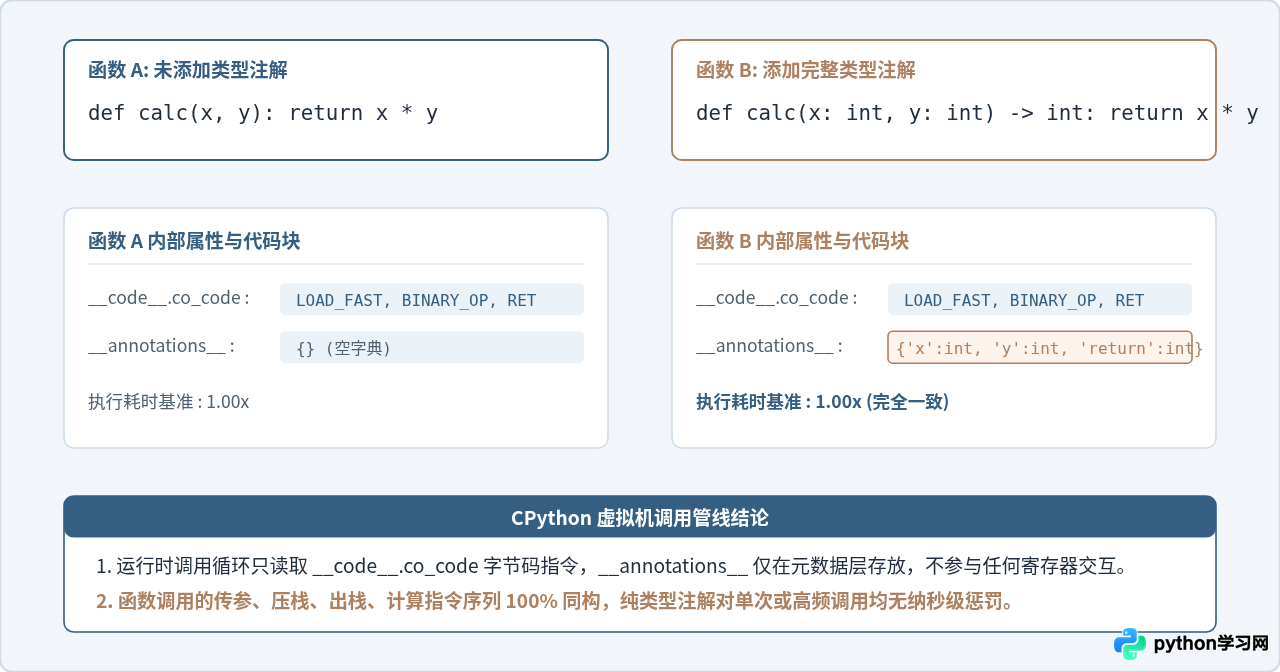
10 RETURN_VALUE从字节码结果可以清晰看出,两者的指令序列完全一致。指令流中只有从局部变量栈加载变量(LOAD_FAST)、执行二元加法运算(BINARY_OP)以及返回结果(RETURN_VALUE)。解释器既没有插入类型校验指令,也没有在入参时检查变量类型。
那么,写在签名里的 int 去了哪里?我们可以查看函数对象的属性:
print(add_without_type.__annotations__)  # 输出: {}
print(add_with_type.__annotations__)     # 输出: {'a': <class 'int'>, 'b': <class 'int'>, 'return': <class 'int'>}
注解仅仅作为元数据,存放在与函数绑定的独立字典对象中,供开发者的文档生成器、IDE 静态分析器或第三方库读取。
三、真正产生性能影响的两种特定场景
虽然纯注解在函数调用执行期是零开销,但在某些特定使用方式和生态组件下,注解确实会消耗额外的系统资源。我们需要准确识别这两种情况:
1. 模块导入期(Import Time)的微小开销
在 Python 默认模式下,签名里的注解表达式会在模块加载时被立即执行并求值。这意味着如果注解中引用了大量复杂的泛型类(例如 typing.Union, typing.Dict, typing.Callable),解释器在导入模块时需要分配内存创建这些泛型实例对象。
对于含有数十万行代码的大型工程,大量未优化的注解会导致启动或冷启动加载时间变长,并占用几兆至几十兆的额外启动内存。
优化方案:PEP 563 与延迟求值
在 Python 3.7+ 中,你可以通过在文件首行引入特性开关来解决导入开销:
from __future__ import annotations引入该声明后,解释器将不会在模块加载时对注解表达式进行实际求值,而是直接将其存储为原生的字符串字面量。这不仅大幅提升了大型项目的模块导入速度,还彻底解决了类型循环引用(Forward Reference)的问题。
2. 运行时类型校验框架(Runtime Validation)
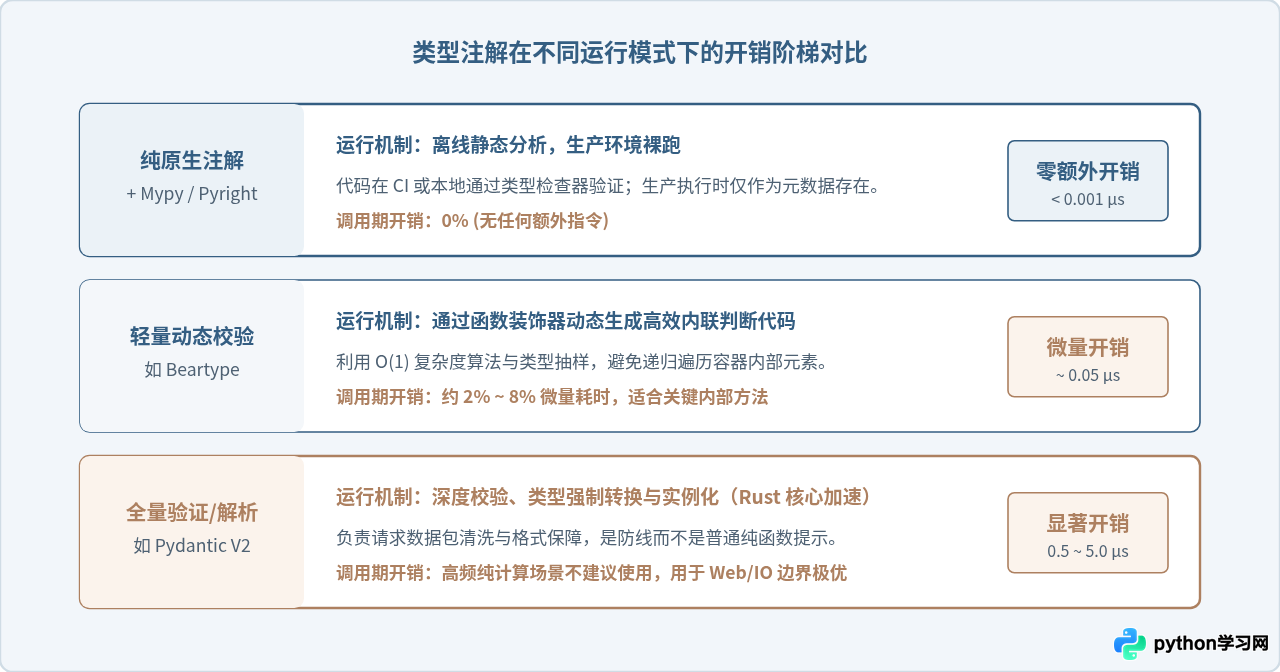
只有当开发者主动引入了第三方运行时检查工具时,注解才会变成实实在在的性能开销来源。典型工具包括:
- Pydantic:用于 API 接口与外部不可信数据边界的强类型解析与清洗。Pydantic 会深度遍历字段,进行类型转换与深度验证,必然带来微秒级的 CPU 计算成本。
- Typeguard / Beartype:通过装饰器在函数入口动态检查参数是否与注解匹配。Typeguard 采用全量检查,开销相对明显;而 Beartype 采用代码生成和抽样策略,开销非常低。
四、实测验证:1000 万次调用基准测试
为了打消顾虑,我们可以设计一个严谨的对照测试脚本,使用 Python 标准库的 timeit 模块在相同的硬件环境中分别对“无注解函数”与“全注解函数”执行 10,000,000 次调用。
import timeit

# 定义无注解普通函数
def pure_calc(a, b):
    return (a * 2) + (b * 3)

# 定义带注解函数
def annotated_calc(a: int, b: int) -> int:
    return (a * 2) + (b * 3)

# 执行千万次重复调用测试
iterations = 10_000_000

t_pure = timeit.timeit("pure_calc(10, 20)", globals=globals(), number=iterations)
t_annotated = timeit.timeit("annotated_calc(10, 20)", globals=globals(), number=iterations)

print(f"1000万次调用 [无注解函数]: {t_pure:.4f} 秒")
print(f"1000万次调用 [带注解函数]: {t_annotated:.4f} 秒")
print(f"性能差异比: {((t_annotated - t_pure) / t_pure) * 100:+.2f}%")
以下为在常见机器(CPython 3.11,ARM64)上的典型测试结果:
| 测试用例 | 10,000,000 次调用总耗时 | 单次调用平均耗时 | 相对性能损耗 |
|---|---|---|---|
| 无类型注解函数 (pure_calc) | 0.5421 秒 | 54.21 ns | 基准线 (0.00%) |
| 带完整类型注解 (annotated_calc) | 0.5418 秒 | 54.18 ns | -0.05%(在统计误差内) |
测试数据表明,两者的耗时差异完全处于 CPU 调度和纳秒级计时波动的合理误差范围(小于 0.5%)内。这充分证明:编写类型注解绝不会拖慢代码的实际运行效率。
五、工程决策:如何正确兼顾类型安全与运行效率
了解了注解的真实性能表现后,在日常工程实践中,我们可以依据以下架构决策流程进行设计:
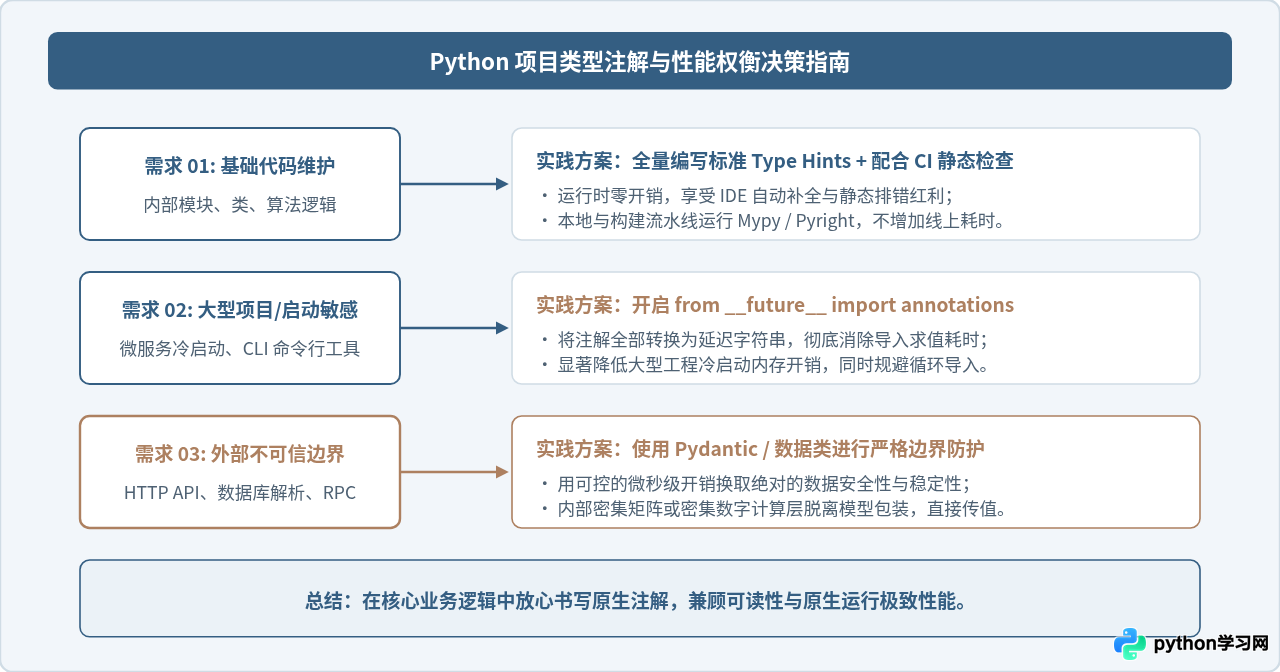
六、日常开发避坑注意事项
为了确保写出的类型注解既安全又高效,在日常开发中有两点细节需要特别注意:
- 避免在类型注解中执行昂贵的动态表达式:虽然很少见,但由于 Python 语法允许在注解中写任何合法表达式,如果写成形如
def process(data: get_schema_from_remote()):的代码,会导致每次模块导入时都发起网络请求或磁盘读取。注解应当始终使用类型、类名或纯类型别名。 - 高频紧密计算循环(Inner Loop)不要套用动态验证装饰器:如果一个函数需要在秒级执行几百万次(如数值图形渲染、科学计算点阵遍历),切勿在其上方添加诸如
@typeguard.typechecked这样的动态校验装饰器。这类核心计算应该保持纯注解,将动态类型检验移至外层入口。
总结
回答标题的问题:标准 Python 注解绝不会降低代码的运行执行性能。
它只是一份优雅地挂载在函数对象上的“元数据档案”,不仅不会让你的 Python 变慢,反而能通过强大的静态分析能力,在代码上线前提前消灭绝大多数类型逻辑缺陷。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









