

Python在人工智能领域有哪些具体工作岗位?
全面梳理Python在人工智能领域的具体工作岗位划分,涵盖机器学习工程师、深度学习算法工程师、大语言模型应用工程师、MLOps工程化工程师及数据挖掘工程师的核心职责、Python技术栈与职业技能路径。
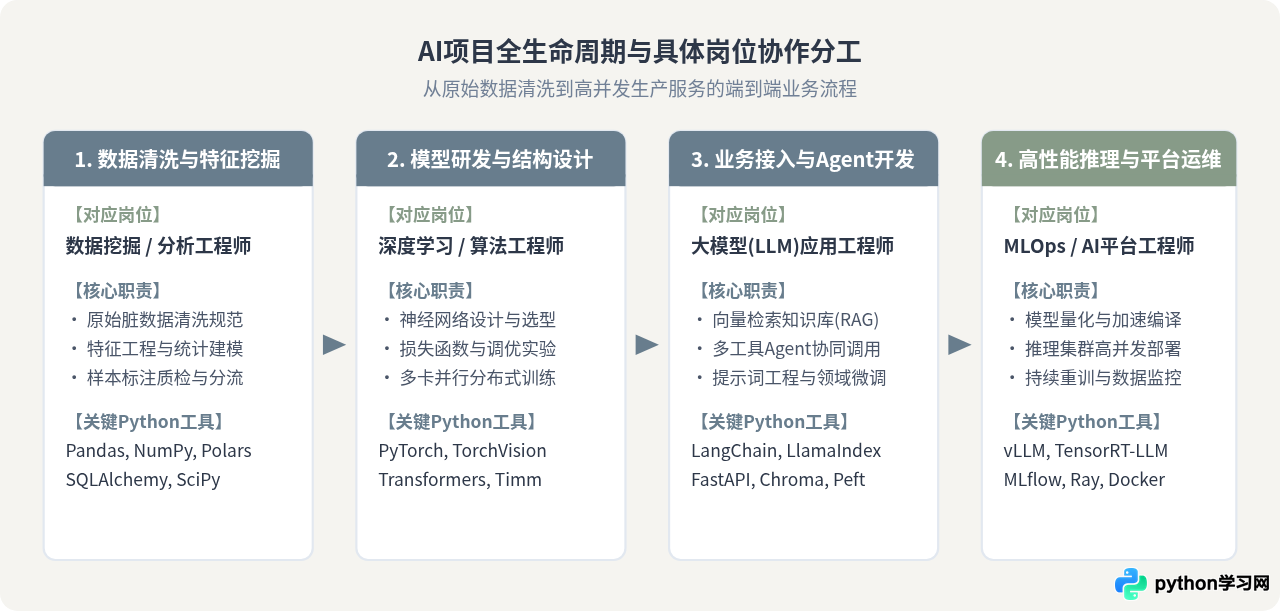
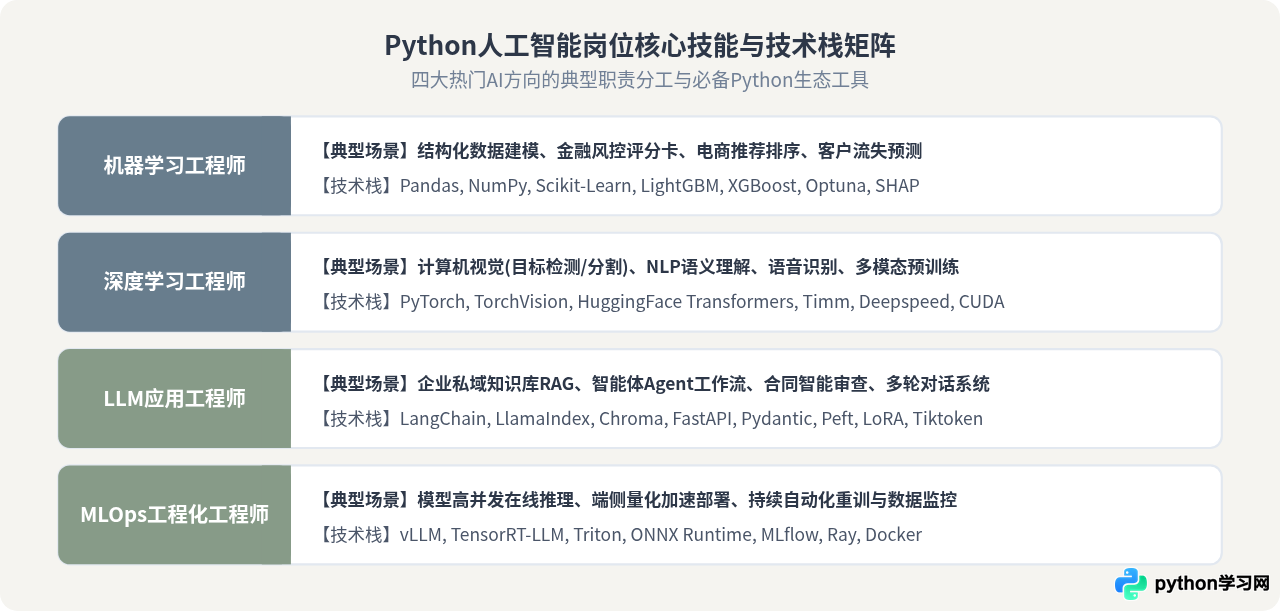
在人工智能项目的实际研发与商业落地中,Python凭借丰富的科学计算库、深度学习框架以及活跃的开源生态,贯穿了从数据加工到线上推理的全流程。围绕“数据供给—模型研发—业务应用—工程落地”的完整协作链路,Python在人工智能领域主要形成了五类具体工作岗位:机器学习工程师、深度学习与算法研究工程师、大语言模型(LLM)应用工程师、MLOps与AI平台工程化工程师,以及数据分析与数据挖掘工程师。每个岗位对应的技术侧重点、代码形态与交付标准均有明确分界。
一、机器学习工程师(Machine Learning Engineer)
机器学习工程师主要面向结构化表格数据、时间序列或业务行为日志,运用统计学与机器学习算法解决业务预测、风险控制和智能推荐等问题。该岗位不盲目堆叠复杂神经网络,而是更加侧重于特征工程的设计与算法的可解释性。
1. 核心职责
- 特征工程构建:深入理解业务逻辑,从数亿条原始行为日志中提取、组合高区分度的特征因子,处理缺失值、异常值以及多重共线性问题。
- 模型选型与训练:基于业务目标选用线性模型、集成树模型(GBDT家族)或轻量级神经网络,并完成交叉验证与超参数优化。
- 离线评估与可解释性分析:利用混淆矩阵、ROC-AUC、KS值、SHAP值等指标,向业务方清晰解释模型预测依据及潜在风险。
2. 核心Python技术栈
- 数据清洗与计算:
numpy、pandas、polars。 - 经典算法与建模:
scikit-learn、xgboost、lightgbm、catboost。 - 自动化调参与可解释性:
optuna、shap、lime。
3. 典型代码与工作流示例
import pandas as pd
from lightgbm import LGBMClassifier
from sklearn.model_selection import train_test_split
from sklearn.metrics import roc_auc_score

# 1. 结构化特征加载与划分
data = pd.read_parquet("user_behavior_features.parquet")
X = data.drop(columns=["is_churn", "user_id"])
y = data["is_churn"]
X_train, X_val, y_train, y_val = train_test_split(X, y, test_size=0.2, random_state=42)

# 2. 集成树模型训练
model = LGBMClassifier(n_estimators=300, learning_rate=0.03, max_depth=6, random_state=42)
model.fit(X_train, y_train, eval_set=[(X_val, y_val)])

# 3. 业务指标验证
val_preds = model.predict_proba(X_val)[:, 1]
print(f"验证集 ROC-AUC 得分: {roc_auc_score(y_val, val_preds):.4f}")
二、深度学习与算法研究工程师(Deep Learning / Algorithm Engineer)
深度学习与算法研究工程师主要处理图像、视频、语音和文本等非结构化数据。岗位职责通常进一步划分为计算机视觉(CV)工程师、自然语言处理(NLP)工程师及语音算法工程师。该岗位需要深厚的数学推导功底与GPU异构计算知识。
1. 核心职责
- 模型结构设计与定制:根据目标检测、语义分割或多模态理解需求,设计专门的神经网络骨干(Backbone)或自定义注意力层与损失函数。
- 大规模分布式训练:编写多机多卡训练脚本,处理显存优化、梯度同步、混合精度训练(AMP)等性能瓶颈。
- 前沿论文复现与微调:跟踪ArXiv最新论文,将开源前沿架构在特定行业数据集上完成复现、微调与知识蒸馏。
2. 核心Python技术栈
- 深度学习主框架:
torch(PyTorch)、torchvision、torchaudio。 - 预训练与开源模型库:
transformers(Hugging Face生态)、timm、accelerate。 - 并行计算与底层交互:
deepspeed、triton、PyTorch C++扩展。
三、大语言模型(LLM)与生成式AI应用工程师
随着生成式人工智能的发展,大语言模型应用工程师成为当前招聘需求增长极为迅速的方向。该岗位不同于动辄耗费数千万元训练底座模型的团队,而是定位于“将现有前沿开源或闭源大模型与企业业务场景无缝连接”。
1. 核心职责
- 企业级RAG(检索增强生成)系统搭建:对企业私域文档(PDF、Word、数据库)进行分块、嵌入向量化(Embedding),并结合重排序(Reranker)与混合检索算法,消除大模型幻觉。
- 智能体(AI Agent)工作流开发:使用Python编排复杂的Agent逻辑,赋予大语言模型调用外部API、执行SQL查询、读写本地文件的自主决策能力。
- 模型轻量化微调(Fine-Tuning):针对行业特定术语与输出格式,采用LoRA、QLoRA等参数高效微调技术(PEFT),用最低算力代价调整模型表现。
2. 核心Python技术栈
- 应用编排与框架:
langchain、langgraph、llamaindex。 - 向量存储与检索:
chromadb、faiss-cpu/faiss-gpu、pymilvus。 - 微调工具库:
peft、trl、bitsandbytes。 - 后端接口开发:
fastapi、pydantic、uvicorn。
3. 典型应用示例:基于FastAPI构建RAG检索端点
from fastapi import FastAPI, HTTPException
from pydantic import BaseModel
import chromadb

app = FastAPI(title="企业私域知识库检索服务")
client = chromadb.PersistentClient(path="./chroma_db")
collection = client.get_or_create_collection(name="internal_docs")

class QueryRequest(BaseModel):
    query_text: str
    top_k: int = 3

@app.post("/api/retrieve")
async def retrieve_knowledge(req: QueryRequest):
    try:
        results = collection.query(
            query_texts=[req.query_text],
            n_results=req.top_k
        )
        return {"documents": results["documents"][0], "metadatas": results["metadatas"][0]}
    except Exception as e:
        raise HTTPException(status_code=500, detail=str(e))
四、MLOps与AI平台工程化工程师
在工业界,很多模型在离线评测中效果突出,但在上线部署时却因显存超限、延迟过高或并发请求堵塞而无法商用。MLOps(Machine Learning Operations)与AI平台工程师的核心目标,就是打通模型从“实验构想”到“高可用工业级服务”的必经之路。
1. 核心职责
- 模型压缩与高性能推理部署:对模型执行INT8/FP8量化、剪枝与算子融合,使用专有推理引擎提升吞吐量并压低首字响应延迟(TTFT)。
- 机器学习流水线自动化(CI/CD for ML):构建从数据拉取、自动重训、模型评测到金丝雀发布的自动化工作流。
- 运行时监控与防衰减:监控线上推理服务的QPS、GPU显存、P99耗时,并捕获线上输入数据的分布漂移(Data Drift)。
2. 核心Python技术栈
- 高性能推理与量化:
vllm、tensorrt-llm、onnxruntime、tritonclient。 - 生命周期与实验管理:
mlflow、dvc、wandb。 - 分布式任务编排:
ray、celery。 - 基础设施交互:
docker(Python SDK)、kubernetes(官方客户端)。
五、深度对照:算法研究工程师 vs MLOps工程化工程师
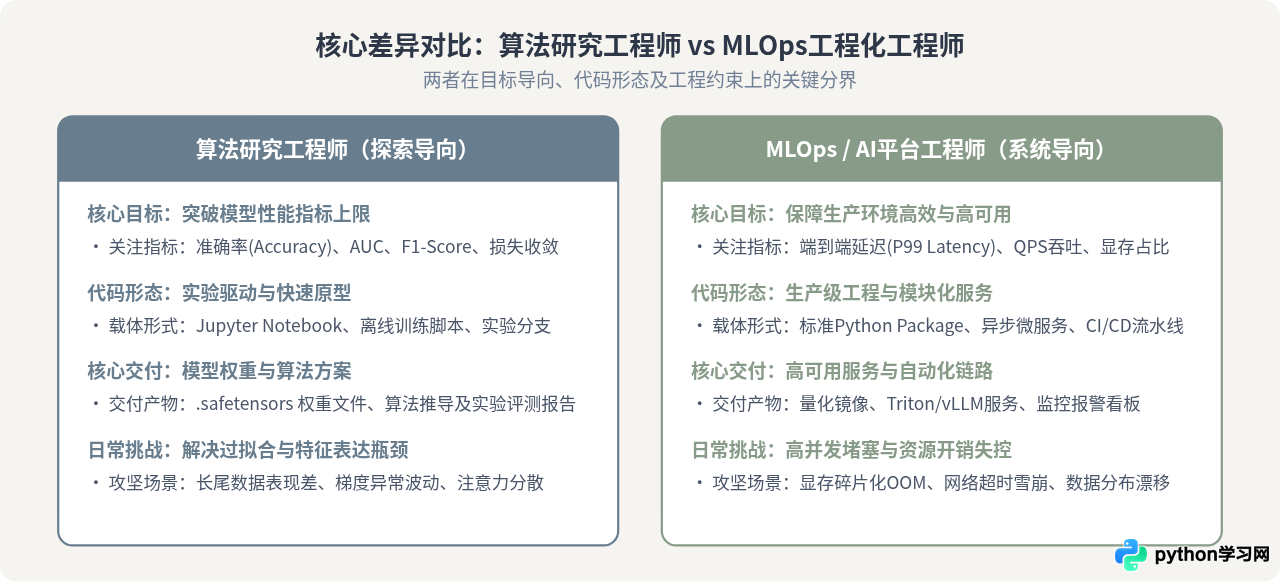
许多初学者或转岗人员容易将算法工程师与MLOps工程师混为一谈。两者虽然都在日常工作中使用Python,但在目标导向、代码形态以及系统约束上存在本质差异。在一致的生产落地前提下,这两者的关键差异如下:
| 比较维度 | 算法研究工程师(探索导向) | MLOps工程化工程师(系统导向) |
|---|---|---|
| 核心考核指标 | 准确率(Accuracy)、F1-Score、损失函数收敛、模型泛化能力 | 端到端延迟(P99 Latency)、并发吞吐量(QPS)、显存利用率、服务SLA可用性(99.99%) |
| 代码形态与载体 | Jupyter Notebook、多分支训练脚本、频繁改动的实验代码 | 高内聚低耦合的Python模块、异步API微服务、Docker容器镜像、CI/CD编排脚本 |
| 日常核心瓶颈 | 模型过拟合、数据表征不足、梯度消失或梯度爆炸 | 显存碎片化与OOM(Out Of Memory)、并发网络IO堵塞、线上线下特征不一致 |
| 最终交付物 | 模型权重文件(如 .safetensors)与算法实验报告 |
高可用推理服务集群、自动化打包流水线、稳定性监控告警看板 |
为什么明确两者的分界至关重要?在项目初期,若强求算法研究人员兼顾复杂的服务高并发调优,往往会导致精力分散;而若缺乏MLOps团队的工程支撑,最优秀的算法模型也只能停留在实验报告中,无法产生实际业务价值。
六、数据分析与数据挖掘工程师(Data Analyst / Data Mining Engineer)
任何人工智能系统的上限都受限于训练数据的质量。数据分析与数据挖掘工程师是AI链路的基石,主要负责从海量数据中清洗脏数据、挖掘高价值特征关联,并形成标准化的数据集规范。
1. 核心职责
- 大规模数据清洗与转换:使用Python从数据湖或数据仓库抽取PB级原始日志,编写高效的数据转换流水线。
- 探索性数据分析(EDA):通过统计检验与分布可视化,识别业务指标背后的异常点、趋势模式与周期性规律。
- 高质量样本集沉淀:负责监督学习训练集与大模型SFT(指令微调)语料的清洗、去重与质量过滤。
2. 核心Python技术栈
- 数据操作与加速:
pandas、polars、numpy、pyarrow。 - 统计检验与可视化:
scipy、statsmodels、matplotlib、seaborn。 - 分布式数据处理:
pyspark、dask。
七、如何根据个人背景规划Python AI求职路径
面对多元化的AI工作岗位,学习者与从业者应当根据自身的学术和工程背景进行针对性匹配:
- 计算机科学与软件工程背景:最契合LLM应用开发或MLOps平台工程。由于具备良好的数据结构、网络编程与Linux系统运维基础,能够迅速将模型封装为高吞吐、高可用的工业级服务。
- 数学、统计学与金融量化背景:最契合传统机器学习工程师或数据挖掘工程师。对概率论、假设检验、矩阵分解的敏感度,有助于构建出解释性强、鲁棒性高的业务特征与集成树模型。
- 人工智能与模式识别等科研硕博背景:最契合深度学习与算法研究工程师。具备深厚的多模态理解能力,能够紧跟学术前沿,针对前沿难题设计定制化网络架构。
八、总结与求职建议
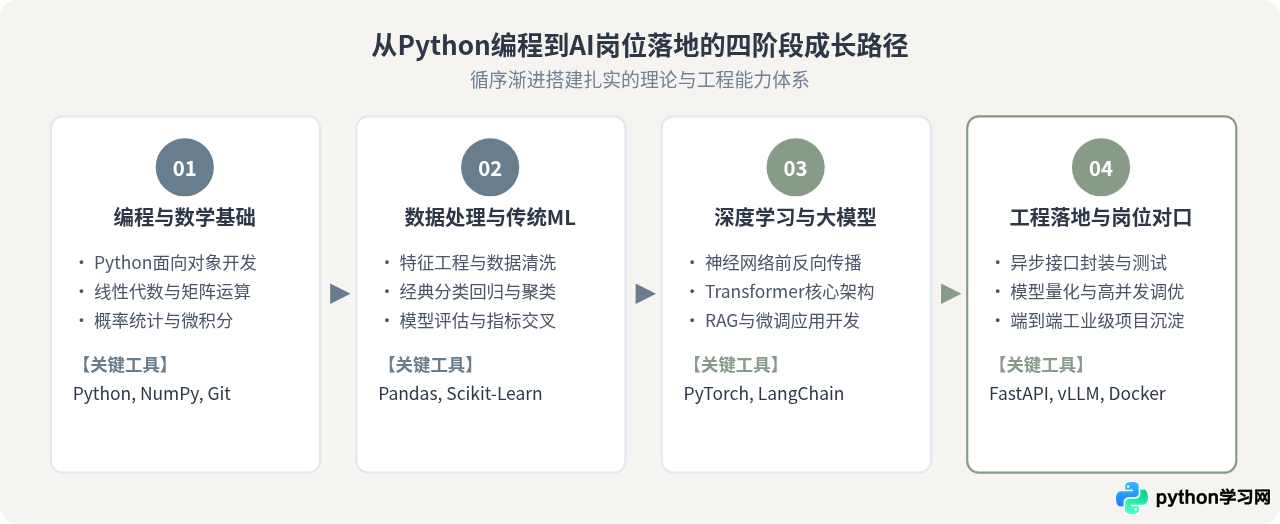
Python在人工智能领域的岗位并非单一孤立,而是形成了一个分工严密、各司其职的工程矩阵:从负责基础数据供给的数据挖掘工程师,到负责建立数学表达的算法工程师,再到负责业务集成的大模型应用工程师,以及保障高并发稳定的MLOps平台工程师。在准备求职项目或技术积累时,切忌在简历中仅写“掌握Python与AI”,而应紧扣目标岗位的具体痛点展示代码实力——例如针对应用岗展示具备完整评估链路的RAG/Agent项目,针对MLOps岗展示量化压缩与vLLM部署实测数据,以此展现清晰而扎实的工业落地能力。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









