

怎么利用《Python程序设计基础》第三版制定高效自学计划
针对《Python程序设计基础》第三版教材,梳理章节知识拓扑、剪枝策略与四阶段推进路线,提供每日读敲调改闭环与量化验收指标,帮助自学者高效掌握Python编程核心能力。
制定高效自学计划的核心,是将《Python程序设计基础》第三版从“线性阅读的教科书”转化为“按需剪枝与定向输出的工程手册”。通过将全书内容拆解为语法基石、数据结构与函数、面向对象与工程支撑、项目综合四个递进阶段,配合“30%精读概念、70%单步调试与变式重构”的单日执行闭环,可在8周内建立扎实的编程底座,避开通读忘光和抄书假学的陷阱。
一、明确教材定位与自学目标基线
《Python程序设计基础》第三版由董付国编著,是高校计算机类专业广泛采用的经典教材。该书的显著特点是语法覆盖细致、内置方法归纳详尽、代码案例短小精悍。但也正因为偏向大学课程与参考书属性,书中后半部分涵盖了图形界面、网络编程、爬虫、数据库以及科学计算等多个离散领域。
对于自学者而言,如果从第1页平铺直叙地通读到最后一页,极易出现以下两类损耗:
- 信息过载导致进度停滞:在未熟练掌握函数和数据结构之前,过早介入底层Socket编程或复杂GUI事件循环,造成挫败感。
- 只读不写的伪掌握:看懂了书上的几十行演示代码,离开书本却写不出具有完整输入输出和异常防御的独立程序。
因此,自学计划必须以“建立独立编码能力”为唯一目标,将全书知识点划分为主干必修与领域选修,确立清晰的阶段递进路径。
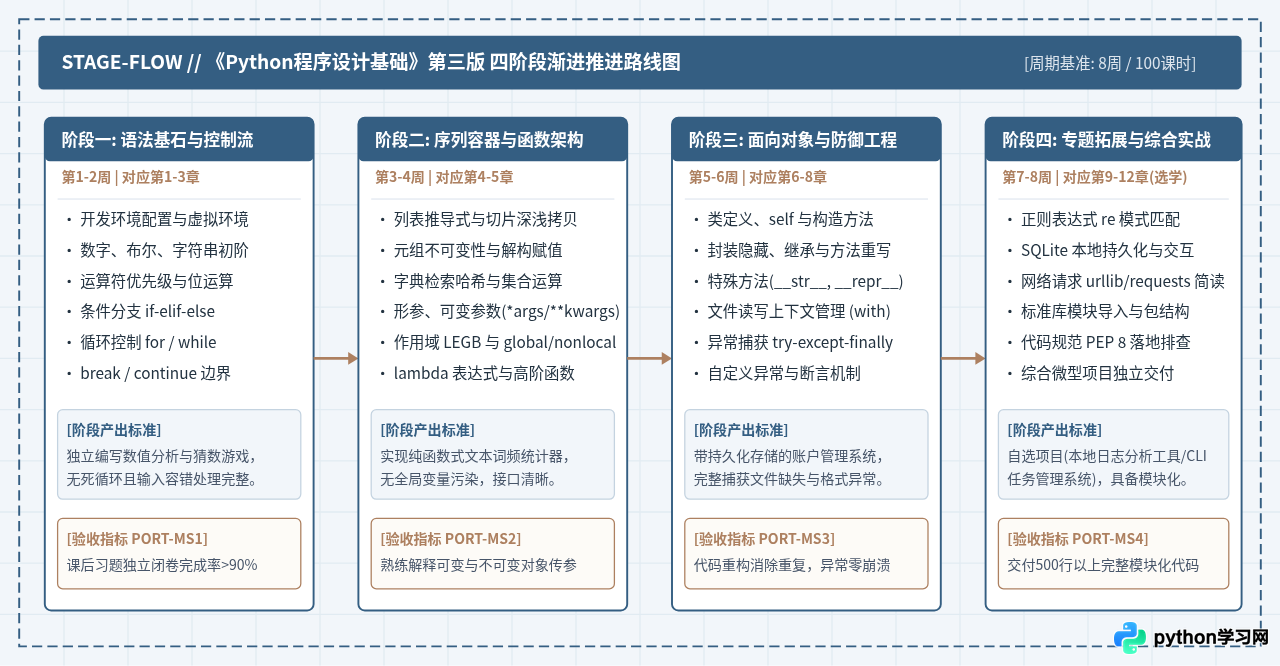
二、四阶段推进路线与时间周期分配
基于常规自学者每周投入12至15小时的节奏,整套计划推荐设计为为期8周的四阶段体系。每个阶段设定硬性的阶段产出与验证标准,未达成前不开启下一阶段。
三、教材章节知识拓扑与剪枝选学矩阵
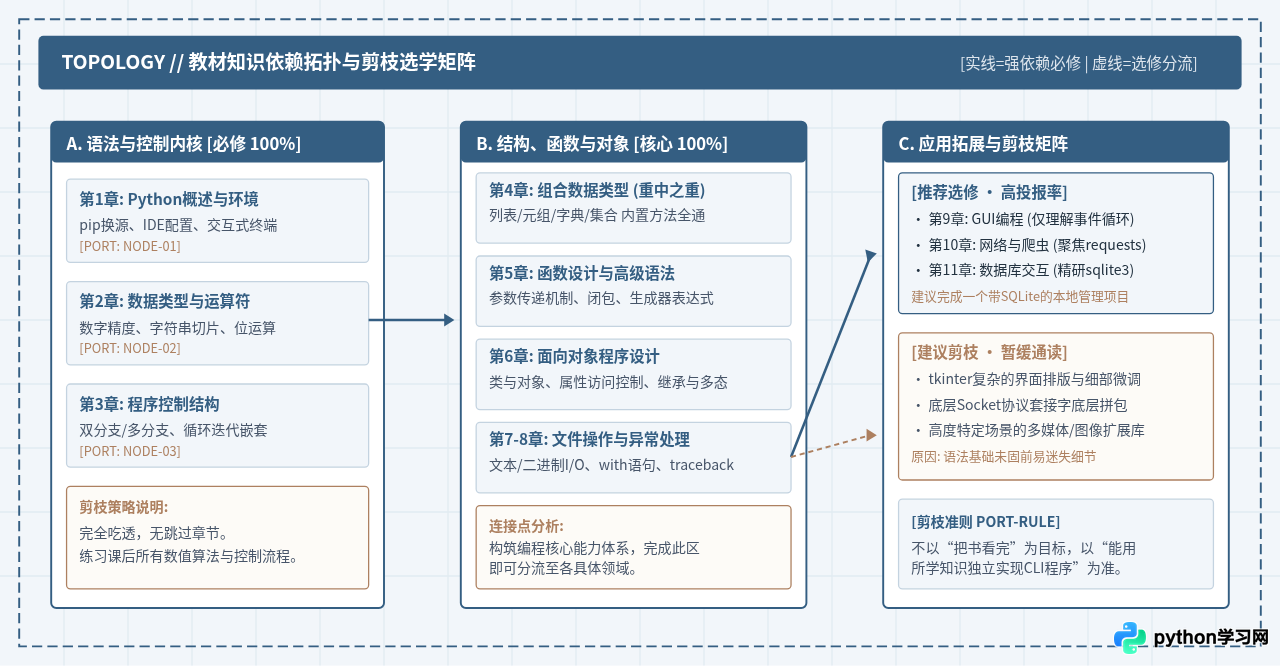
《Python程序设计基础》第三版的章节安排遵循了“由基础语法到具体应用”的逻辑。自学计划的高效性很大程度上取决于对章节的“剪枝”(Pruning)决策。将精力100%集中在核心支柱上,对于分支应用则采取“理解原理、按需取用”的态度。
各章节剪枝策略详细说明
| 章节范围 | 教材内容 | 推荐投入时间 | 执行建议与剪枝要点 |
|---|---|---|---|
| 第1-3章 | 基础语法、数据类型、运算符、分支与循环结构 | 第1至2周 (约25小时) | 全量精研:必须逐题手敲课后习题。重点练习循环不变式、复杂条件判断与位运算符的基础应用。 |
| 第4-5章 | 常用内置对象(列表/元组/字典/集合)与函数 | 第3至4周 (约30小时) | 重中之重:重点理解列表推导式的执行效率、字典哈希机制、函数默认参数陷阱以及可变对象作为形参的浅拷贝问题。 |
| 第6-8章 | 面向对象程序设计、文件操作、异常处理结构 | 第5至6周 (约25小时) | 工程基石:彻底弄懂继承、方法重写与多态概念;文件读写必须全部基于 with open(...) 结构,禁止裸调用 close()。 |
| 第9-12章 | GUI编程、网络通信、数据存储、数据分析扩展 | 第7至8周 (约20小时) | 定向剪枝:跳过冗长的tkinter布局参数记忆;选取SQLite与文件日志构建一个实用的本地数据分析脚本即可。 |
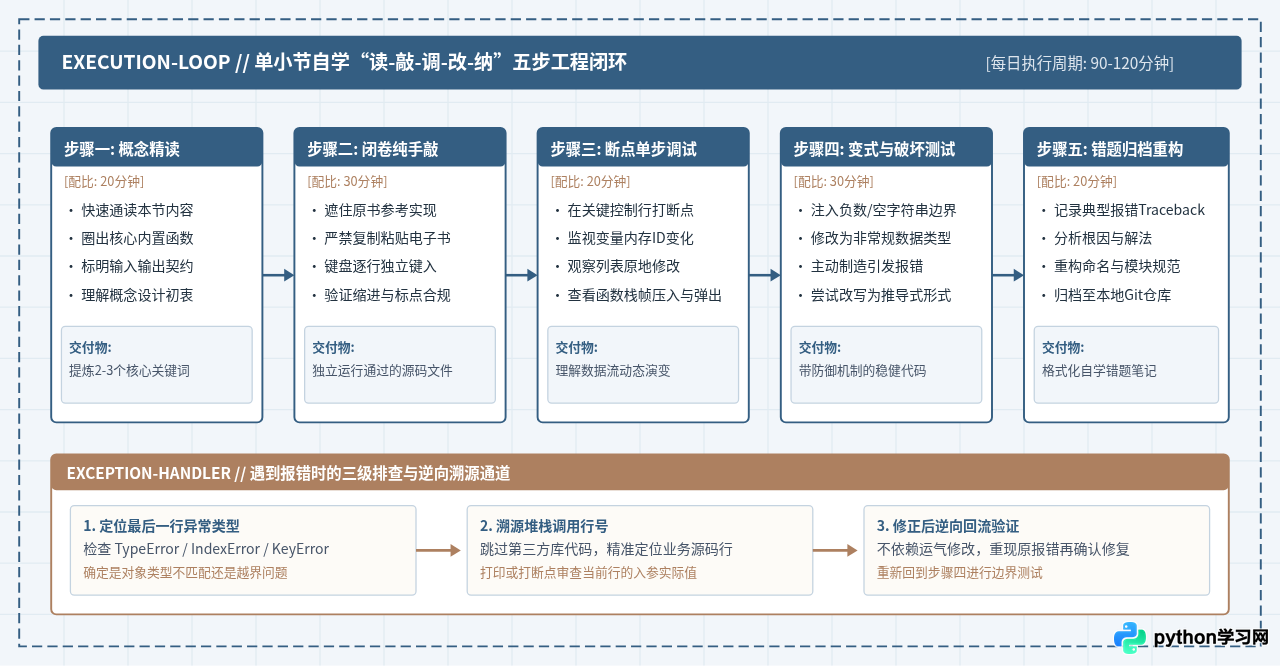
四、每日自学执行:“读-敲-调-改”五步闭环
自学编程最常见的误区是“看懂了就以为自己掌握了”。实际上,阅读代码只调动了大脑的被动识别区域,只有编写与排错才能建立真正的语法心智模型。每天规划2小时的学习时间,应严格按照如下“五步闭环流程”推进。
变式改造示例:从原书代码到健壮代码
以教材中常见的“计算学生成绩平均值并按等级输出”为例,原书示例往往假设输入完全合规。在自学执行步骤四中,读者应主动对其进行“破坏与防御改造”:
# 原书示范形式 (脆弱代码,极易因输入异常崩溃)
scores = [85, 92, 78, 60, 99]
avg = sum(scores) / len(scores)
print("平均分:", avg)

# 读者变式改造形式 (具备边界保护与异常防御的健壮实现)
def calculate_class_average(score_list: list) -> float:
    """计算成绩平均分,包含类型校验与除零防御"""
    if not isinstance(score_list, list):
        raise TypeError("输入必须为列表类型")

    # 过滤非数值元素并打印警告
    valid_scores = [s for s in score_list if isinstance(s, (int, float)) and 0 <= s <= 100]

    if not valid_scores:
        print("[警告] 有效成绩为空,返回默认分0.0")
        return 0.0

    return round(sum(valid_scores) / len(valid_scores), 2)

# 测试边界场景
print("常规输入:", calculate_class_average([85, 92, 78, 60, 99]))
print("空列表防御:", calculate_class_average([]))
print("脏数据过滤:", calculate_class_average([85, "N/A", -5, 120, 90]))初学者切忌只按运行键(Run)。遇到列表推导式、递归函数或字典键值遍历时,必须在VS Code或PyCharm中设置断点,使用 Step Over (F10) 与 Step Into (F11) 观察变量视图(Variables Window)。重点观察变量在内存中的地址与类型变化,这能帮你在第二周就彻底搞清楚浅拷贝(Shallow Copy)与深拷贝(Deep Copy)的根本区别。
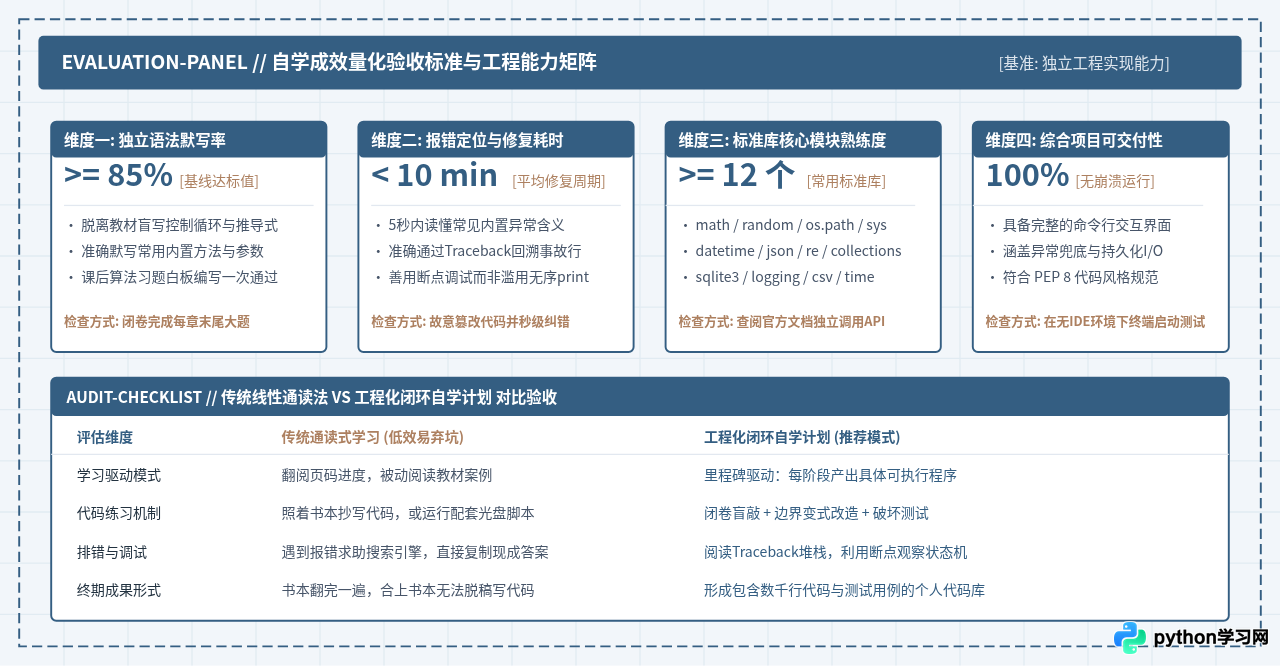
五、自学成效量化验收与评估指标
自学计划的另一大风险是“沉没成本幻觉”——读者花费了大量时间看书,却无法评估自己的实际水平。为了确保每个阶段扎实通关,需要建立一套客观、可测量的量化评估指标体系。
六、自学过程中的高频误区与规避准则
在利用该教材执行自学计划时,必须警惕以下三个极易拖慢进度的高频误区:
- 陷入“完美主义环境配置”陷阱:很多读者在第1章花费数天时间纠结于各种插件、主题、高级终端的美化。正确的做法是:直接安装官方Python 3.10+版本,配合最基础的VS Code或PyCharm Community,安装Python官方扩展后立即进入第2章语法练习。开发工具是在后续解决实际冲突时逐步熟悉的。
- 对高级语法过早追求“炫技”:教材第4章与第5章涉及复杂的嵌套列表推导式、装饰器(Decorator)与生成器(Generator)。初学者切忌在没有掌握清晰多行逻辑前,强行将多重循环压缩为一行晦涩的推导式。可读性与健壮性永远先于语法糖。
- 忽视课后习题的独立求解:该书每章课后均提供了精选编程大题。许多自学者习惯直接在网上搜寻题解答案,这会彻底破坏大脑建立“问题抽象到代码实现”的神经通路。每道题至少尝试独立编码20分钟以上;即便参考了题解,也必须在隔天进行完全闭卷重写。
七、终期落地:从书本走向独立项目
当执行完前六周的核心计划后,第7至8周切忌继续做零散的小语法练习。此时应在以下三个综合小项目中任选其一,脱离书本独立完成:
- 本地日志分析与报表提取器:读取包含上万行模拟服务器访问日志文件,利用
re正则提取IP、请求路径与响应状态码,统计高频异常,并基于csv格式输出格式化报表。 - 基于SQLite的个人任务管理CLI:通过命令行交互接收任务增删改查指令,利用
sqlite3建立底层数据表,具备完整的输入参数防御与非法ID捕获能力。 - 带自动归档功能的本地文件整理守护脚本:监控特定下载文件夹,根据文件后缀名与修改日期,自动分类移动至对应归档目录,并生成操作日志。
完成上述任意一个综合项目,并将其代码规范重构为符合PEP 8标准、附带清晰docstring文档的独立模块,即可宣告该自学计划圆满达成,顺利跨越从“初学读者”到“具备实战能力开发者”的鸿沟。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









