

GitHub合并超时事故解决后为什么还要区分PR与工作流结果
GitHub的Pull Requests事故解决,不等于故障期间每个PR及其下游工作流都已完成。平台状态、合并结果和构建测试结果属于不同层次。11月13日的合并超时事故已于北京时间11月14日02:29解决,但具体任务仍不能仅凭这条平台恢复通知判定成功。
平台恢复回答的是哪一层问题
平台恢复说明供应商已经结束对这场事故的处理中断状态。它不包含每个仓库的PR列表,也没有逐项列出哪些用户的合并尝试成功、哪些调用方未取得响应。因此,恢复通知不能直接充当某一次业务操作的回执。
这次官方事件首先报告Pull Requests可用性降级,随后明确为部分合并尝试超时。它没有宣布所有Actions工作流停止,更没有要求所有仓库在恢复后统一重跑构建。把局部影响扩大成全部自动化都需重启,并不符合已知范围。
PR状态与检查结果为什么不能合成一个结论
PR用于管理待合并变更,检查或工作流则反映相应自动化的运行情况。合并操作与检查运行有联系,但并不是同一个结果。一次合并成功也不能自动证明所有下游部署都成功;一次检查失败同样不能单独证明PR没有合并。
如果要理解故障后的状态,应保留对象之间的对应关系:哪一个PR、哪一份提交、哪一项检查。仅看到仓库中有一条成功记录,并不足以说明它对应的就是之前超时的那一次任务。这里讨论的是判断边界,不是要求新增权限或更改分支保护。
超时能否作为自动补跑的充分依据
不能。超时首先反映调用方没有及时得到预期响应,业务结果可能仍需要确认。把所有超时都当成“没执行”,再统一发起新的写入或合并动作,会让结果核对更加困难。
同理,没有工作流结果与工作流明确失败,也需要分别理解。本次事故说明没有给出一套通用于所有工作流的补跑条件、次数或间隔。是否需要新的运行,应由具体任务的实际状态和仓库既有流程决定,不能借用其他事故的漏触发比例下结论。
这次恢复进展怎样解读
GitHub先采取缓解措施,随后在北京时间11月14日01:28进入监控;02:29才正式标记为已解决。两条信息的确定程度不同:已缓解并监控仍属于观察稳定性,已解决则是供应商对这场事件的最终状态更新。
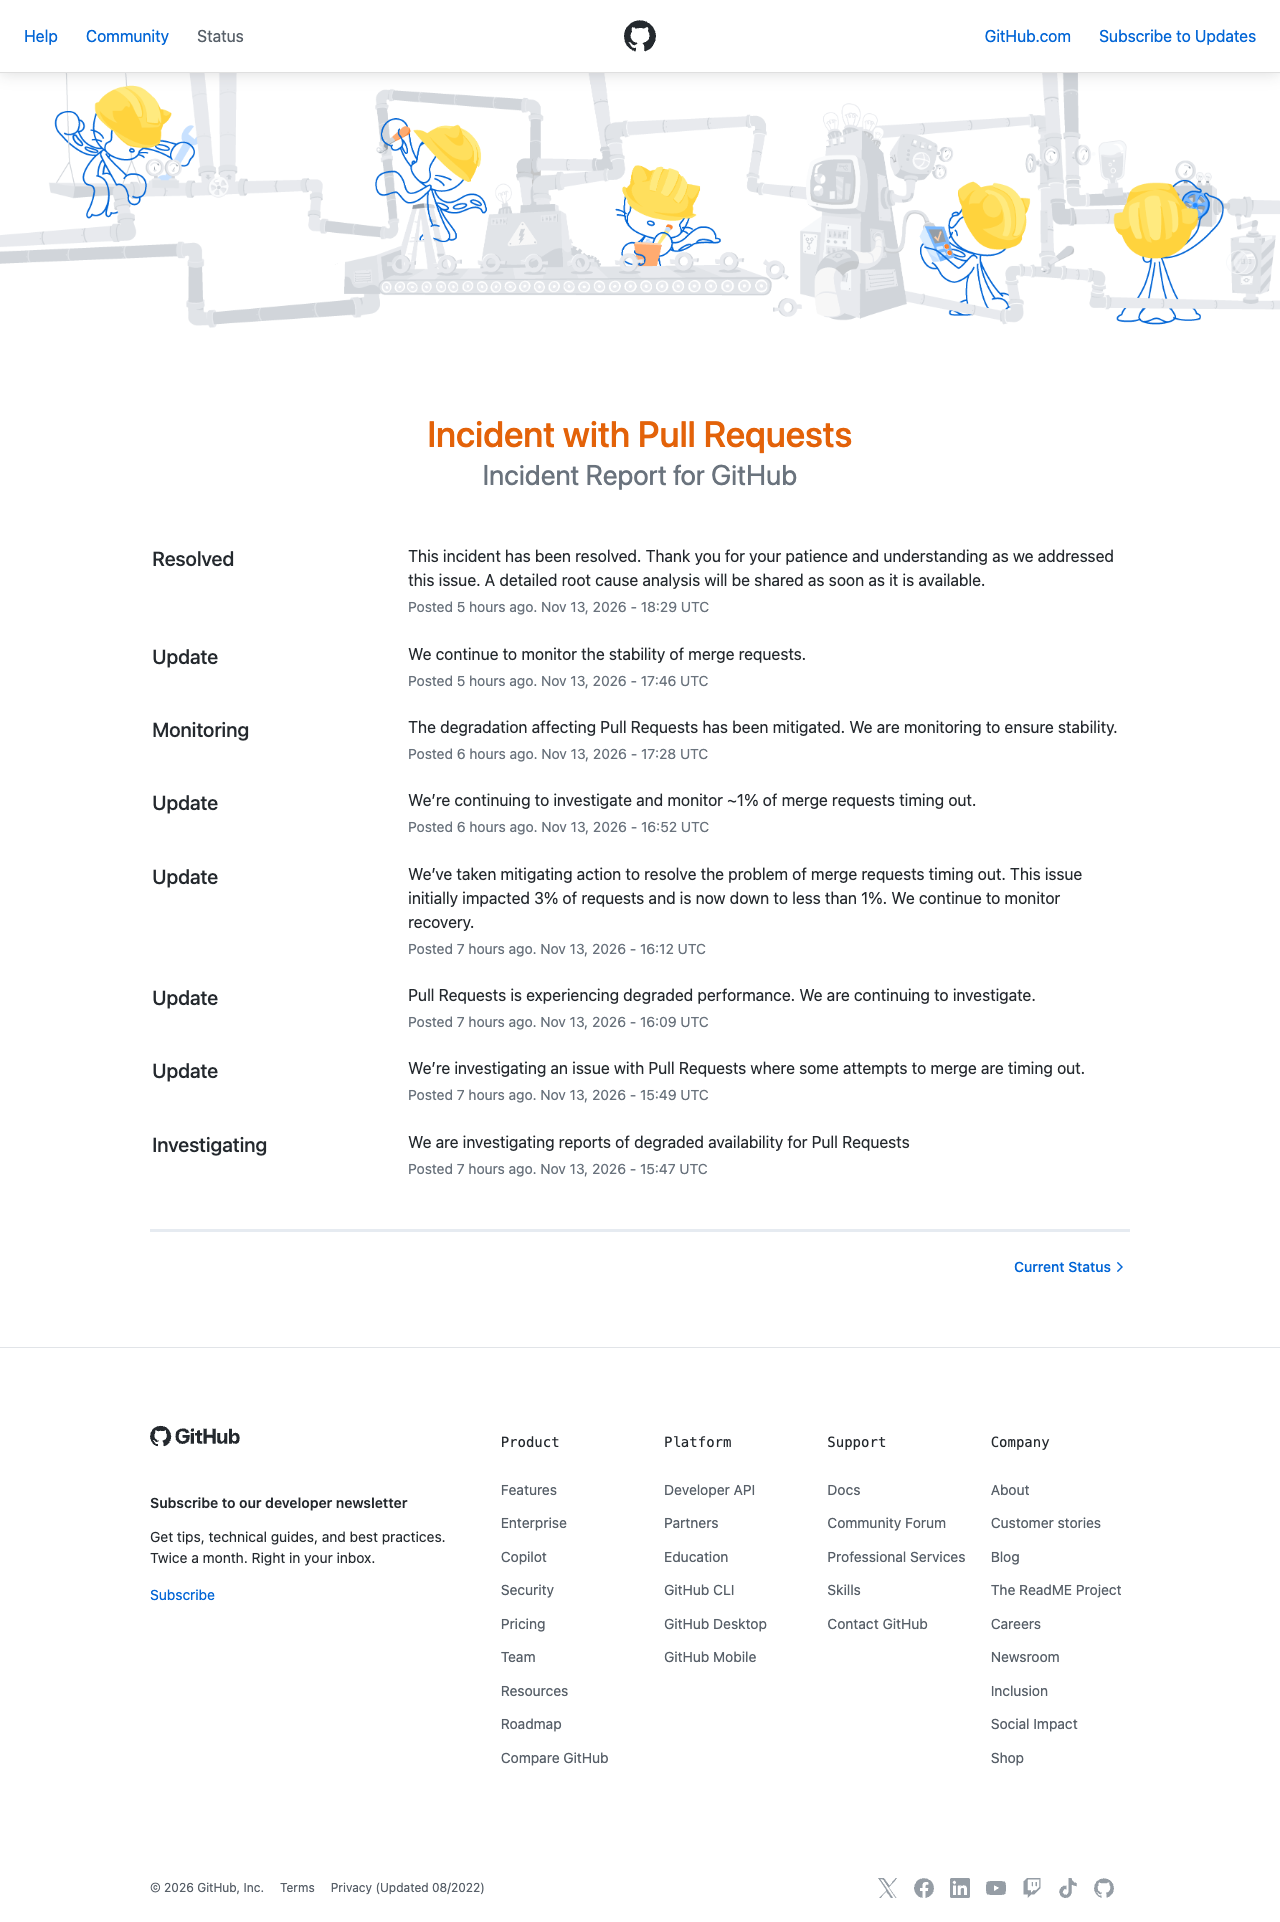
事件中先后出现约3%、不足1%及约1%的请求影响观测,来自不同更新时刻,不能累加为累计受影响比例,也不能用它们估算某个组织失败的任务数量。
不要把另一场事故的结论套进来
11月10日Git操作和PR事故的复盘,是另一个事件。那场事件的Actions延迟、漏触发比例和根因分析,不能作为11月13日合并超时的确定解释。对这次事故,GitHub的解决通知仍表示详细根因分析将后续公布。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









