

Python汉诺塔代码:怎么打印每一步移动路径
详细讲解如何在Python中编写汉诺塔递归算法并完整打印每一步的移动路径。从最小可运行代码、递归参数交换原理到带序号输出与生成器解耦,深入剖析调用逻辑与常见避坑点。
一、核心解决方案:最小可运行代码
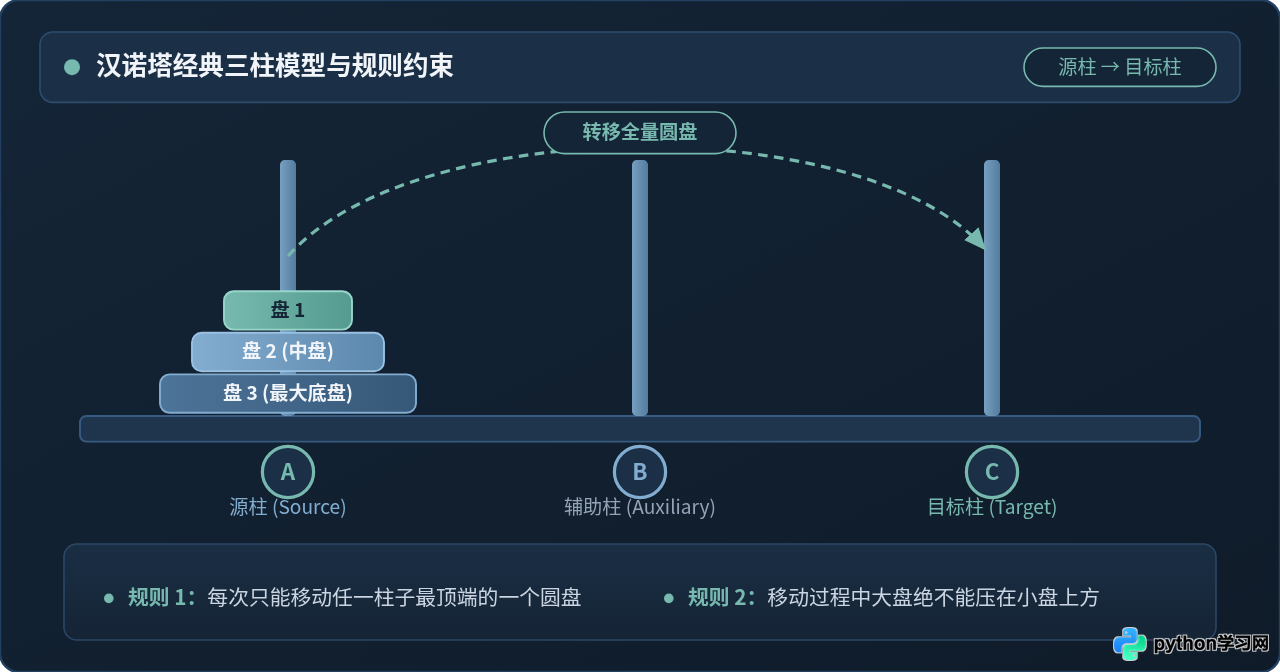
假设有三根柱子分别命名为 'A'、'B' 和 'C',我们的目标是将 n 个大小不一的圆盘从 'A'(源柱)全部转移到 'C'(目标柱),并在转移过程中借助 'B'(辅助柱)。
下面是实现每一步路径打印的最简完整代码。你可以在本地任何 Python 3 环境下直接运行:
def hanoi(n, source, target, auxiliary):
    # 基线条件(递归出口):只有一个圆盘时,直接移动并打印
    if n == 1:
        print(f"将盘 1 从 {source} 移动到 {target}")
        return

    # 步骤 1:将上面 n-1 个圆盘从 source 移到 auxiliary,借助 target
    hanoi(n - 1, source, auxiliary, target)

    # 步骤 2:将底层的第 n 个圆盘直接从 source 移到 target 并打印
    print(f"将盘 {n} 从 {source} 移动到 {target}")

    # 步骤 3:将 auxiliary 上的 n-1 个圆盘移到 target,借助 source
    hanoi(n - 1, auxiliary, target, source)

# 运行测试:以 3 层汉诺塔为例
hanoi(3, 'A', 'C', 'B')将盘 2 从 A 移动到 B
将盘 1 从 C 移动到 B
将盘 3 从 A 移动到 C
将盘 1 从 B 移动到 A
将盘 2 从 B 移动到 C
将盘 1 从 A 移动到 C
从输出可以看出,算法严格遵守了游戏规则:任何时候都没有出现大盘压在小盘上的情况,且每一步都对应一次合法的单盘物理移动。
二、递归原理剖析:为什么三步就能解决?
初学者面对汉诺塔问题时,容易陷入具体的搬运细节(例如“第1步该往哪放才能保证后面不违规”)。递归思维的精髓在于逆向归纳:不要试图一次性看清几十步,而是把规模为 n 的问题降阶为规模为 n-1 的子问题。
要想把源柱 A 上的 n 个盘子全部移到目标柱 C,最大的第 n 号盘必须沉底到 C 柱。而要让第 n 号盘能够移动,必须满足两个前置条件:
- 上面的
n-1个圆盘已经离开A柱,整齐叠放在辅助柱B上。 - 目标柱
C必须是空的(或者只放了比n更大的盘,此处n是最大盘,因此C必须清空)。
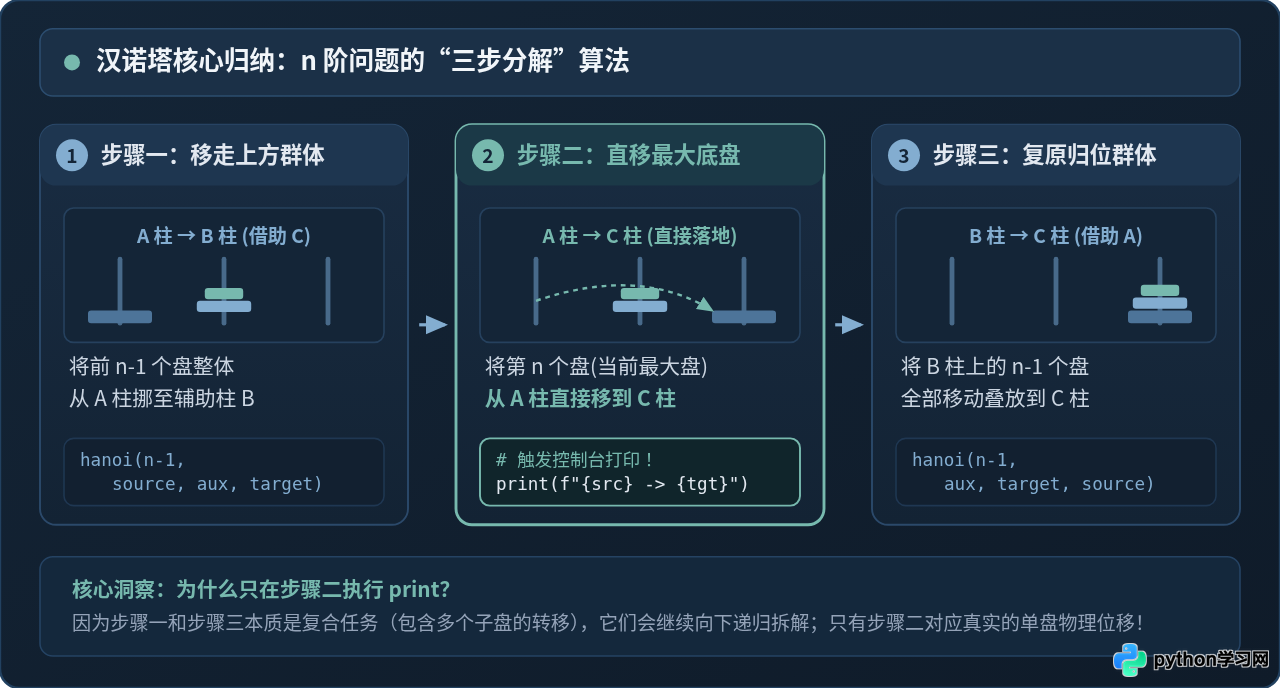
因此,任意层数的汉诺塔问题都可以严格拆解为三个阶段:
- 移开上层阻碍:调用
hanoi(n-1, source, auxiliary, target)。此时我们要把n-1个盘挪到辅助柱,因此目标变成了auxiliary,而原来的target充当了跳板。 - 移动关键底盘:此时底层最大盘露了出来,直接将其搬到目标柱上,执行
print()。注意:这一步是当前层级唯一产生的实际移动动作! - 复原上层圆盘:调用
hanoi(n-1, auxiliary, target, source)。此时n-1个盘还在辅助柱上,需要把它们重新搬回目标柱叠在大盘上方,原来的source转为临时跳板。
在上述代码中,当 n == 1 时直接打印并返回。即使去掉 if n == 1 的显式判断,改为 if n > 0 包裹三个步骤,当 n == 1 时子递归调用 n-1 = 0 直接结束,逻辑同样严密成立。但保留显式的 n == 1 递归基能让代码意图更直观。
三、执行轨迹跟踪:打印顺序是如何生成的
许多读者感到困惑:代码中明明只写了一个 print 语句,为什么运行起来却能按照严格的先后次序、一行不差地打印出所有步骤?
这是因为 Python 函数调用是基于调用栈(Call Stack)展开的。计算机在执行递归时,先不断深入左子树,直到触发 n == 1 的基线条件,执行完打印后回溯,再执行中间的 print,最后进入右子树。这种执行顺序在二叉树遍历中被称为中序遍历(In-order Traversal)。
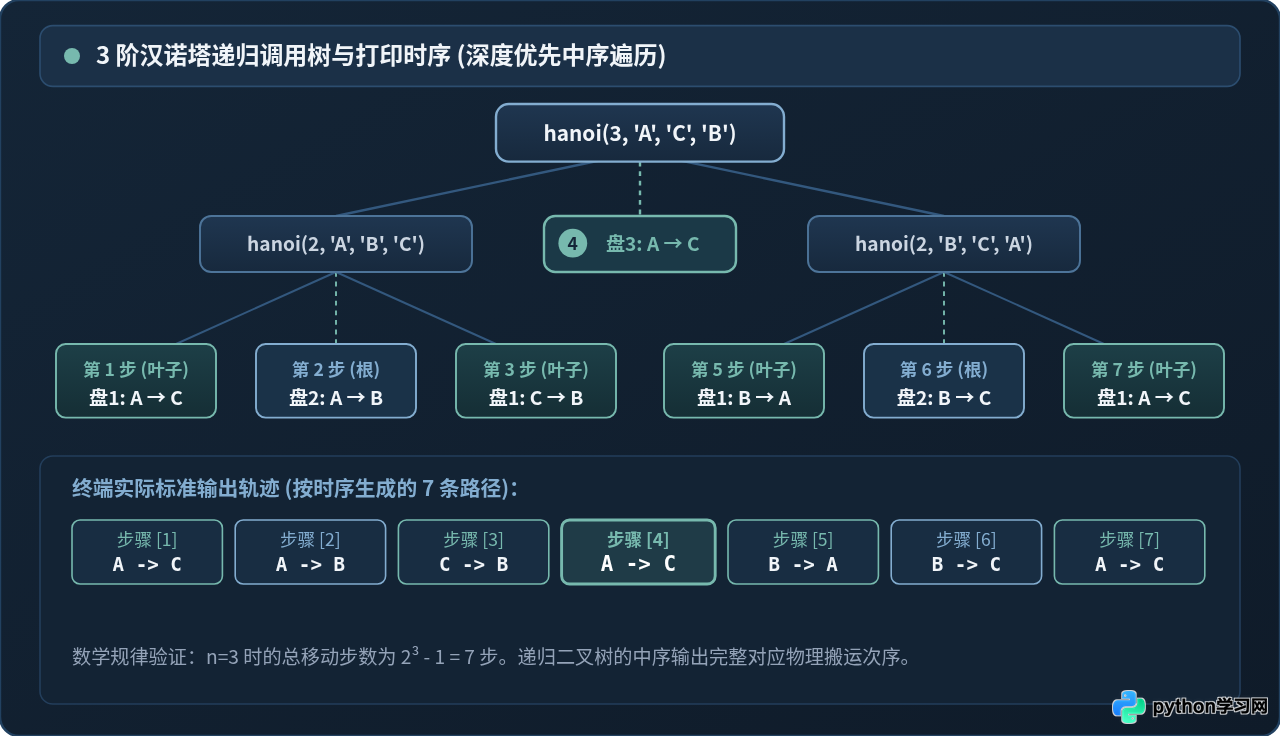
我们以 n = 3 为例,完整还原调用栈的压栈与弹栈次序:
- 调用
hanoi(3, 'A', 'C', 'B'),先进入左侧子任务hanoi(2, 'A', 'B', 'C')。 - 继续进入更深一层的
hanoi(1, 'A', 'C', 'B'),触发基线条件,输出第 1 步:A -> C。 - 弹栈回到
hanoi(2),执行本层的打印,输出第 2 步:A -> B。 - 进入右侧子任务
hanoi(1, 'C', 'B', 'A'),输出第 3 步:C -> B。至此,2 个盘成功从 A 移到了 B。 - 弹栈回到最外层
hanoi(3),执行本层的打印,输出第 4 步:A -> C(底盘就位)。 - 进入后半段任务
hanoi(2, 'B', 'C', 'A'),同理展开后依次输出第 5、6、7 步。
四、理解形参轮换:区分“角色”与“实体”
编写汉诺塔代码时最容易踩的坑,就是把参数名当成了固定不变的物理柱子。在函数原型 def hanoi(n, source, target, auxiliary) 中:
source、target、auxiliary是角色槽位(分别表示“本次移动的起点”、“本次移动的目的地”以及“临时借用的中转站”)。- 而传入的实参
'A'、'B'、'C'才是物理柱子的编号。
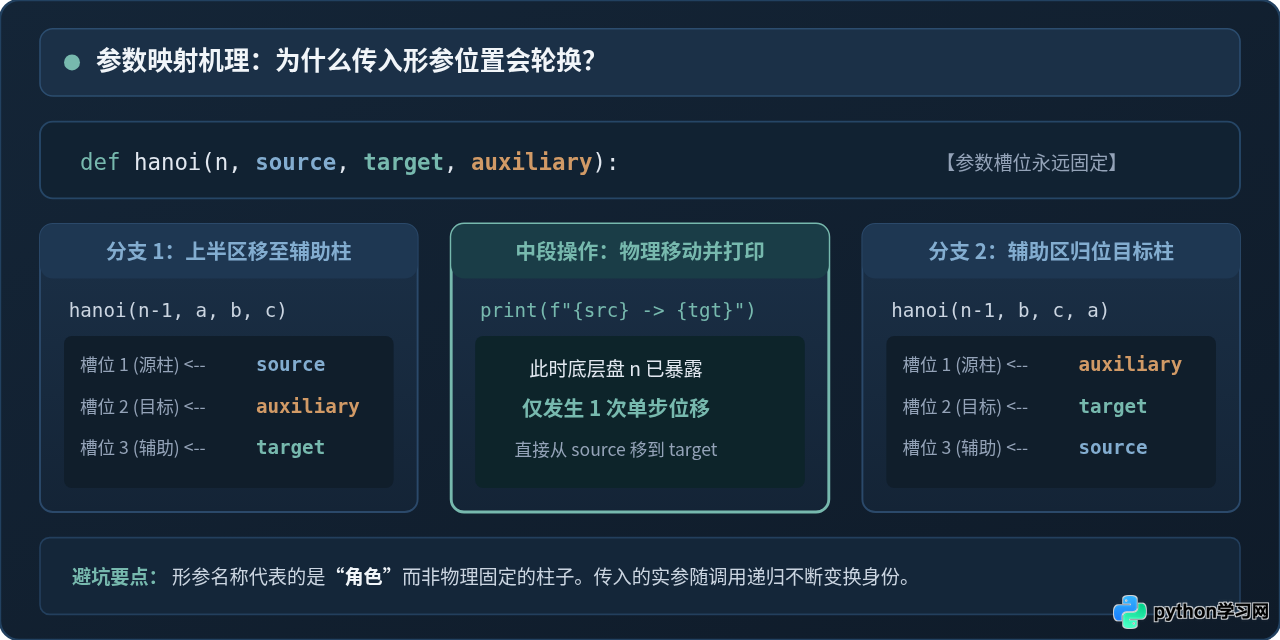
请仔细对比前后两次递归调用的参数传递顺序:
| 调用语句 | 起点槽位 (source) | 目的地槽位 (target) | 中转站槽位 (auxiliary) | 业务含义 |
|---|---|---|---|---|
hanoi(n-1, source, auxiliary, target) |
source |
auxiliary |
target |
把上层盘移到辅助柱暂存 |
print(...) |
source |
target |
- | 底层单盘直移就位 |
hanoi(n-1, auxiliary, target, source) |
auxiliary |
target |
source |
把暂存盘移回目标柱归位 |
五、实用扩展:带步数序号与结构化输出
在实际项目、算法测试或制作图形化动画时,仅仅把文本 print 到控制台往往无法满足需求。常见的两类改进需求是:给移动步骤添加序号计数,以及将移动轨迹收集为数据列表或生成器。
方法 1:利用计数器打印全局步数序号
因为递归是多层嵌套调用的,局部整数变量无法跨层累加。优雅的做法是使用一个包装函数,通过 nonlocal 变量或者列表引用来追踪累计步数:
def hanoi_with_steps(n, source='A', target='C', auxiliary='B'):
    step_count = 0

    def _move(k, src, tgt, aux):
        nonlocal step_count
        if k == 1:
            step_count += 1
            print(f"第 {step_count:2d} 步: 将圆盘 1 从 {src} -> {tgt}")
            return

        _move(k - 1, src, aux, tgt)
        step_count += 1
        print(f"第 {step_count:2d} 步: 将圆盘 {k} 从 {src} -> {tgt}")
        _move(k - 1, aux, tgt, src)

    _move(n, source, target, auxiliary)
    print(f"==== 移动完成,共计 {step_count} 步 ====")

# 执行 3 层汉诺塔
hanoi_with_steps(3)第 2 步: 将圆盘 2 从 A -> B
第 3 步: 将圆盘 1 从 C -> B
第 4 步: 将圆盘 3 从 A -> C
第 5 步: 将圆盘 1 从 B -> A
第 6 步: 将圆盘 2 从 B -> C
第 7 步: 将圆盘 1 从 A -> C
==== 移动完成,共计 7 步 ====
方法 2:使用生成器(yield)解耦算法与输出
如果需要与前端界面、GUI 动画(如 Tkinter/Pygame)集成,不建议将 print 硬编码在算法内。改用 Python 的 yield from 语法,可以构建一个惰性迭代器:
def hanoi_generator(n, source, target, auxiliary):
    if n == 1:
        yield (1, source, target)
        return

    yield from hanoi_generator(n - 1, source, auxiliary, target)
    yield (n, source, target)
    yield from hanoi_generator(n - 1, auxiliary, target, source)

# 按需单步消费
for index, (disk, src, tgt) in enumerate(hanoi_generator(3, 'A', 'C', 'B'), start=1):
    print(f"[步骤 {index}] 盘 {disk} : {src} -> {tgt}")
六、复杂度分析与边界注意事项
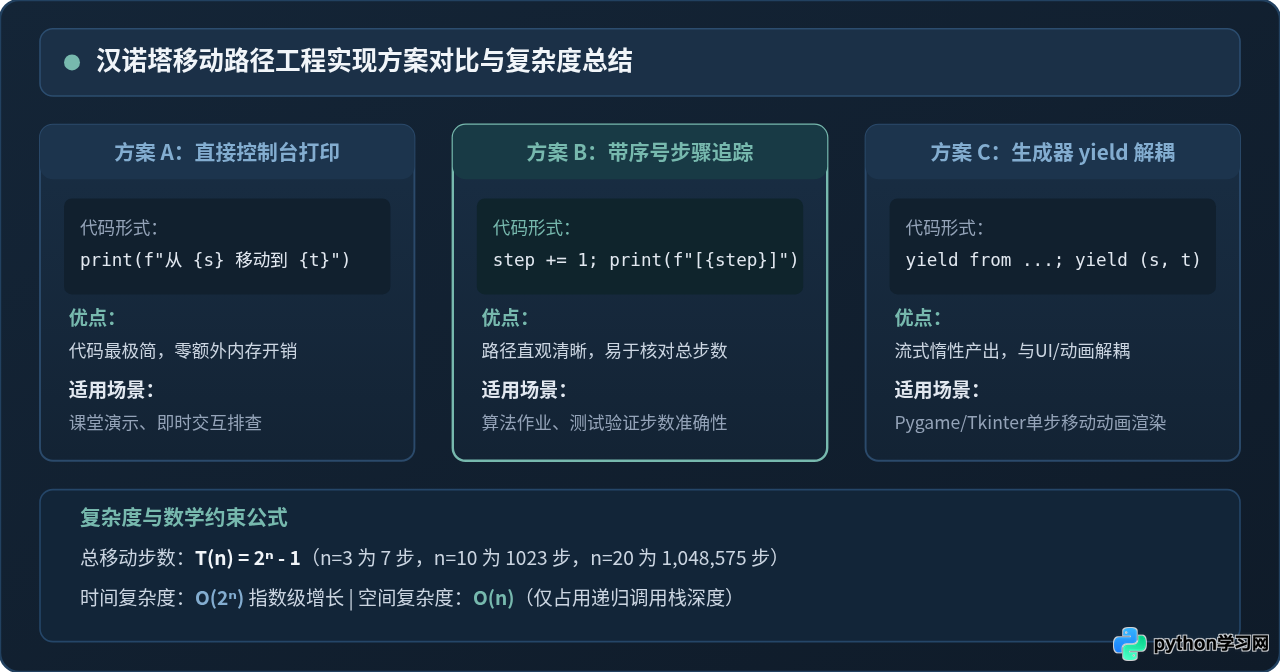
在实际编写和测试汉诺塔代码时,有两点至关重要的技术边界需要注意:
汉诺塔的最小总步数公式为严格的 2ⁿ - 1。当 n = 10 时需要移动 1,023 步;当 n = 20 时需要 1,048,575 步;当 n = 30 时步数将超过 10 亿次。因此在本地测试打印路径时,建议将 n 设定在 3 到 8 之间。如果传入过大的数值,控制台 I/O 阻塞会导致程序看似“卡死”。
由于递归深度等同于圆盘数 n(空间复杂度仅为 O(n)),Python 默认的递归深度限制(通常为 1000)在常规测试下完全够用。但如果你不小心漏写了 if n == 1: return 基线条件,函数将无限制向下执行 n - 1,迅速抛出 RecursionError: maximum recursion depth exceeded。检查递归出口是排查汉诺塔 bug 的首要步骤。
七、总结自查清单
要在 Python 中正确打印汉诺塔移动路径,只要把握好以下四点:
- 看准出口:当
n == 1时只剩一块盘,直接打印移动并return。 - 牢记三步:先将
n-1个盘挪向辅助柱,再打印底层第n个盘移向目标柱,最后将n-1个盘挪回目标柱。 - 核对参数:两次子递归调用的柱子传参位置完全对称颠倒,切勿写反辅助柱与目标柱的位置。
- 步数验证:计算输出的行数是否严格等于
2ⁿ - 1,以此快速校验逻辑是否无缺漏、无冗余。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









