

爬虫逆向中Python调用JS解密函数的实战技巧
详细讲解在爬虫逆向中如何使用Python高效稳定地调用JavaScript解密函数,涵盖断点定位扣取、JS代码剪枝、最小化补环境、Python桥接方案对比及高并发避坑指南。
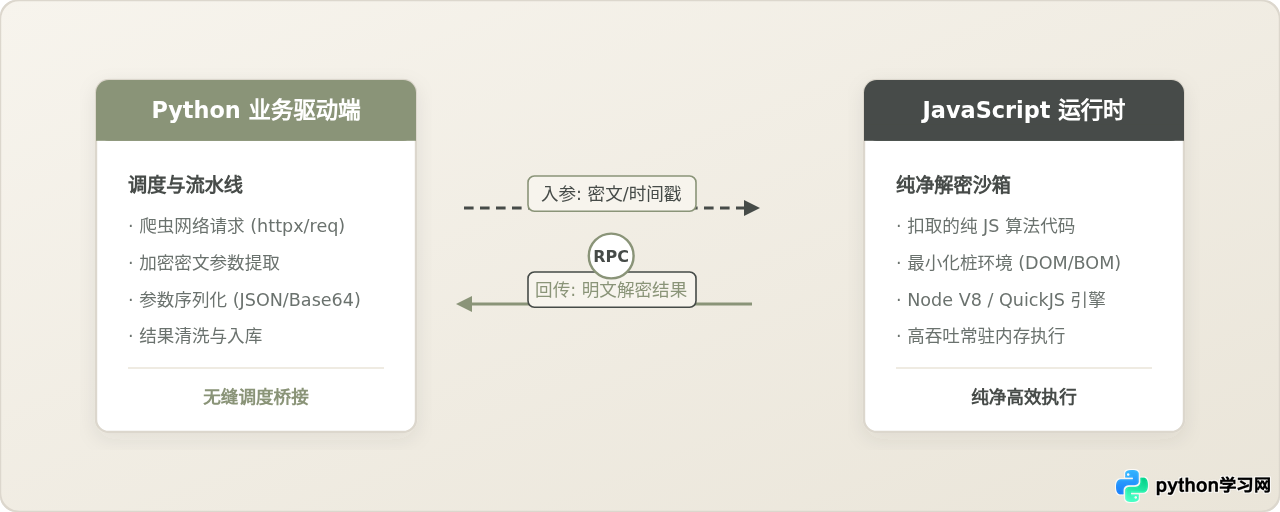
一、从浏览器断点到可独立调用的 JS 提纯步骤
在网页端数据通信中,接口返回的数据往往是一串毫无语义的高熵字符(即加密 Payload)。调用 JS 解密函数的第一要务,并非立即在 Python 中执行代码,而是在浏览器中将核心解密函数完备、纯净地提取出来,确保其脱离浏览器环境后仍能正确解出明文。
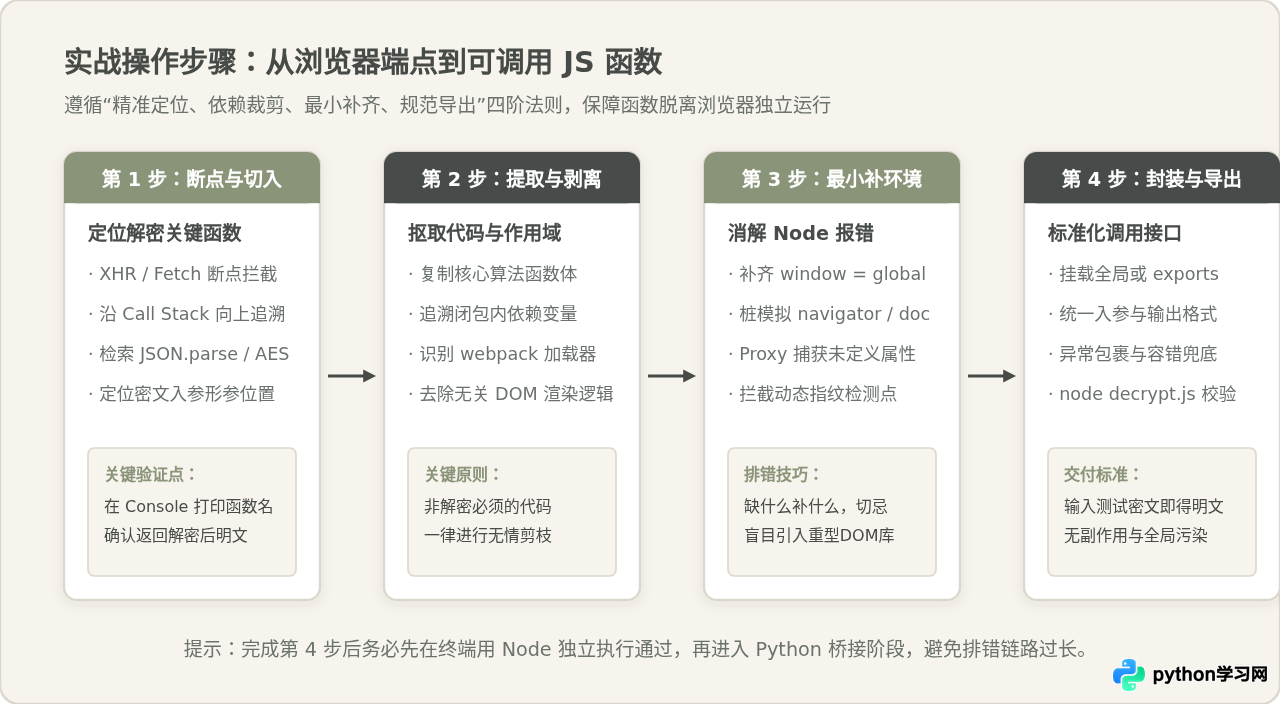
1. 断点定位与入口捕获
首先在 Chrome DevTools 的 Network 面板找到返回密文的 XHR/Fetch 请求。通过 Initiator 调用栈或在 Sources 面板中添加 Fetch/XHR Breakpoints(以请求 URL 中的关键字为触发条件),让页面在数据接收瞬间暂停。
在暂停状态下,沿着 Call Stack(调用栈)自底向上单步追踪,寻找类似 JSON.parse(decrypt(data))、AES.decrypt、decode 或自定义哈希函数。当找到具体解密函数时,在控制台(Console)直接调用该函数并传入捕获的响应体密文,若能正确打印出解密后的业务明文对象,便确立了目标解密函数。
2. 依赖剪枝与闭包提纯
在大型 Web 应用(特别是经 Webpack 打包或 Obfuscator 混淆的项目)中,核心解密逻辑往往被包裹在庞大的自执行函数(IIFE)或模块加载器中。很多逆向初学者常犯的错误是将数兆大小的整段混淆代码全量复制,这不仅会导致执行性能急剧恶化,还会引入大量与解密无关的 DOM 渲染报错。
正规的做法是自顶向下依赖剪枝:只复制解密函数本身及其直接引用的变量映射表、S盒(S-Box)、编码转换字典。对于仅用于页面渲染、动画呈现或广告追踪的代码,一律删除。
3. 标准化导出包装
将剪枝后的 JS 代码整理为一个独立文件(例如 decrypt.js),并在末尾显式暴露全局调用接口:
// decrypt.js - 规范化导出示例
(function () {
    // 扣取的核心混淆逻辑及解密依赖
    function coreDecrypt(cipherText, keyStr) {
        // 此处为扣取的算法细节(如自定义异或、DES变种或AES封装)
        var raw = Buffer.from(cipherText, 'base64').toString('utf-8');
        return raw;
    }

    // 适配 Node.js 模块导出与全局作用域
    if (typeof module !== 'undefined' && module.exports) {
        module.exports = { coreDecrypt: coreDecrypt };
    } else {
        window.coreDecrypt = coreDecrypt;
    }
})();
完成保存后,在系统终端直接执行 node decrypt.js 并通过内置测试用例验证。切记:必须确保 JS 脚本在 Node.js 环境中能稳定输出正确结果,再进入 Python 桥接阶段。
二、Python 调用 JavaScript 的三种核心方案评测
当解密函数可以在本地 JS 运行时被正常调用后,下一步是建立 Python 爬虫程序与 JS 代码之间的通信链路。常见的实现路径有三种,各自具有明确的边界与优劣势。
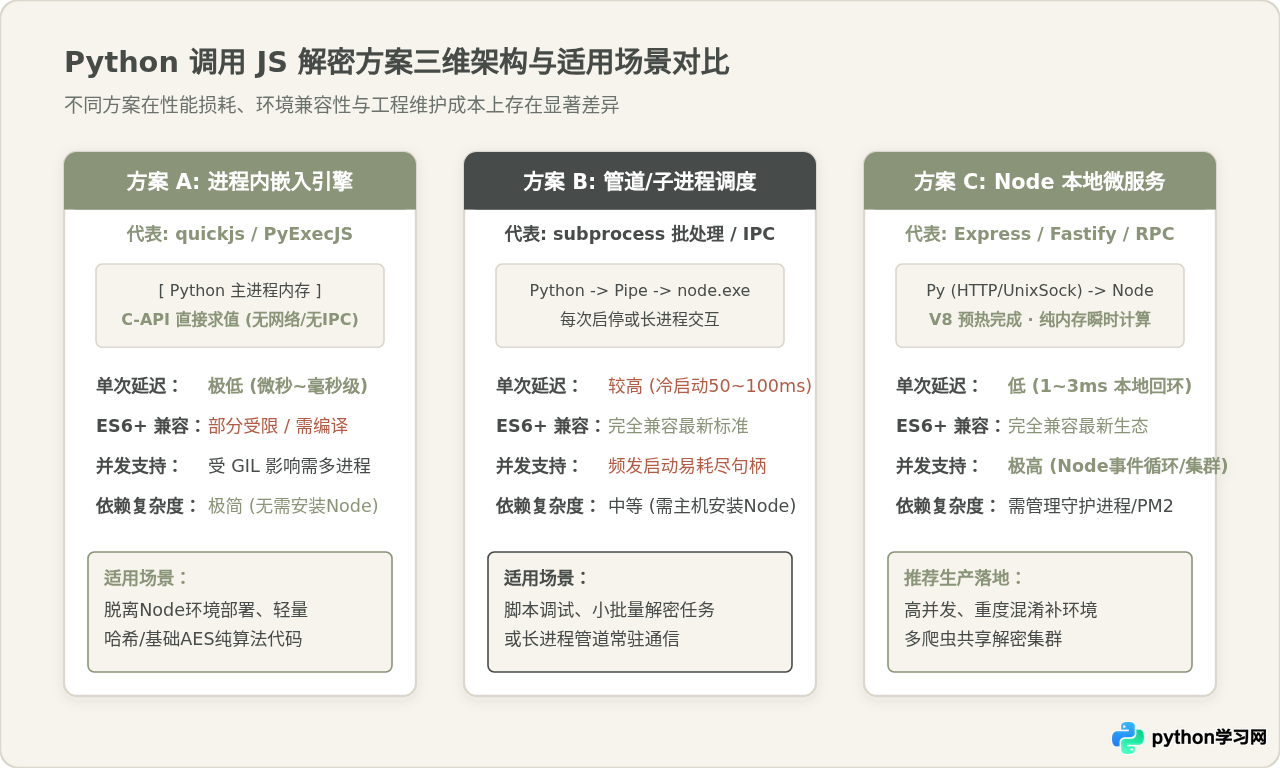
方案 1:嵌入式轻量引擎(以 quickjs / Python-Monkey 为例)
该方案直接在 Python 进程中载入基于 C/C++ 实现的轻量 JavaScript 解释器(如 QuickJS)。其核心优势在于零外部依赖与微秒级调用延迟,非常适合打包分发或无需安装 Node.js 的云函数环境。
# Python 端直接执行 QuickJS 示例
import quickjs

# 初始化上下文环境
context = quickjs.Context()

# 读取纯 JS 解密源码
with open("pure_decrypt.js", "r", encoding="utf-8") as f:
    js_code = f.read()

context.eval(js_code)

# 传入密文参数并求值
cipher_data = "dGVzdF9jaXBoZXJfdGV4dA=="
decrypt_func = context.eval("coreDecrypt")
plain_result = decrypt_func(cipher_data)
print("解密明文:", plain_result)crypto、fs、Buffer)。若解密逻辑深度依赖现代 Webpack 生态或外部 npm 包,需要额外使用 Babel 降级转译,否则会抛出语法错误。
方案 2:子进程管道通信(subprocess 方案)
通过 Python 标准库中的 subprocess 模块启动系统的 node 进程,将加密文本通过命令行入参或标准输入(stdin)管道传输,并捕获其标准输出(stdout)。
# Python 端基于 subprocess 的管道调用
import subprocess
import json
import base64

def decrypt_by_subprocess(cipher_text: str) -> dict:
    # 使用 Base64 包装以避免特殊字符被 shell 截断
    safe_input = base64.b64encode(cipher_text.encode('utf-8')).decode('ascii')

    # 启动 Node 进程执行包装脚本
    cmd = ["node", "run_decrypt.js", safe_input]
    res = subprocess.run(cmd, stdout=subprocess.PIPE, stderr=subprocess.PIPE, text=True, check=True)

    # 解析 Node 输出的标准 JSON 串
    return json.loads(res.stdout.strip())
这种方式保证了与最新 Node.js 生态的 100% 语法兼容。但如果每次爬虫解析请求都 subprocess.Popen 重新启动一次 Node 进程,系统必须经历完整的 V8 引擎冷启动、代码编译与内存分配周期。单次调用耗时通常在 50ms~120ms 之间,在高并发场景下极易导致 CPU 满载并迅速耗尽文件描述符(FD)。
方案 3:本地常驻微服务与 RPC(推荐生产架构)
在工业级爬虫架构中,最推崇的做法是将解密函数托管在一个轻量级的常驻 Node.js 服务中(如采用 Fastify 或 Express),或者通过 Unix Domain Socket 建立 RPC 通道。
// server.js - 本地轻量解密服务
const express = require('express');
const { coreDecrypt } = require('./decrypt');

const app = express();
app.use(express.json({ limit: '10mb' }));

app.post('/api/decrypt', (req, res) => {
    try {
        const { ciphertext, key } = req.body;
        const plaintext = coreDecrypt(ciphertext, key);
        res.json({ code: 0, data: plaintext });
    } catch (err) {
        res.status(500).json({ code: -1, error: err.message });
    }
});

// 监听本地回环地址,避免暴露公网
app.listen(18080, '127.0.0.1', () => {
    console.log('Decryption microservice running on port 18080');
});
Python 爬虫端仅需通过单例连接池发起 HTTP POST 请求:
# Python 端通过长连接调用常驻解密服务
import httpx

# 维持 HTTP Keep-Alive 连接池
client = httpx.Client(base_url="http://127.0.0.1:18080", timeout=5.0)

def decrypt_remote(cipher_text: str) -> str:
    response = client.post("/api/decrypt", json={"ciphertext": cipher_text, "key": "secret"})
    payload = response.json()
    if payload.get("code") == 0:
        return payload["data"]
raise RuntimeError(f"解密异常: {payload.get('error')}")| 方案类型 | 单次延迟 | 单机 QPS | Node生态兼容度 | 部署维护成本 |
|---|---|---|---|---|
| 嵌入式 (QuickJS) | < 1 ms | 1,500 ~ 3,000 | 仅支持纯 JS 基础库 | 极低(纯 Python wheel) |
| 子进程 (subprocess) | 50 ~ 120 ms | 10 ~ 25 | 完全兼容 | 低(仅需环境含 Node) |
| 常驻服务 (HTTP/RPC) | 1 ~ 3 ms | 2,000 ~ 5,000 | 完全兼容 | 中等(需维护守护进程) |
三、常见认知误区与辨析
在技术论坛或交流群中,常能见到一些被广泛流传但缺乏上下文限制的说法。理清这些观点的成立条件与技术盲区,能够避免很多排错弯路。
误区辨析 1:“只要逆向出了解密函数,直接用 PyExecJS 就是最佳解法”
看似合理之处:PyExecJS 接口封装简洁,只需要两行代码 execjs.compile(...) 和 ctx.call(...) 就能得到结果,在很多初级教程中被作为标准操作推荐。
局限与问题:PyExecJS 早已于官方停止维护。更致命的是其底层实现机制——在未显式优化时,它的每次 call 实际上是把 JS 代码与参数拼装成一个临时 .js 文件,再调用系统命令去跑一遍,本质依然是开销巨大的子进程启动;且在 Windows 下还会因默认调用 JScript 引擎而导致现代 ES6 语法全部报错。因此,在稍微追求爬取吞吐量与稳定性的项目中,切忌未经评估便将 PyExecJS 引入高频循环。
误区辨析 2:“补环境必须引入像 jsdom 这样的大而全仿真库”
看似合理之处:很多网站前端加密代码里充斥着对 window、document、navigator、location 等浏览器全局对象的读取,初学者认为全量模拟整个 DOM 树最为稳妥。
局限与问题:解密函数的本质是数学计算与数据流转换。很多加密脚本访问 navigator.userAgent 或 screen.width 仅仅是用作盐值(Salt)拼装或作为环境防篡改检测,并不需要真正的 DOM 布局计算引擎。全盘引入 jsdom 会导致启动速度变慢十倍以上、内存占用增加上百兆,并且 jsdom 自身的特征值本身也会被更高级的前端反爬指纹识别。正确的做法是使用最小桩代码,缺什么补什么。
四、浏览器“补环境”高级技巧与代理拦截
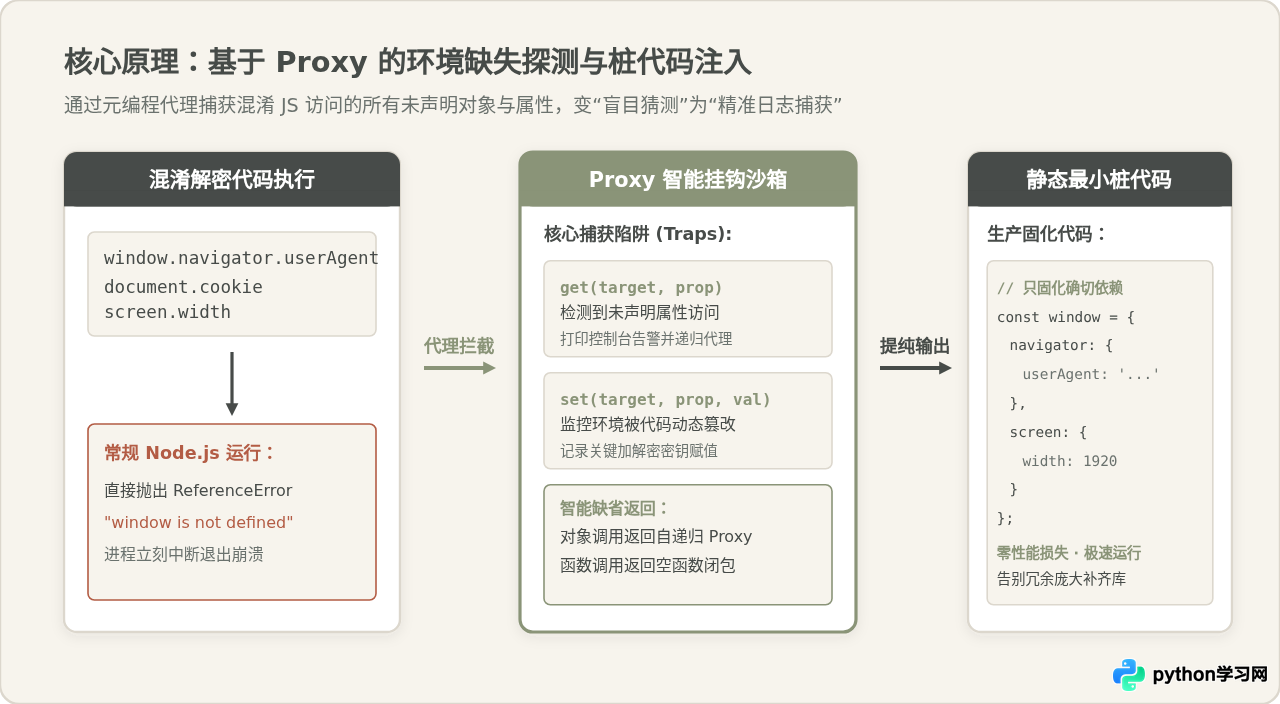
当执行解密函数提示 window is not defined 或 Cannot read properties of undefined (reading 'length') 时,意味着代码中触发了对宿主浏览器环境的检测。
1. 基于 Proxy 对象的环境探测器
在摸清混淆代码究竟读取了哪些浏览器属性前,不要盲目凭空手写桩对象。可以利用 ES6 Proxy 创建一个自省探测器,在 Node 环境头部注入:
// proxy_sniffer.js - 智能环境探测桩
function createEnvProxy(targetName, targetObj = {}) {
    return new Proxy(targetObj, {
        get(target, prop, receiver) {
            // 排除系统内部 symbols
            if (typeof prop === 'string') {
                console.log(`[ENV_GET] 访问了: ${targetName}.${prop}`);
            }
            if (prop in target) {
                return target[prop];
            }
            // 若访问的是下级对象,递归返回 Proxy 防止链式调用报 undefined
            return createEnvProxy(`${targetName}.${String(prop)}`);
        },
        set(target, prop, value) {
            console.log(`[ENV_SET] 赋值了: ${targetName}.${prop} = ${value}`);
            target[prop] = value;
            return true;
        }
    });
}

// 挂载全局全局伪造根
global.window = createEnvProxy('window');
global.document = createEnvProxy('document');
global.navigator = createEnvProxy('navigator', {
    userAgent: 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36',
    platform: 'Win32'
});
global.location = createEnvProxy('location', {
    href: 'https://target-domain.com/list',
    protocol: 'https:'
});
运行脚本后,控制台会清晰地打印出解密函数在运行瞬间触发的所有读取操作(例如 [ENV_GET] 访问了: window.screen.colorDepth)。随后,只需针对日志中记录的字段补上静态字典值,即可把动态 Proxy 替换为纯净的静态对象,兼顾通过率与运行速度。
五、工程化高可用避坑指南
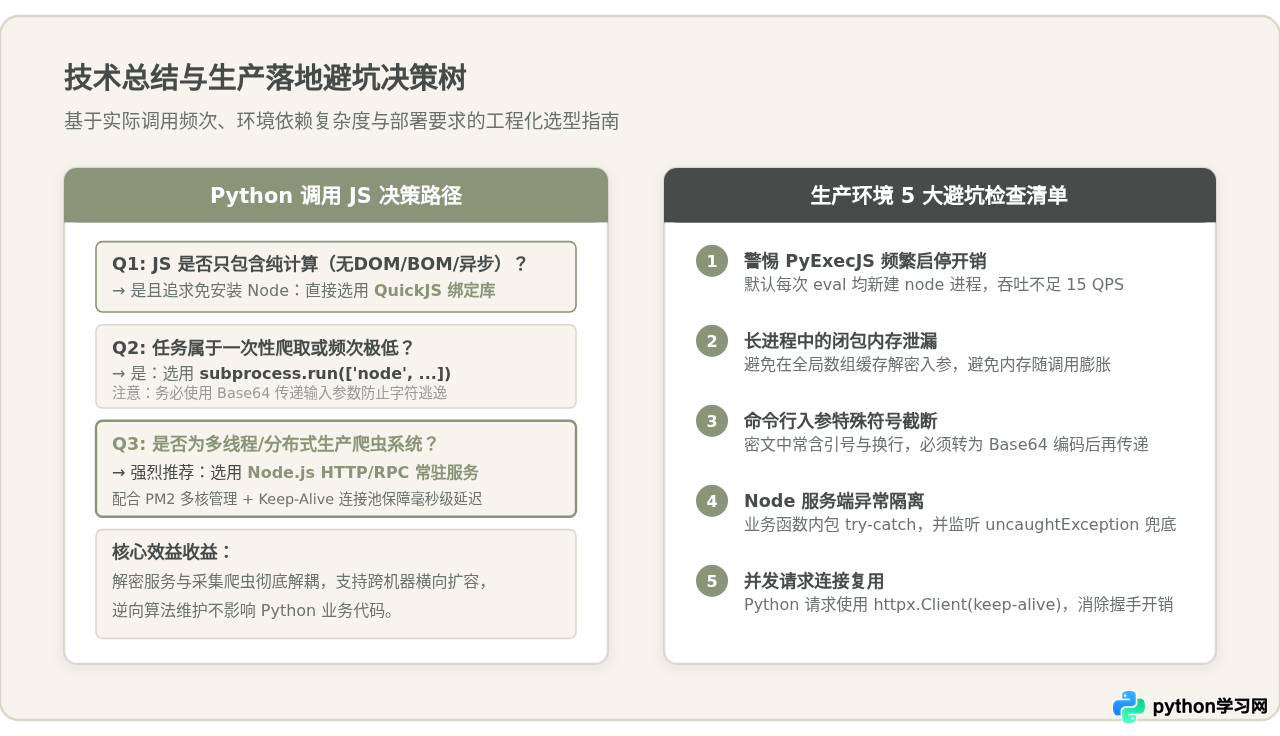
当解密服务在本地脚本调试通过后,转移到多线程并发与长时间运行的生产爬虫场景,仍有几处隐藏极深的工程陷阱。
1. 内存泄漏与全局变量污染
在常驻进程或微服务中,如果扣取的 JS 代码中包含全局数组或缓存对象(例如闭包内用于记忆化计算的 cache[key] = value),在长期爬取海量数据的过程中,该缓存会持续无界膨胀,导致 Node 进程内存溢出(OOM)崩溃。
解决方案:检查扣取的 JS 代码,将非必须的全局历史记录清除;在 Node 端使用 pm2 start server.js --max-memory-restart 500M 设定内存上限自动重启。
2. 参数传递的字符编码与转义防腐
逆向解密的入参通常是密文,其中可能包含 +、/、=、空格、单双引号甚至换行符。如果使用系统命令行传参,这些符号极易触发 Shell 转义错误或导致参数被意外截断。
解决方案:统一在 Python 端将待解密数据转为标准 Base64 字符串或 Hex 字节流传递,JS 端接收后显式解码,建立标准防腐层。
3. Python 端网络连接池与超时熔断
若采用 HTTP 方式调用本地解密服务,不要在每个任务函数内部临时构造新的 httpx.Client() 或 requests.Session()。频繁的新建连接会产生海量 TIME_WAIT 状态的 TCP 端口。务必在全局共享连接池对象,并针对每次解密调用设定严格的超时阈值(如 2.0 秒),防止某个损坏的密文使 JS 算法陷入死循环进而拖垮整个爬虫采集管道。
总结
在爬虫逆向项目中,通过 Python 调度 JavaScript 解密函数是一套以最低工程成本解决复杂反爬的标准工程模式。总结其实施核心要点:
- 断点先行,代码剪枝:先在控制台验证无误,脱敏并剔除无关渲染逻辑,不把未经验证的代码带入 Python 端。
- 按需选型,生产分离:单机轻量无依赖任务选 QuickJS;高并发与分布式架构务必搭建 Node.js 常驻微服务。
- 精简补齐,元编程排错:善用 Proxy 拦截器精准抓取缺失字段,坚守最小化补环境原则,避免引入重型环境模拟库。
- 严防泄漏,强化防腐:通过 Base64 编码规避特殊字符截断,建立完善的超时重试与内存保护防线。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









