

Python官方中文文档翻译不全怎么办?中英文对照阅读建议
针对Python官方中文文档部分内容未翻译、滞后或术语晦涩的问题,系统介绍URL快速切换、分屏中英对照、专有词汇对照心智以及实用辅助工具与阅读流,帮助开发者高效、准确掌握Python核心知识。
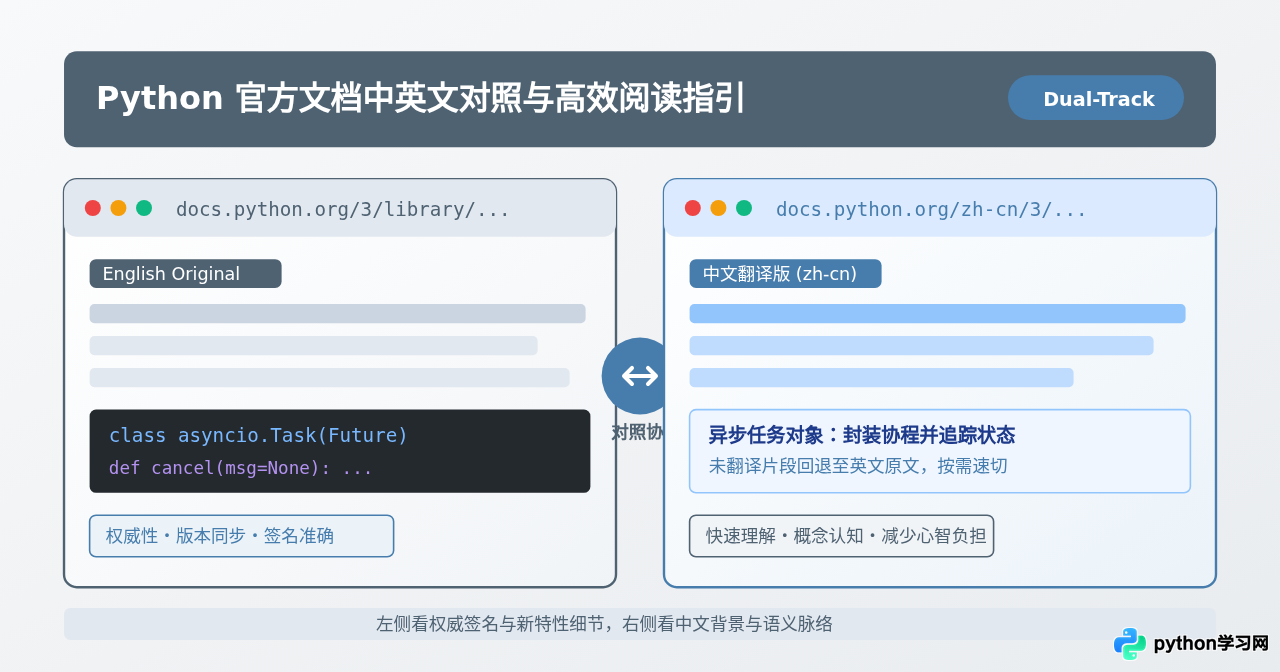
为什么官方中文文档会有未翻译内容?
Python 官方中文文档(位于 docs.python.org/zh-cn/)并非由专职商业团队集中维护,而是由 Python 官方社区志愿者通过 Transifex 等协同翻译平台持续推动的开源项目。理解其背后的组织机制,有助于建立合理的阅读预期:
- 快速迭代导致的内容差:每当 Python 发布新版本(如 3.12 或 3.13),核心开发团队会新增或重构大量文档(例如新增语法、改动内置库说明)。这些变更会先直接合入主干英文仓库,中文翻译跟进必然存在时间窗口。
- 自动化兜底机制:Python 官方文档构建系统采用了静默兜底策略。如果某个段落(msgid)在中文翻译库中尚未完成翻译或处于待审核状态,编译工具链不会将页面留空,而是直接渲染对应的英文原文。这就是页面中经常“中英夹杂”的直接原因。
- 文档模块优先级差异:社区通常优先翻译《Python 教程》(Tutorial)和常用高频模块(如
os、json、sys、datetime),而像底层 C API 参考手册、底层网络协议细节或大型过时长篇模块,翻译推进相对缓慢。
方法一:掌握 URL 规律与界面切换
面对未翻译的段落,最直接的动作是快速跳转到英文原版,核对该段落的前后上下文及参数列表。Python 官方文档的路径规则高度标准化,完全无需重新通过搜索引擎查找对应页面。
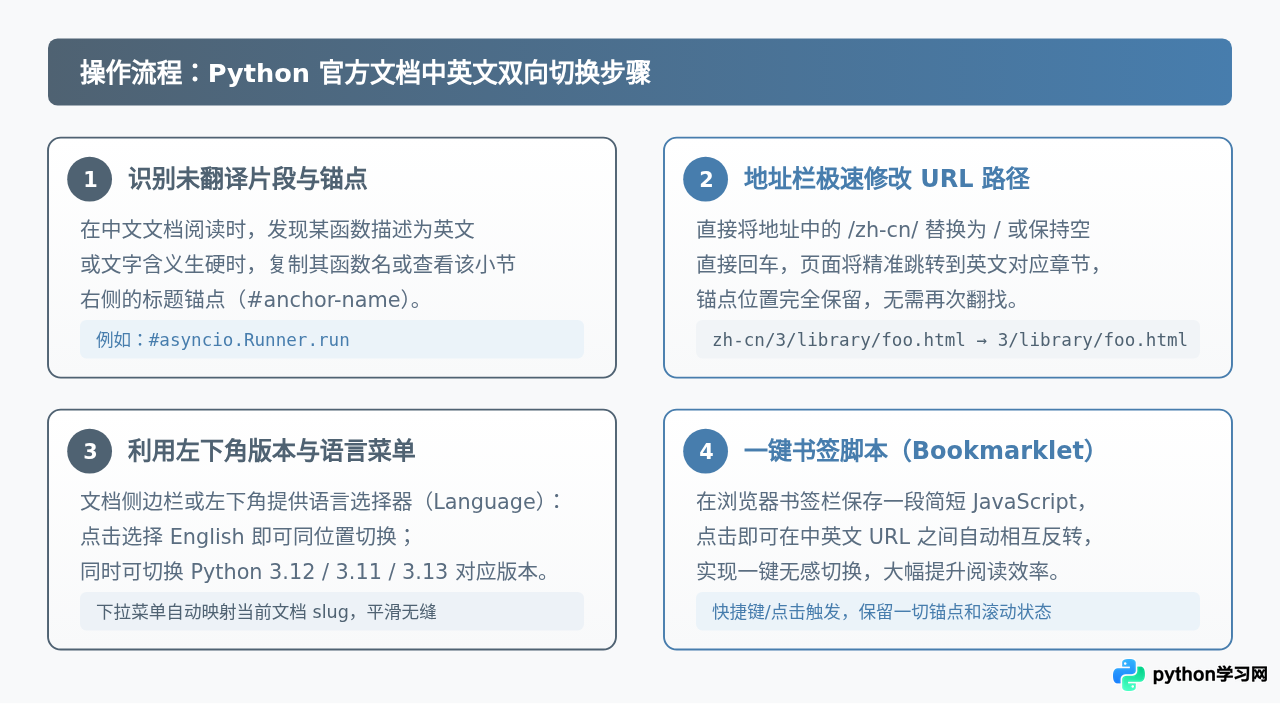
实用的双向切换书签脚本
可以在浏览器书签栏中新建一个书签,名称设置为“中英文档切换”,地址(URL)填入以下 JavaScript 代码:
javascript:(function(){
  var url = window.location.href;
  if(url.indexOf('/zh-cn/') !== -1){
    window.location.href = url.replace('/zh-cn/', '/');
  } else if(url.indexOf('docs.python.org/') !== -1){
    window.location.href = url.replace('docs.python.org/', 'docs.python.org/zh-cn/');
  }
})();
当阅读中文文档遇到未翻译的生硬句子时,只需点击一下该书签,浏览器会立即保持当前页面的锚点并切换到英文页面;再点一次即可切回中文。
方法二:分屏并排对照阅读架构
对于深入学习内置模块(如 asyncio、multiprocessing 或 typing)等复杂度较高的内容,单页来回切换容易打断思路。此时最推荐的做法是“双栏分屏”阅读。
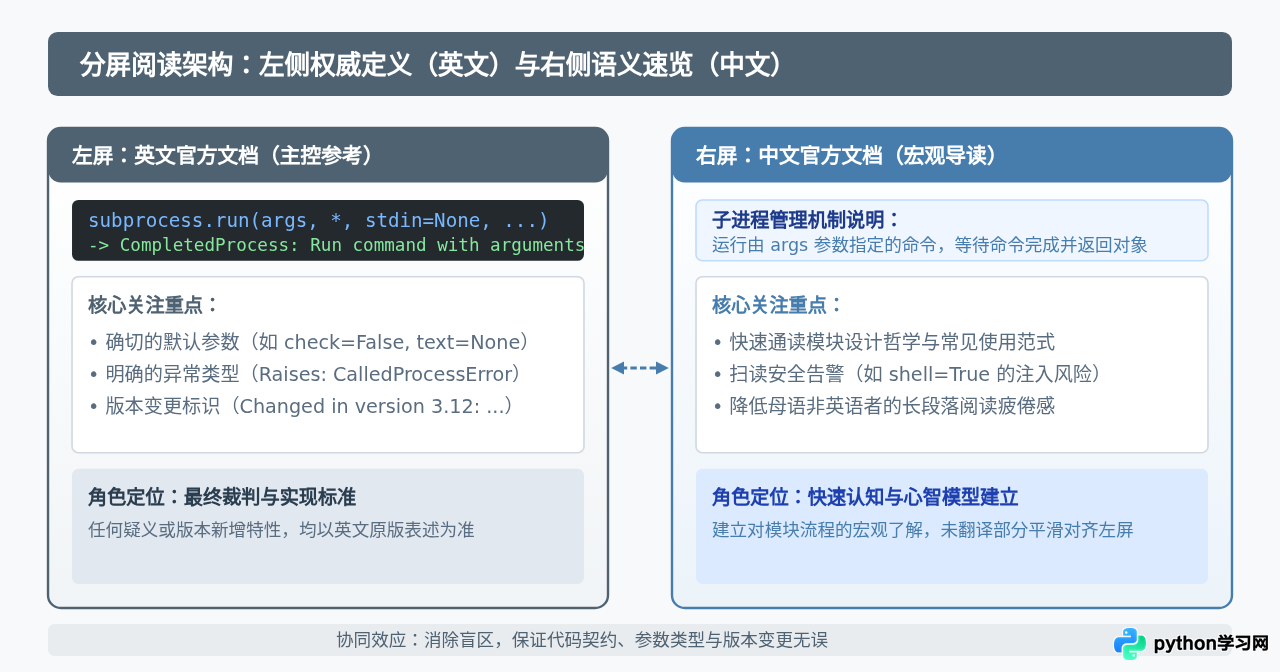
这种分工的实际优势在于:
- 速度与准确性兼得:用中文快速扫读段落大意,理解“为什么要设计这个类”和“常规用法是什么”;当看到方法签名、关键参数及返回值时,目光自然移至左侧英文原版,核对确切的类型注解与边界情况。
- 自动消除未翻译空缺:右侧即便遇到大段未翻译的英文,由于左侧本来就处于同一行位置,读者的大脑不会产生“卡顿感”,直接在左侧连续阅读即可。
- 避免翻译理解偏差:部分专业术语在中文版中可能存在前后不一致(例如
mapping有时译为“映射”,有时译为“键值对集合”),对照英文能第一时间恢复其标准语义。
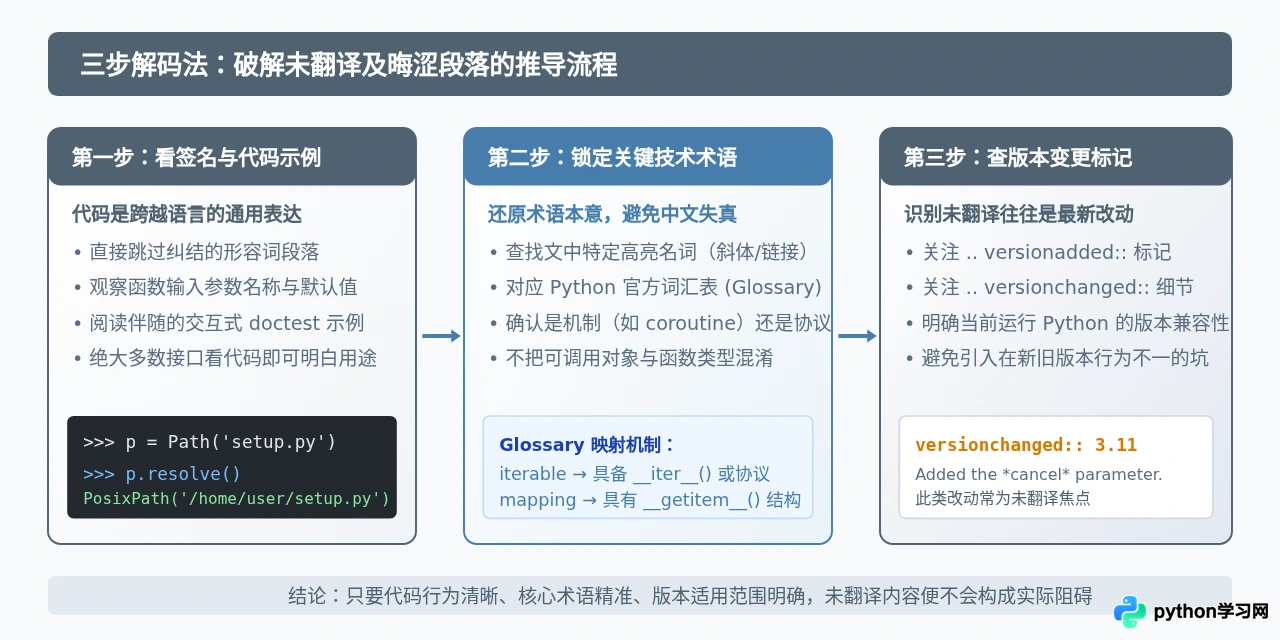
方法三:遇到断档或生硬翻译时的三步解码法
当文档中某一关键章节未翻译或翻译腔极重时,不要强行字面翻译。遵循以下三步排查逻辑,可以迅速理清其真实含义:
重点术语中英文心智对照表
很多开发者觉得 Python 文档晦涩,往往不是英语语法难,而是对文档中特定抽象词汇在 Python 体系里的指代不熟悉。建议熟记以下常见核心术语的真实内涵:
| 英文术语 | 常见中文翻译 | 在 Python 文档中的实际指代与契约 | 阅读建议 |
|---|---|---|---|
iterable |
可迭代对象 | 实现了 __iter__() 方法或支持序列协议(包含 __getitem__() 且索引从 0 起始)的对象,可被 for 循环消费。 |
优先使用英文原生概念,不要与序列(sequence)划等号。 |
generator vs iterator |
生成器 与 迭代器 | 生成器是利用 yield 语法或生成器表达式构造的特殊迭代器;所有生成器都是迭代器,但迭代器可以手动写类实现 __next__()。 |
注意文档中对返回值的区分,生成器仅能单次遍历。 |
callable |
可调用对象 | 函数、方法、lambda,或者实现了 __call__() 方法的类的实例。 |
文档写 callable 时切勿仅传入函数名称,类实例同样合法。 |
mapping |
映射 / 字典式对象 | 支持键查找(实现了 __getitem__、__len__ 等)的容器,不仅包含 dict,还包括 MappingProxyType 等。 |
见到参数要求 mapping,说明传入自定义字典兼容类即可。 |
positional-only |
仅限位置参数 | 函数签名中斜杠 / 之前的参数,调用时只能按位置传参,不能传入关键字参数。 |
在官方文档签名中看到 / 时,直接对应此规则。 |
keyword-only |
仅限关键字参数 | 函数签名中星号 * 之后的参数,调用时必须显式写出 name=value。 |
经常出现在标准库方法的可选配置参数中。 |
dunder method |
双下划线方法 / 魔术方法 | 以双下划线开头并结尾的方法(如 __init__、__repr__)。 |
官方英文文档常直呼 dunder,看到该词直接对应内部钩子。 |
方法四:善用浏览器辅助工具与现代双语增强
除了手动比对,借助现代浏览器扩展可以极大提升中英对照的流畅度:
- 双语段落穿插插件:使用支持“译文与原文并排/上下对照”的浏览器插件(如沉浸式翻译等)。在浏览官方英文原版页面时,直接开启双语对照,它会自动在每一个英文段落下方渲染中文,既保留了英文原文的排版与代码签名,又享有即时中文翻译,完美补齐了官方中文文档未翻译的空洞。
- 划词悬浮释义:在阅读英文文档时,配置一个轻量级的划词翻译扩展。遇到生僻词汇或长难句只需鼠标一扫,无须切出当前工作流。
- 官方文档离线包(Dash / Zeal):对于喜欢本地查阅的开发者,Dash(macOS)或 Zeal(Windows/Linux)内置的 Python 官方文档索引非常完整。其搜索能够精确命中每一个类和函数,虽然多为英文,但结合本地翻译工具可实现毫秒级跳转。
<pre> 和 <code> 标签内的 Python 标识符、关键字、参数名甚至变量名直接翻译成中文(例如将 def run(self): 翻译成 定义 运行(自己):)。这会导致示例代码完全无法运行。请务必使用支持代码块保护的中英对照插件,或优先采用本文建议的官方 URL/分屏对照方式。
总结:高效中英文对照阅读决策指南
最后,我们将不同的阅读需求与对应的最佳处理策略进行归纳总结,帮助你在日常开发与深入学习中快速选择最优路径:
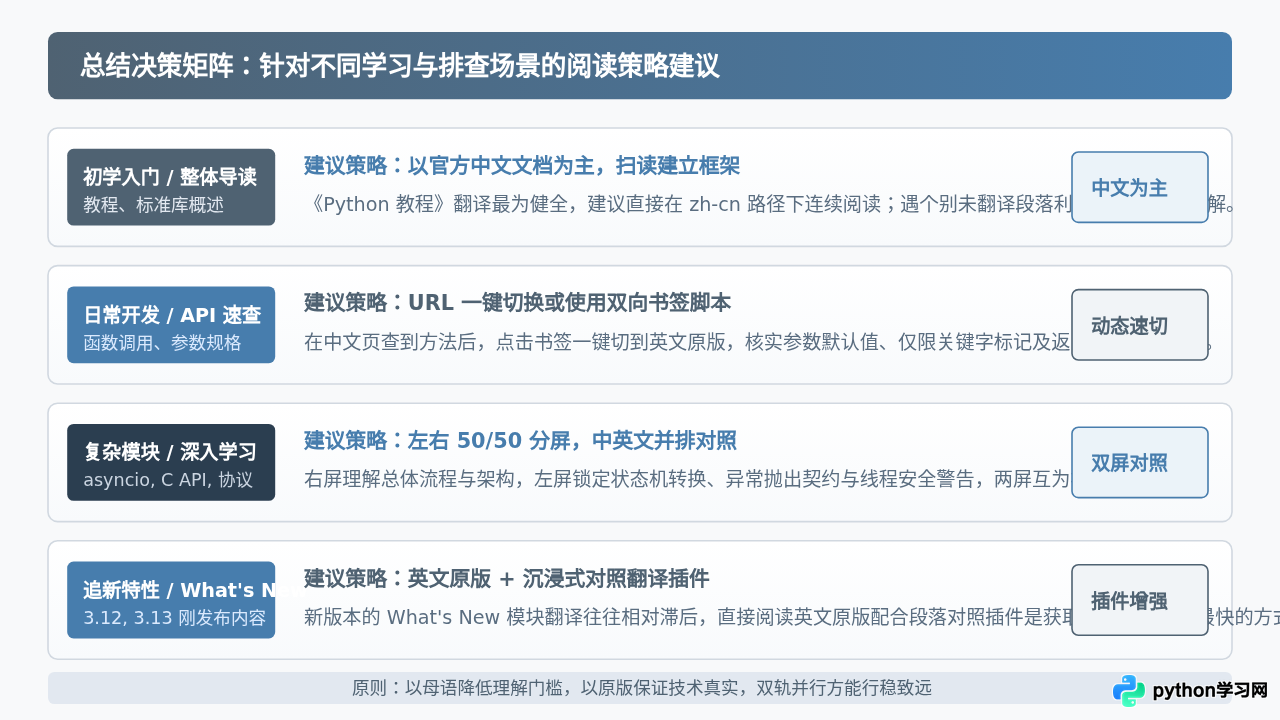
面对 Python 官方中文文档翻译不全的现状,不必焦虑等待,也不必对英文技术文档望而生畏。将 URL 快速切换、分屏排版与核心术语表融入日常查阅习惯中,既能充分享受中文母语带来的高效概览,又能依托英文原版保证代码调用的精确与严密,从而建立起稳固扎实的技术认知体系。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









