

Python负数索引与步长技巧:实现序列反转与间隔截取
深入解析Python序列的负数索引映射与切片步长机制,掌握序列反转、间隔采样、边界条件与避坑指南。
一、双向索引系统:负数索引的工作原理
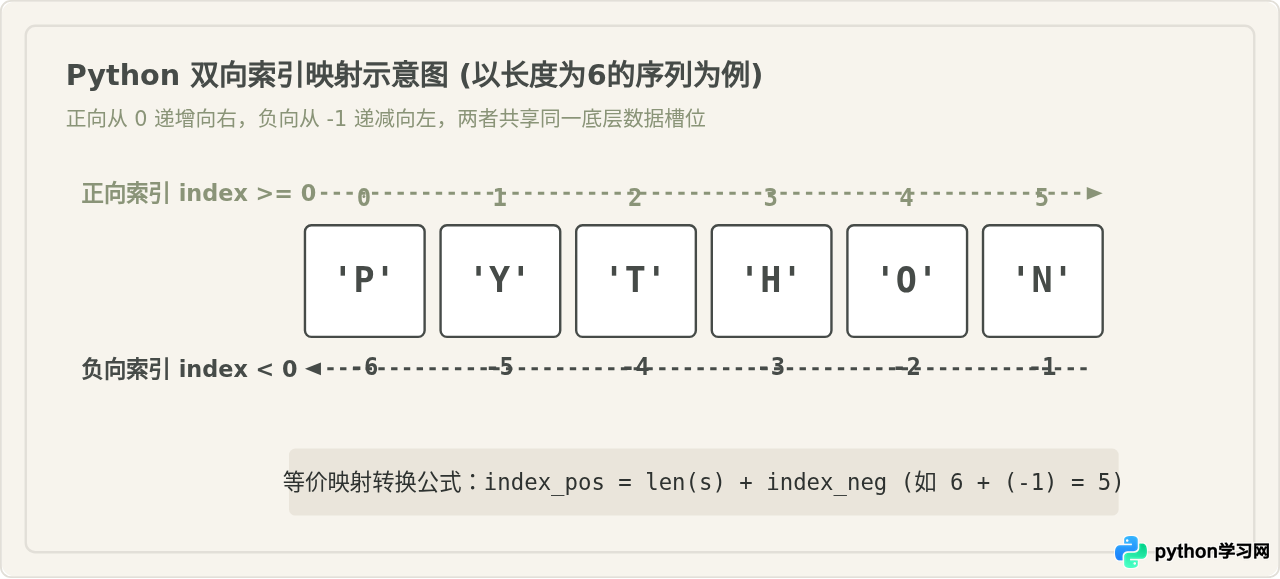
Python 的内置有序序列(如 str、list、tuple 等)拥有天然的双向索引映射。正数索引从左端开始计数,首元素下标为 0;负数索引则从右端开始逆向定位,末尾元素的下标固定为 -1。
在底层计算中,负数索引 k 并非全新的寻址逻辑,而是正向绝对索引的语法糖。当解释器接收到负索引 k 时,实际计算的物理偏移量为 len(sequence) + k。例如对于一个长度为 6 的列表,访问 seq[-1] 等价于访问 seq[6 + (-1)] 即 seq[5];访问首元素的负索引则是 seq[-6]。
在日常编写中,单元素取值如果越界,会立刻触发 IndexError: string index out of range。但在切片语法中,这一规则将发生显著变化。
二、切片全语法剖析:start、stop 与 step 的求值过程
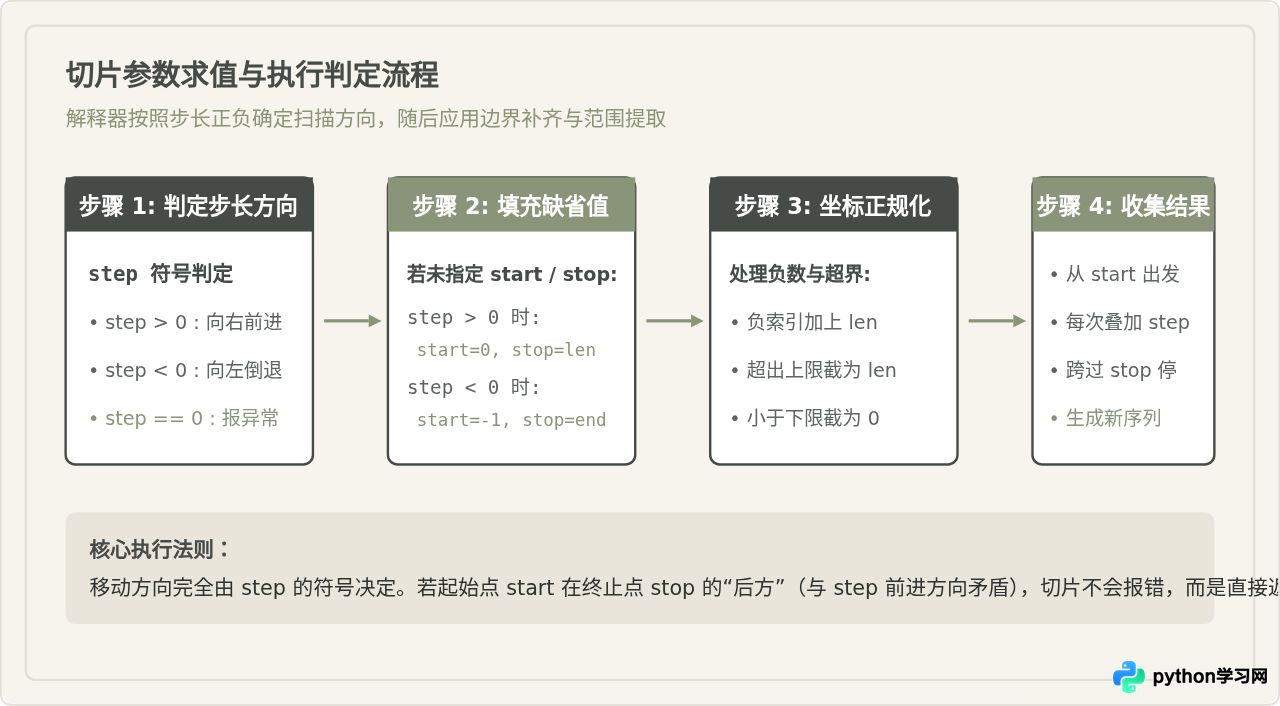
切片完整语法为 sequence[start:stop:step],代表从 start 索引开始,以 step 为跨步长度,向 stop 方向前进,并遵循前闭后开(包含 start,不包含 stop)的截取原则。
每个参数如果缺省(留空),解释器会根据 step 的正负号决定默认边界:
- 当 step > 0 时(正向步进):默认遍历方向为从左向右。
start缺省为0;stop缺省为len(sequence)。 - 当 step < 0 时(逆向步进):默认遍历方向为从右向左。
start缺省为-1(即末尾元素);stop缺省为序列最左端之前的位置(可以完整包含索引 0 处的元素)。
三、技巧一:序列反转的实现与常见死角
在日常开发中,对序列进行纯粹的逆序排列,最地道的 Pythonic 写法是:
# 示例代码:全量反转
text = "ABCDEFG"
reversed_text = text[::-1]
print(reversed_text)  # 示例输出: 'GFEDCBA'

numbers = [1, 2, 3, 4, 5]
reversed_nums = numbers[::-1]
print(reversed_nums)  # 示例输出: [5, 4, 3, 2, 1]
常见陷阱:指定 stop 为 0 导致首字符丢失
初学者容易产生一个直觉误区:“既然是从最右往最左截取,那么起始是 -1,终止点是索引 0,写成 text[-1:0:-1] 应该就包含了完整反转。”
通过执行测试,这一写法并不能得到预期结果:
# 错误直觉示例
text = "PYTHON"
result = text[-1:0:-1]
print(result) # 示例输出: 'NOHTY' (缺失了索引 0 处的 'P'!)原因剖析:切片遵循“前闭后开”区间,stop=0 意味着在索引即将到达 0 时提前终止,因此索引 0 处的元素永远不会被读取。为了完整反转到序列开头,必须将 stop 保持缺省(即写作 text[::-1] 或 text[-1::-1]),让解释器自动将终止边界扩展到序列最左端之外。
四、技巧二:步长间隔截取与正逆向采样
步长不仅可以用来反转方向,其绝对值大小决定了采样的间距。当 abs(step) > 1 时,序列实现等间距抽样。
1. 奇偶位置提取(正向采样)
利用缺省起始点,能够非常高效地提取偶数位或奇数位索引元素:
data = [0, 1, 2, 3, 4, 5, 6, 7, 8, 9]

# 提取偶数索引位置元素(0, 2, 4, 6, 8)
evens = data[::2]
print(evens)  # 示例输出: [0, 2, 4, 6, 8]

# 提取奇数索引位置元素(从索引 1 开始,1, 3, 5, 7, 9)
odds = data[1::2]
print(odds)   # 示例输出: [1, 3, 5, 7, 9]
2. 倒序跳跃截取(逆向采样)
当负步长与绝对值大于 1 结合时,可以实现从后向前的高效跳跃采样。例如 s[::-2] 表示从末尾元素出发,倒序每隔一个元素采样一次:
data = [0, 1, 2, 3, 4, 5, 6, 7]
# 从 7 开始,逆向每次后退 2 步,依次获取索引 7, 5, 3, 1
rev_step = data[::-2]
print(rev_step)  # 示例输出: [7, 5, 3, 1]

# 指定区间的反向采样:从索引 6 倒退截取到索引 1(不含 1)
partial_rev = data[6:1:-2]
print(partial_rev)  # 示例输出: [6, 4, 2]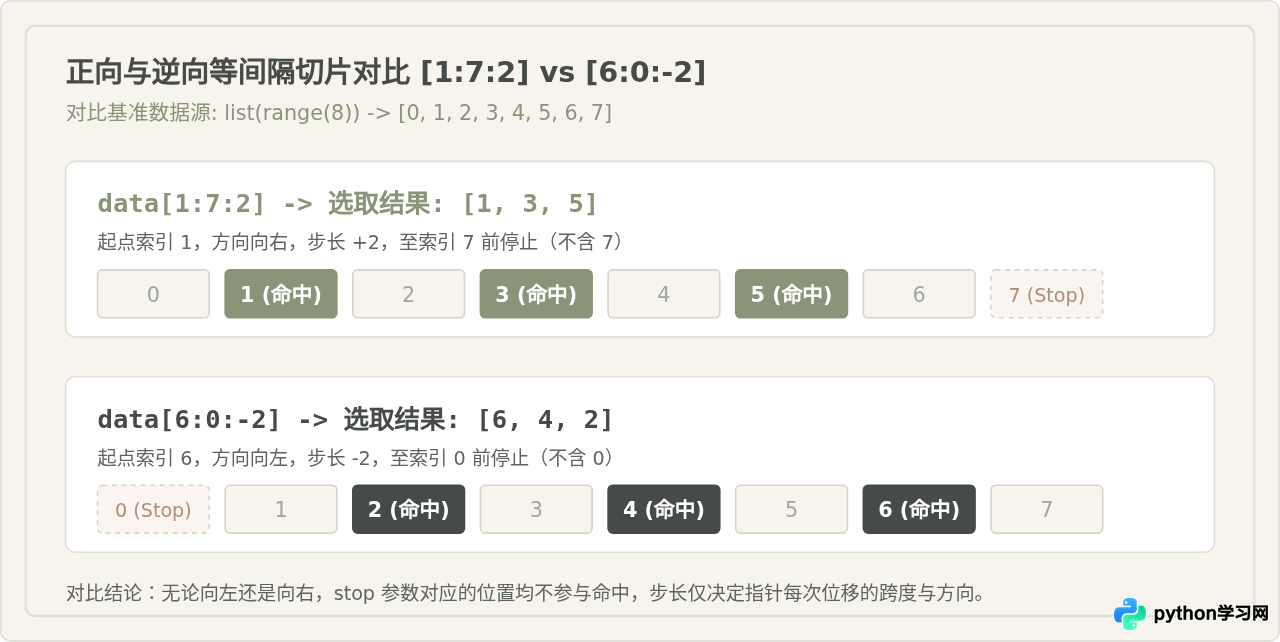
五、容易混淆的边界与高频问题排查
1. 切片为什么永远不会抛出 IndexError?
初学者常疑惑:为什么 s[100] 会崩溃报错,而 s[100:200] 却安全返回空列表 []?
这是 Python 语言设计上的有意权衡:单个索引访问代表对具体数据的精确引用,找不到该项必须作为程序逻辑异常抛出;而切片操作代表在一段连续区域中筛选子集,当请求的范围超出序列的有效范围时,解释器会自动将其截断(clamp)在 [0, len(sequence)] 边界内。没有重叠交集即返回空容器,从而提升切片处理变长输入时的健壮性。
2. 为什么写了切片却得到空列表?
遇到切片结果为空时,95% 以上的原因在于 start、stop 与 step 的方向产生矛盾:
s[5:2]:步长默认为+1(向右找),但起点 5 在 2 的右侧,向右走永远无法到达 2,立即终止返回空;s[2:5:-1]:步长为-1(向左找),但起点 2 在 5 的左侧,向左走无法到达 5,同样直接返回空。
• 当
step > 0 时,必须保证 start < stop 才能取到元素;• 当
step < 0 时,必须保证 start > stop 才能取到元素。
六、方法对比与选型建议
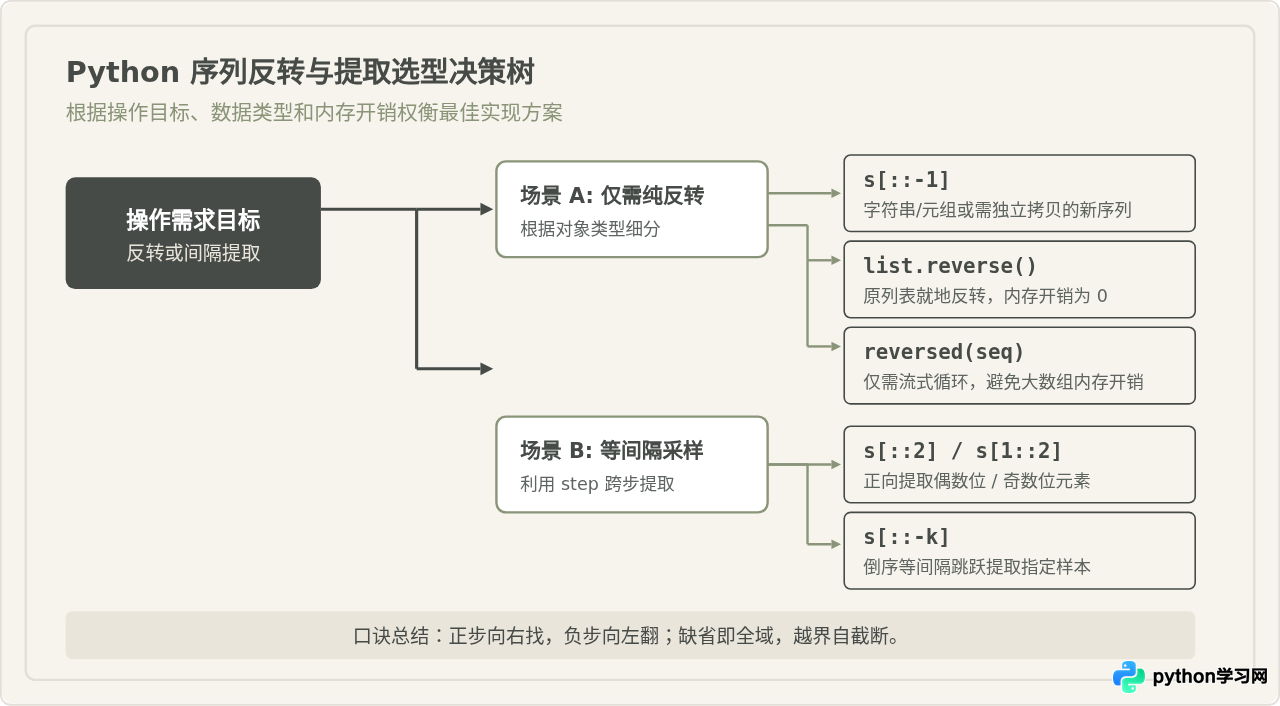
反转序列或提取数据有多种现成手段。选择哪种方法主要取决于对象的可变性与内存消耗要求:
| 方案 | 适用对象 | 操作类型 | 内存占用 | 核心优势与适用场景 |
|---|---|---|---|---|
s[::-1] |
str, list, tuple | 切片复制 | 新对象浅拷贝 | 单行表达式,支持不可变对象(字符串、元组),代码极其紧凑。 |
reversed(s) |
任意序列或可迭代对象 | 惰性迭代器 | O(1) 无额外数据拷贝 | 仅用于 for 循环逐项遍历,避免大列表全量复制造成内存浪费。 |
list.reverse() |
仅限 list |
原地修改 | O(1) 原地就地置换 | 在原列表上直接翻转,返回 None,处理超大列表且不需要原数据时的最佳选择。 |
七、总结
Python 切片语法的精炼源自其统一的底层规则:
- 负数索引是相对序列末尾的位移量,等价于
len(s) + index。 - 步长 step 同时掌控前进方向与采样间隔。正步长从左向右推进,负步长从右向左推进。
- 全量反转推荐直接使用
sequence[::-1];若要手动指定边界,切记stop处于不可达开区间,反向遍历至头部时切勿将stop误设为0。
理解这套确定性的推导机制,不仅能写出干净优雅的单行代码,也能在处理大量数据截取时避免隐蔽的边界偏差。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









