

Python DDT库中@data与@unpack装饰器的基础用法
详细讲解Python unittest生态中ddt库的核心装饰器@data与@unpack的基础用法,涵盖单值注入、多参数解包、列表元组及字典解包机制、操作步骤与常见排错技巧。
在 Python 的单元测试实践中,如果需要对同一个方法使用多组不同的测试数据进行断言,编写大量重复的测试用例函数不仅繁琐,而且难以维护。Python 标准库自带的 unittest 本身没有内置直观的参数化机制,而第三方库 ddt(Data-Driven Tests)恰好补充了这一能力。通过类装饰器 @ddt 与方法装饰器 @data、@unpack 的配合,我们可以直接将一组或多组测试数据集注入到测试函数中,实现清晰、高效的数据驱动测试。本文将直奔核心用法,详细解析 @data 与 @unpack 的职责分工、数据映射逻辑与常见注意事项。
一、DDT 核心概念与装饰器职责分工
在 ddt 库中,实现参数化测试主要依赖三个装饰器:
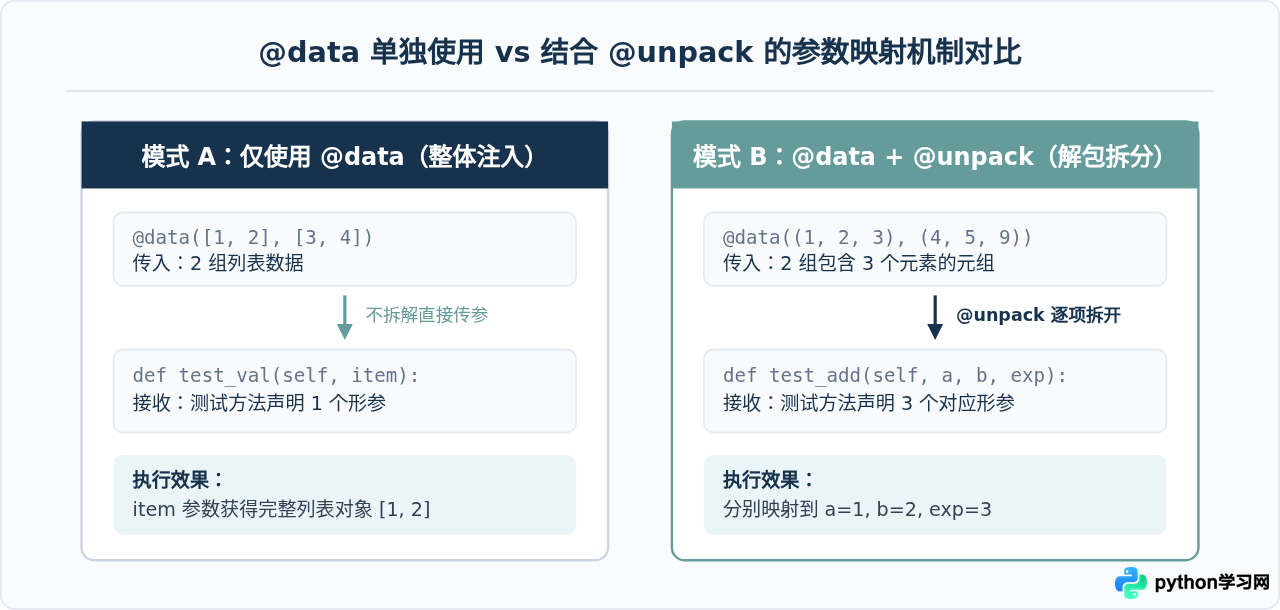
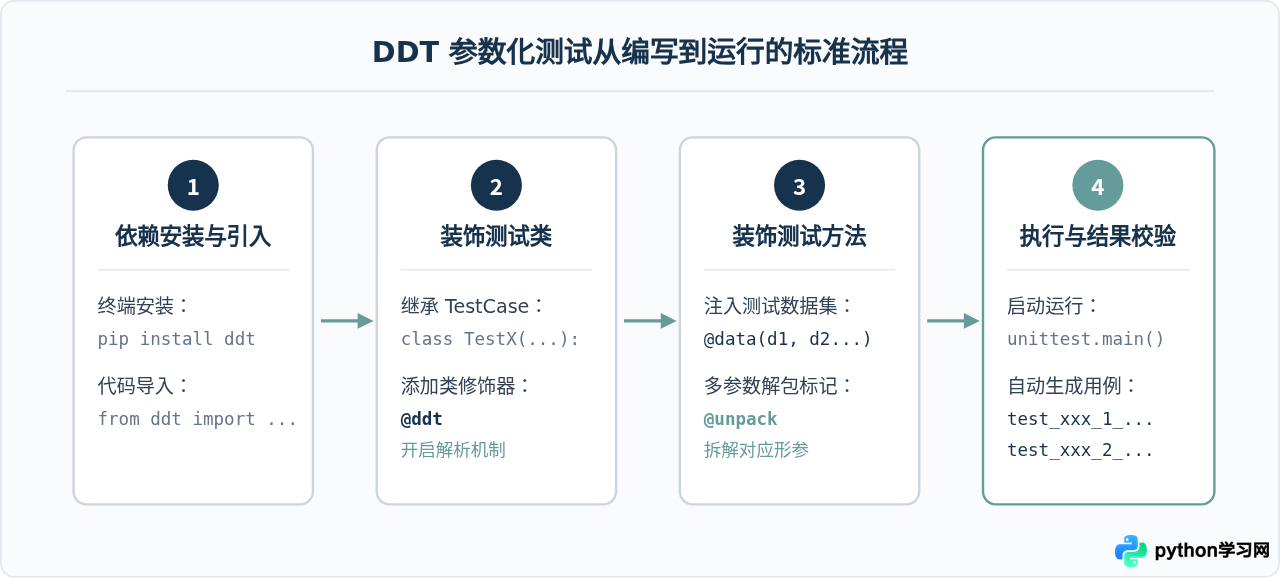
@ddt.ddt(类装饰器):必须标注在继承了unittest.TestCase的测试类上方。它的作用是在测试类加载时扫描类内部被数据装饰的方法,并根据传入的数据动态生成独立的测试用例。@ddt.data(方法装饰器):用于向被修饰的测试方法中注入实际数据。它可以接收任意数量的实参,每个实参代表一组独立的测试数据。ddt会为传入的每一组数据生成一个对应的测试用例。@ddt.unpack(方法装饰器):必须配合@data使用。当@data传入的每组测试数据本身是容器对象(如元组、列表或字典)时,@unpack会将容器中的元素拆解为多个独立参数,分别传递给测试方法的各个形参。
二、@data 装饰器的单独使用场景
在很多基础测试场景中,待测方法只需要一个输入参数(例如检查数字是否为偶数、验证手机号格式、传入单个标识符等)。此时只需要使用 @data 即可,不需要加 @unpack。
1. 单一参数传递(标量值)
当 @data 接收多个单值实参(例如整数、浮点数、字符串)时,测试方法必须定义除了 self 之外的刚好一个形参。每个实参会单独触发一次测试执行:
import unittest
from ddt import ddt, data

@ddt
class TestSingleValue(unittest.TestCase):

    # 传入 3 个独立数据,将生成 3 个独立测试用例
    @data(10, 25, 40)
    def test_greater_than_zero(self, value):
        self.assertGreater(value, 0)

if __name__ == "__main__":
    unittest.main()
运行上述代码时,测试框架会执行 3 次断言,测试报告中会清晰显示类似 test_greater_than_zero_1_10、test_greater_than_zero_2_25、test_greater_than_zero_3_40 的执行结果。
2. 复合结构不解包(作为单一对象传递)
如果传入的数据本身是一个列表、集合或自定义对象,并且测试方法希望直接把这个集合作为一个整体进行断言,那么同样不需要加 @unpack:
    @data([1, 2, 3], [4, 5, 6, 7])
    def test_list_not_empty(self, data_list):
        # data_list 整体接收列表对象
        self.assertTrue(len(data_list) > 0)
如果不加 @unpack,即使传入的是包含多个元素的列表或元组,测试方法也只应该声明一个参数来接收这个容器整体。
三、@data 配合 @unpack 装饰器的解包机制
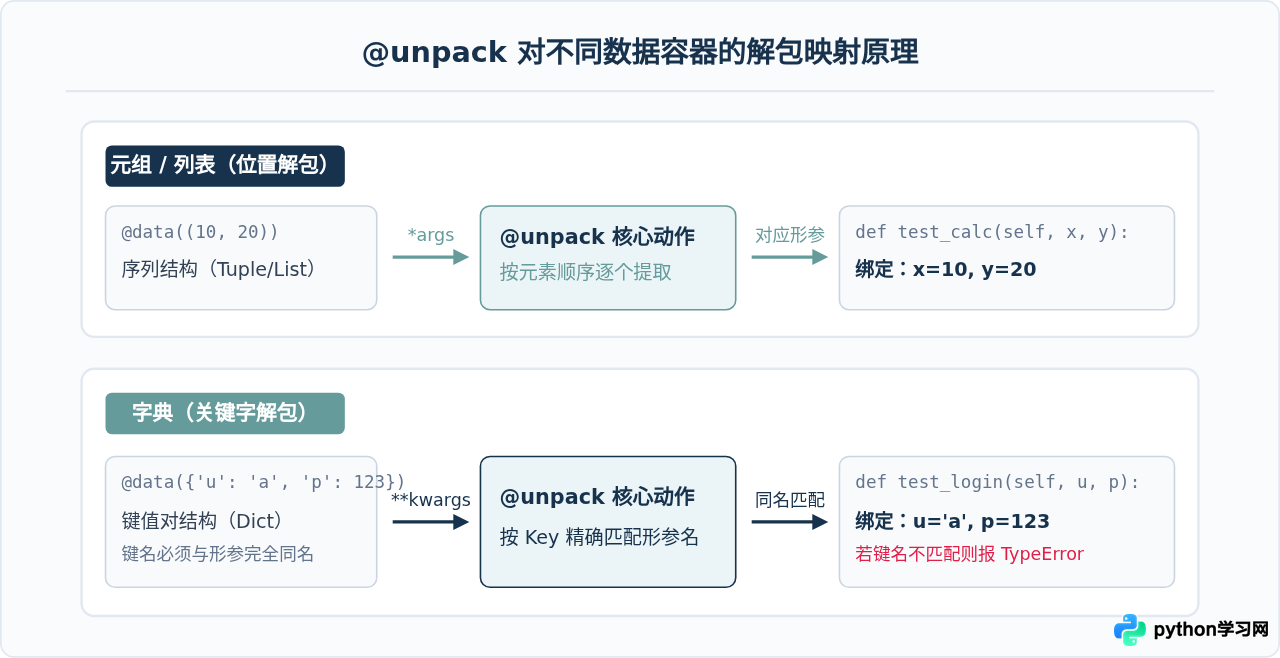
在更多业务测试中,一组用例通常包含“输入参数 1、输入参数 2、预期结果”等多个字段。如果直接传入元组,测试方法内部就必须写 item[0]、item[1] 这样晦涩的下标取值,代码可读性很差。@unpack 的核心价值就在于:自动将容器解构成具有明确语义的函数形参。
1. 解包元组(Tuple)或列表(List)
这是最常见的解包模式。元组或列表中的元素按照定义顺序,一一对应传给函数的形参(类似于 Python 内置的 *args 解包机制)。
import unittest
from ddt import ddt, data, unpack

@ddt
class TestAddition(unittest.TestCase):

    # 每一组元组包含 3 个元素:a, b, expected
    @data(
        (1, 2, 3),
        (5, 5, 10),
        (-1, 1, 0)
    )
    @unpack
    def test_add(self, a, b, expected):
        # 参数被分别解包,直接使用具名形参断言
        result = a + b
        self.assertEqual(result, expected)
注意:在声明测试方法时,形参的数量必须与每个元组包含的元素个数完全一致。如果元组有 3 个元素,而方法只定义了 2 个参数,运行阶段会立即抛出 TypeError。
2. 解包字典(Dictionary)
当测试数据字段较多,或者顺序可能调换时,使用字典传参更加清晰。当 @unpack 遇到字典时,采用类似 **kwargs 的方式按键名(Key)寻找同名形参:
@ddt
class TestUserLogin(unittest.TestCase):

    @data(
        {"username": "admin", "role": "administrator", "is_active": True},
        {"username": "guest", "role": "visitor", "is_active": False}
    )
    @unpack
    def test_user_info(self, username, role, is_active):
        # 形参名称必须与字典中的 Key 完全一致
        self.assertIsInstance(username, str)
        self.assertIn(role, ["administrator", "visitor"])
self.assertIsInstance(is_active, bool)采用字典解包时,形参的顺序并不重要,但名称必须完全一致。如果字典里包含形参中未定义的键,或者形参中要求的名字字典里没有提供,同样会触发 TypeError。
四、标准使用流程与完整执行示例
理解了上述语法后,我们来看一个从环境安装到执行验证的完整操作流程。
1. 安装环境
在当前 Python 环境中通过 pip 执行安装命令:
pip install ddt2. 编写测试脚本(demo_ddt.py)
import unittest
from ddt import ddt, data, unpack

# 待测业务函数:字符串截断与拼接
def format_title(title, max_length=10):
    if len(title) > max_length:
        return title[:max_length] + "..."
    return title

@ddt
class TestFormatTitle(unittest.TestCase):

    # 包含边界值、正常值以及超长截断值的测试矩阵
    @data(
        ("Hello", 10, "Hello"),
        ("PythonProgramming", 6, "Python..."),
        ("DDT", 3, "DDT")
    )
    @unpack
    def test_format_title(self, raw_text, limit, expected):
        actual = format_title(raw_text, limit)
        self.assertEqual(actual, expected)

if __name__ == "__main__":
    unittest.main(verbosity=2)
3. 运行与输出结果分析
在终端执行该脚本后,输出示例如下:
test_format_title_1_Hello (__main__.TestFormatTitle) ... ok
test_format_title_2_PythonProgramming (__main__.TestFormatTitle) ... ok
test_format_title_3_DDT (__main__.TestFormatTitle) ... ok

----------------------------------------------------------------------
Ran 3 tests in 0.002s

OK
从输出中可以看到,虽然源程序中只写了一个 def test_format_title 方法,但 ddt 在加载时根据 @data 中给出的 3 组数据,自动扩充并注册了 3 个独立的测试用例。如果其中某一组数据断言失败,其他两组用例仍会正常执行,互不影响。
五、常见问题排查与避坑指南
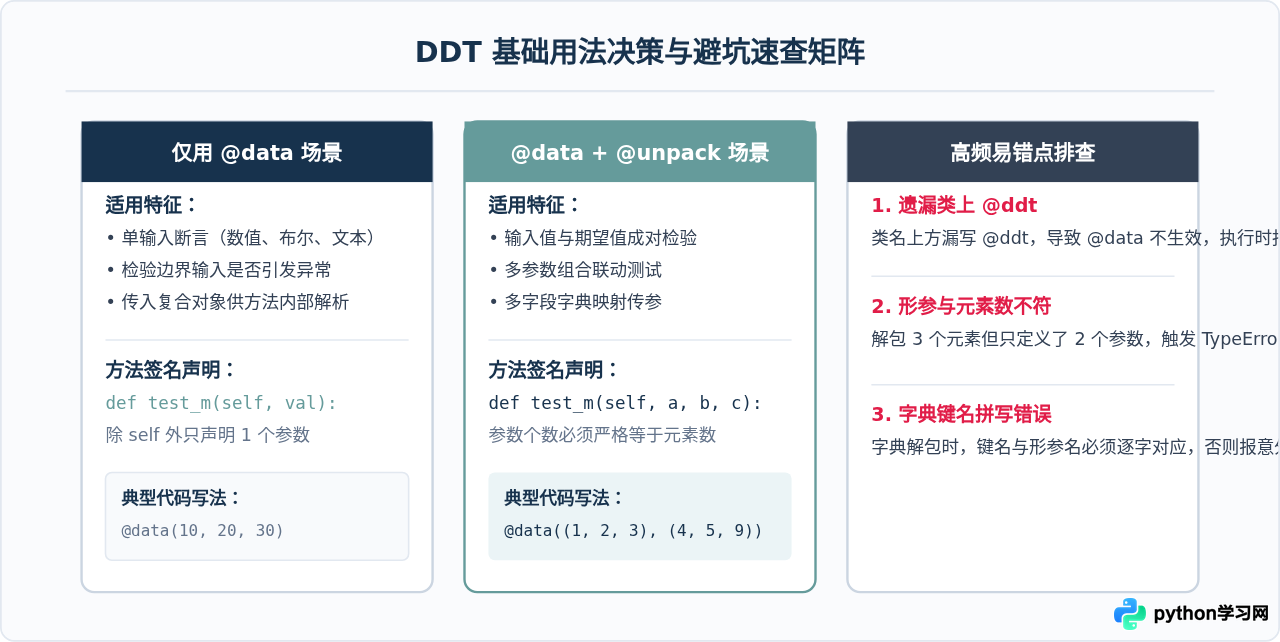
1. 遗漏测试类顶部的 @ddt 装饰器
这是初学者最容易遇到的错误。如果在测试方法上标注了 @data 和 @unpack,但忘记在测试类上方标注 @ddt,unittest 在发现该用例时会把它当作普通方法加载,导致执行时报错:
TypeError: test_xxx() missing required positional argument: ...排查方法:检查 class TestSomething(unittest.TestCase): 正上方是否有 @ddt。
2. 解包元素数量与方法形参数量不一致
当使用 @unpack 解包元组或列表时,@data 传入的每个容器所包含的元素个数必须是恒定的,且与方法签名一致。例如:
    # 错误示范:第二组数据只有 2 个元素
    @data((1, 2, 3), (4, 5))
    @unpack
    def test_example(self, a, b, c):
        pass
当执行到第二组数据 (4, 5) 时,Python 会报 TypeError: test_example() missing 1 required positional argument: 'c'。务必保证同一参数化方法下的每组数据结构完全对称。
3. 字典解包时出现形参不匹配
解包字典本质是关键字解包。若字典内包含方法不需要的键,或缺少方法必需的形参,会引发 unexpected keyword argument 错误。如果字典中某些字段可选,可以在测试方法定义中使用默认参数:
    @data(
        {"host": "127.0.0.1", "port": 8080},
        {"host": "localhost"}  # 缺少 port 键
    )
    @unpack
    def test_connect(self, host, port=80):
        # 通过默认参数避免缺少键导致的 TypeError
        self.assertIsNotNone(host)
六、总结
ddt 为 unittest 带来了清晰的数据驱动实现方案。在实际开发与测试过程中,只需要掌握以下核心原则:
- 测试类声明
@ddt是所有数据驱动方法生效的前提。 - 单输入直接使用
@data(val1, val2, ...),方法定义单一形参接收。 - 多字段组合测试使用
@data包裹元组、列表或字典,并紧跟@unpack装饰器,将数据自动拆分并绑定到具名形参。 - 严格校验每组解包数据的长度与命名一致性,避免运行时形参映射错误。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









