

IPython相比标准Python解释器在运行模式上有哪些增强
一、架构分层:从单进程单体到客户端-内核解耦
标准 Python 解释器的交互模式采用经典的紧耦合单体设计。当在终端输入 python 启动解释器时,输入捕获、字节码编译、虚拟机运行时执行以及标准输出打印全部在同一个进程的单一线程内同步完成。
这种单体结构带来了运行模式上的核心局限:终端控制台与 Python 运行时生命周期严格绑定。一旦终端连接意外中断,内部运行的计算任务即刻终止;同时,标准解释器无法在不终止进程的前提下更换展示界面,也无法让多个客户端同时观察或操作同一个运行环境。
IPython 则彻底重构了运行拓扑,演进为 Client-Kernel(客户端-内核)解耦架构。执行代码的运行实例被称为 IPython 内核(IPython Kernel),负责维护全局命名空间与解释器状态;而接收用户输入并展示输出的前端可以是终端界面(Terminal)、Jupyter Notebook、Web 控制台或各类 IDE 插件。
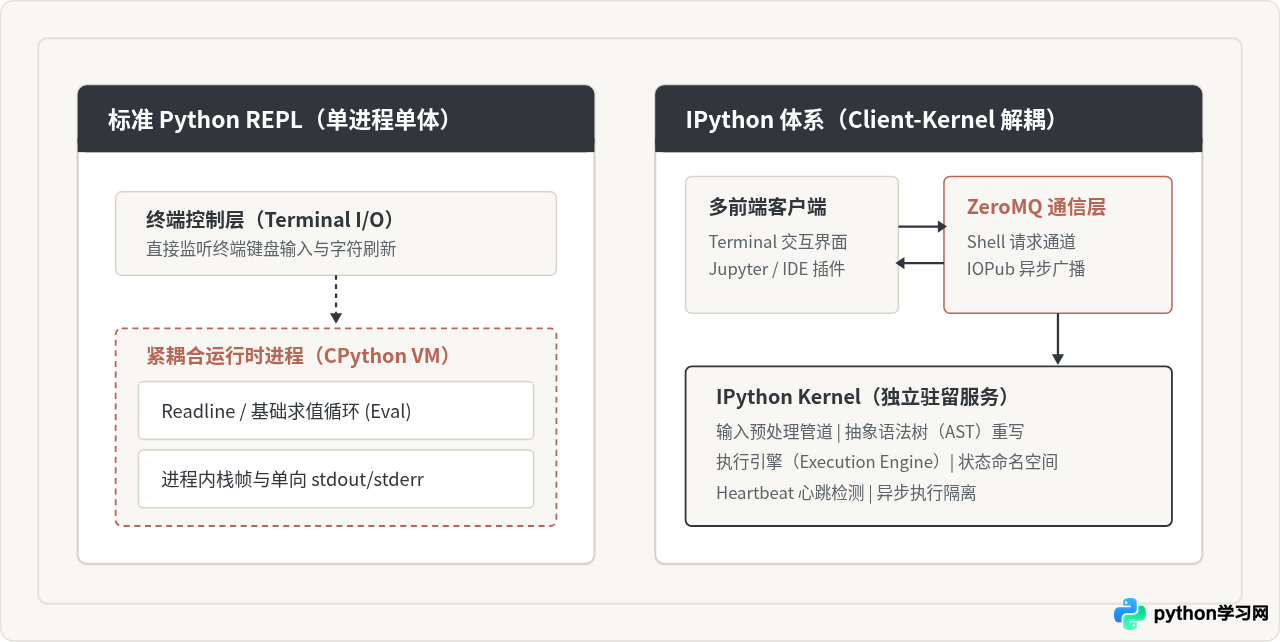
两者在运行模式上的核心通信通道包括:
- Shell 通道:处理代码执行请求、对象自省请求以及历史命令查询,采用请求-响应模式。
- IOPub 通道:负责将执行过程中的标准输出、标准错误以及多格式富文本(Rich Display)以发布-订阅模式异步推送到所有挂载的客户端。
- Stdin 通道:当内核代码调用
input()时,内核反向向客户端请求输入并挂起等待,实现安全的远程交互输入。 - Control 与 Heartbeat 通道:独立的高优先级控制队列,负责执行中断(Interrupt)、重启内核指令,以及通过心跳检测实时感知进程活跃状态。
由于内核作为独立服务驻留在系统后台,即便控制台闪退或前端界面重启,执行上下文(数据变量、导入模块、计算结果)仍然完好保存在内核内存中,客户端重新连接即可继续操作。
二、输入流处理:多阶段 AST 预转换机制
标准 Python 解释器接收到键盘字符流后,直接由底层 C 模块调用标准词法分析器与语法分析器。如果输入的不是完全符合当前 Python 语法的源码,解释器将直接抛出 SyntaxError。
IPython 则在用户输入与底层 Python 执行引擎之间插入了一个可扩展的输入预处理转换管道(Input Transformation Pipeline)。在代码实际编译为字节码之前,IPython 会对文本进行词法探测、非标准语法宏展开以及抽象语法树(AST)阶段性重写。
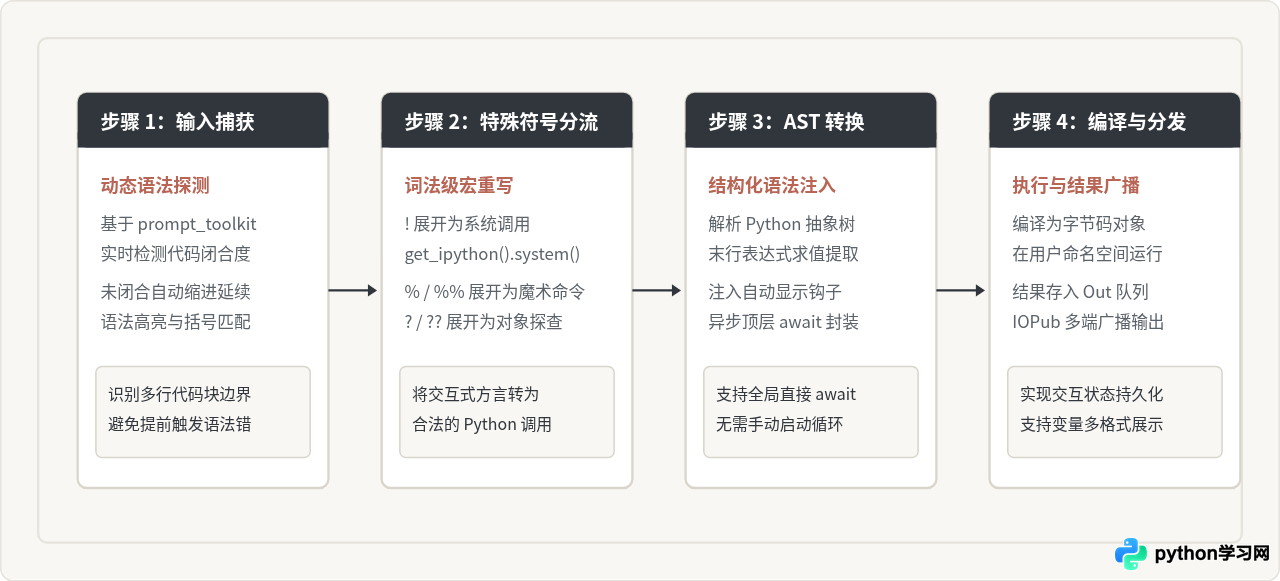
输入流增强机制具体体现在以下几个关键功能:
-
系统 Shell 级联(Escaped Commands):在行首输入
!时,预处理器将其解析为对底层系统命令的调用,例如!ls -la或!pip install requests。更重要的是,用户可以将 Shell 命令的运行输出直接赋给 Python 变量,如files = !ls *.py,预处理器会自动将其封装为自定义的SList字符串列表类型。 -
魔术命令系统(Magic Commands):支持单行
%与多行块级%%魔术指令。例如%timeit会将后续表达式包装进独立的性能测试计时循环中,执行多次取平均基准;%run script.py会在一个全新或受控的全局命名空间中执行目标文件,并将脚本内的函数和全局变量留存在当前的交互会话中供后续调用。 -
顶层异步执行(Top-level await):在标准 Python 解释器中,直接在提示符下输入
await asyncio.sleep(1)会报语法错误(除非在 3.8+ 启动特殊的python -m asyncio模式)。而 IPython 默认在 AST 阶段将顶层包含的await代码自动包装为协程任务并交由事件循环驱动,开发者可无缝执行异步网络请求与并发测试。
三、状态持久化与执行控制:会话历史与多格式输出
在标准 Python 解释器中,交互状态极其精简:解释器仅使用全局单下划线变量 _ 暂存上一个非 None 表达式的求值结果。若连续执行了多次计算,先前的计算结果如果不显式赋值给变量,就会在下一轮求值后直接被覆盖丢失。
IPython 将交互过程建模为带版本与序号的状态流(Stateful Session Pipeline),引入了结构化的输入输出持久化机制:
In [1]: import math
In [2]: r = 5.0
In [3]: 2 * math.pi * r
Out[3]: 31.41592653589793

In [4]: math.pi * (r ** 2)
Out[4]: 78.53981633974483

In [5]: Out[3] + Out[4]
Out[5]: 109.95574287564276
在每次执行周期中,IPython 会分别向 In 列表追加原始输入的代码文本,向 Out 字典按执行序号记录返回的 Python 对象引用。同时,系统维护 _(上一个结果)、__(倒数第二个结果)和 ___(倒数第三个结果)。这意味着即使开发者忘记在输入时对耗时庞大的计算分配变量名,也可以通过 Out[n] 随时提取内存中的对象实体。
Out 字典在内核生命周期内持有对象的真实强引用,如果在一个长时间运行的 IPython 会话中执行了大量大型矩阵计算(例如数百兆的 NumPy 数组或 Pandas DataFrame),这些对象不会被 Python 垃圾回收器(GC)及时回收。若需释放内存,需主动调用 %reset out 或删除对应键名。
此外,标准解释器在输出对象时仅调用底层对象的 __repr__ 文本方法。IPython 则引入了 富显示格式协议(Rich Display Protocol)。通过 _repr_html_、_repr_svg_、_repr_png_、_repr_latex_ 等特定协议方法,一个数据对象在向客户端广播时可以同时携带多种 MIME 类型数据。终端前端优雅降级展示纯文本,而 Web 或图形客户端则能够直接呈现格式化表格、可交互图表或数学公式。
四、异常分析与调试机制:从静态栈跟踪到动态现场接管
在标准 Python 解释器中,代码发生未捕获异常时,解释器会将异常信息与简要的回溯路径(Traceback)直接打印至控制台。打印完成后,当前执行的上下文栈帧(Stack Frames)会被立即销毁并回收,控制权直接交还给提示符 >>>。此时,产生报错时各个函数作用域中的局部变量已经彻底消失,开发者只能依靠阅读静态调用栈推测错误原因。
IPython 则将异常处理改造为可交互的动态现场捕获模式。当异常抛出时,内核的异常处理钩子(Exception Hook)会主动拦截并完整保留发生异常时的全部调用栈帧与作用域环境。
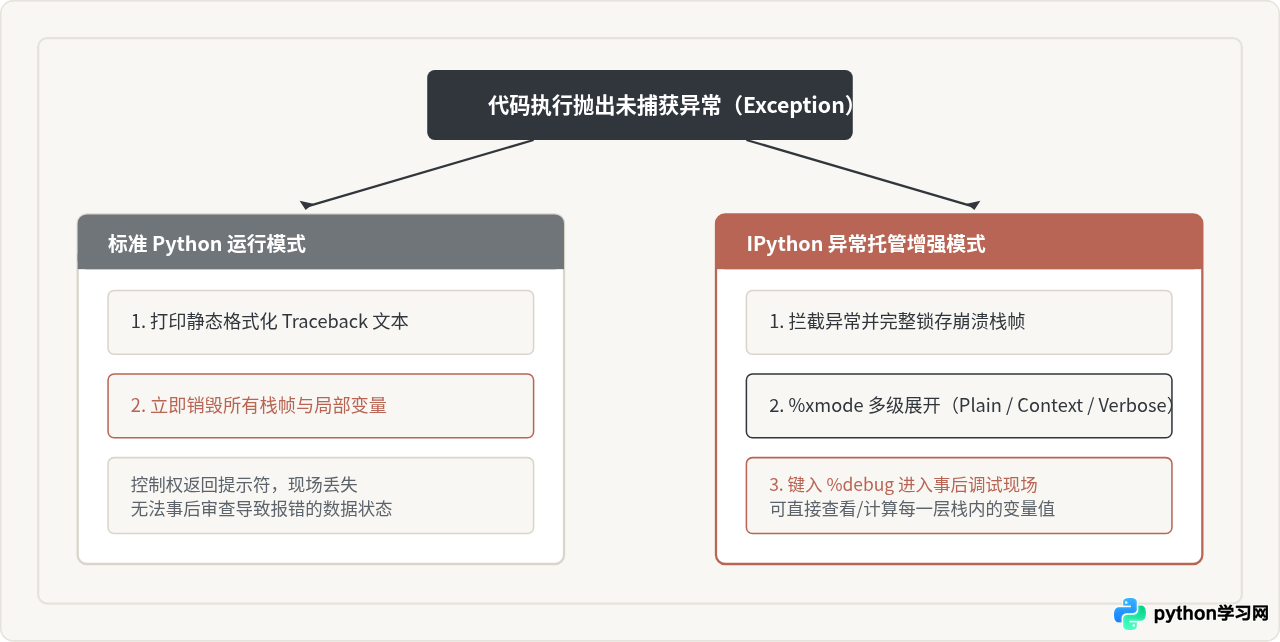
基于这种动态留存机制,IPython 提供了两项关键的调试能力:
-
事后调试器(Post-Mortem Debugging):在代码报错之后,无需修改代码重新加断点运行,只需立即输入
%debug命令,IPython 会基于刚才锁存的崩溃现场直接唤起ipdb交互式调试器。开发者可以在调用栈间自由上下穿梭(u/d),打印查看引起崩溃的局部参数。 -
自动进栈开关(%pdb on):通过执行
%pdb on,每当后续任何语句引发未处理异常时,IPython 会自动拦截并直接掉入故障现场的调试交互提示符,彻底免去手动加桩排查的繁琐操作。 - 可调回溯模式(%xmode):支持 Plain(简明)、Context(默认上下文)与 Verbose(极详)三种模式。在 Verbose 模式下,IPython 在回溯输出中不仅展示代码行,还会直接打印出各个调用层级局部变量的具体值,极大减少了排错时间。
五、核心维度对照与适用边界
综合以上分析,IPython 在运行模式上的增强并非简单的“外壳包装”,而是对 Python 代码的输入流、抽象语法树、运行拓扑以及栈帧生命周期进行了系统级扩展。为了更直观地把握二者的根本区别,下表从五个关键架构维度对其进行了对比总结:
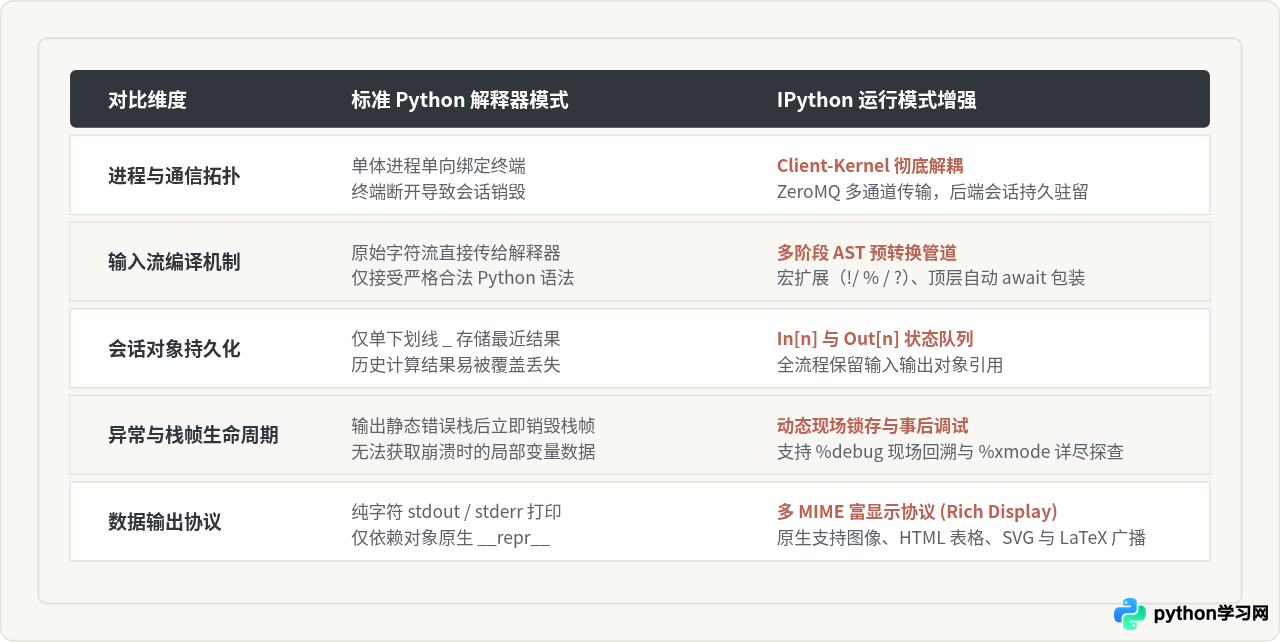
虽然 IPython 在探索性分析、算法验证与科研实验中提供了极高的效率,但在工程选型中仍需明确两者的边界:
-
生产部署与批处理任务:仍然必须使用标准
python script.py运行。IPython 的预处理转换层引入了额外的运行时开销;其对Out对象的持久持有容易导致服务长期运行时的隐匿内存泄漏;且魔术命令和语法糖属于非标准语法,无法在纯净的 Python 执行环境中通用。 - 交互式探索与日常调试:IPython 的解耦架构构成了现代数据科学基础设施(Jupyter生态)的核心基石,其动态调试与状态追踪机制能够显著缩短复杂业务逻辑与数据处理流程的排错反馈周期。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









