

Python 3.8之前怎么计算列表乘积?兼容旧版本方案
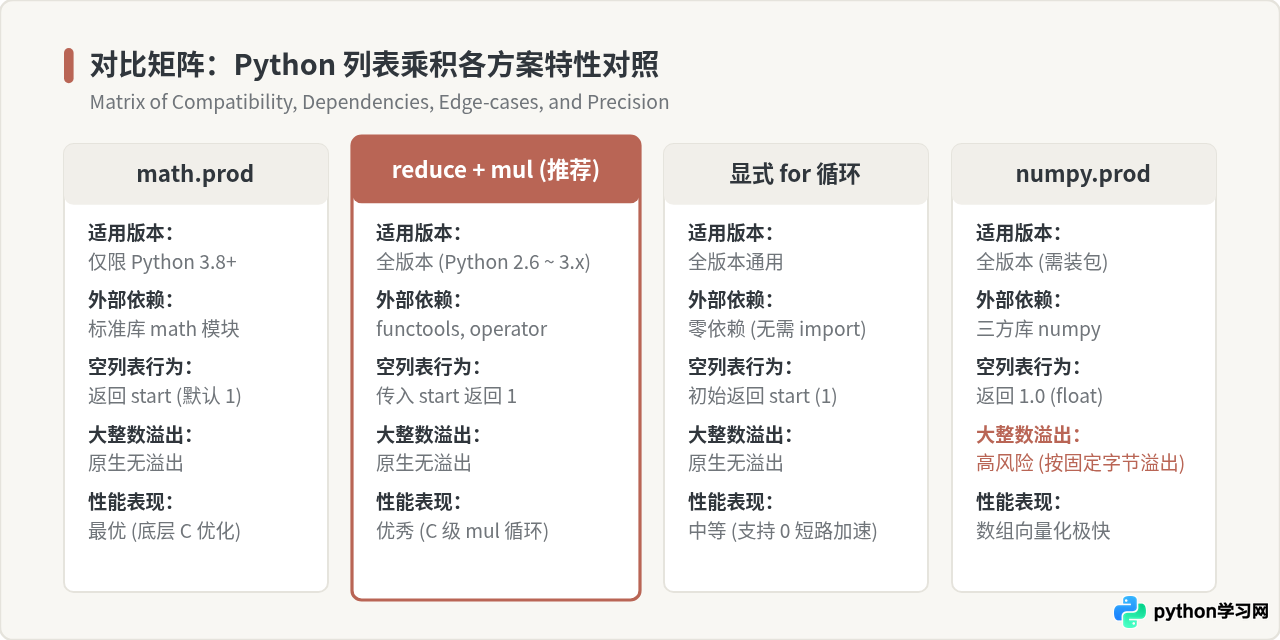
sum() 的内置 prod() 函数,直到 Python 3.8 才正式在 math 模块中加入了 math.prod()。针对需要运行在 Python 3.7、3.6 等旧版本环境的项目,最推荐的标准库解法是借助 functools.reduce 搭配 operator.mul 并显式指定初始值 1;或者采用轻量的平铺 for 循环实现。本文将梳理这两种核心方案及各自的适用边界。
一、为什么 Python 3.8 之前缺少类似 sum 的内置乘积函数
Python 从早期版本开始就内置了 sum(iterable, start=0),用于快速求取序列中所有数值的和。然而在数学与日常工程计算中,求和出现的频率远高于求积,并且序列乘积存在数值极速膨胀、浮点舍入累积以及空集合单位元定义等细节考量。因此 Python 核心团队长期没有在 builtins 中提供 prod()。
直到 Python 3.8,官方才正式在 math 模块中引入了 math.prod(iterable, *, start=1)(由 PEP 544 提出并落实)。如果代码部署或维护的环境包含低于 Python 3.8 的解释器,直接调用 math.prod 会引发 AttributeError: module 'math' has no attribute 'prod'。为了保证跨版本兼容性,开发者必须选择向后兼容的替代方案。
二、标准库最优解:functools.reduce + operator.mul
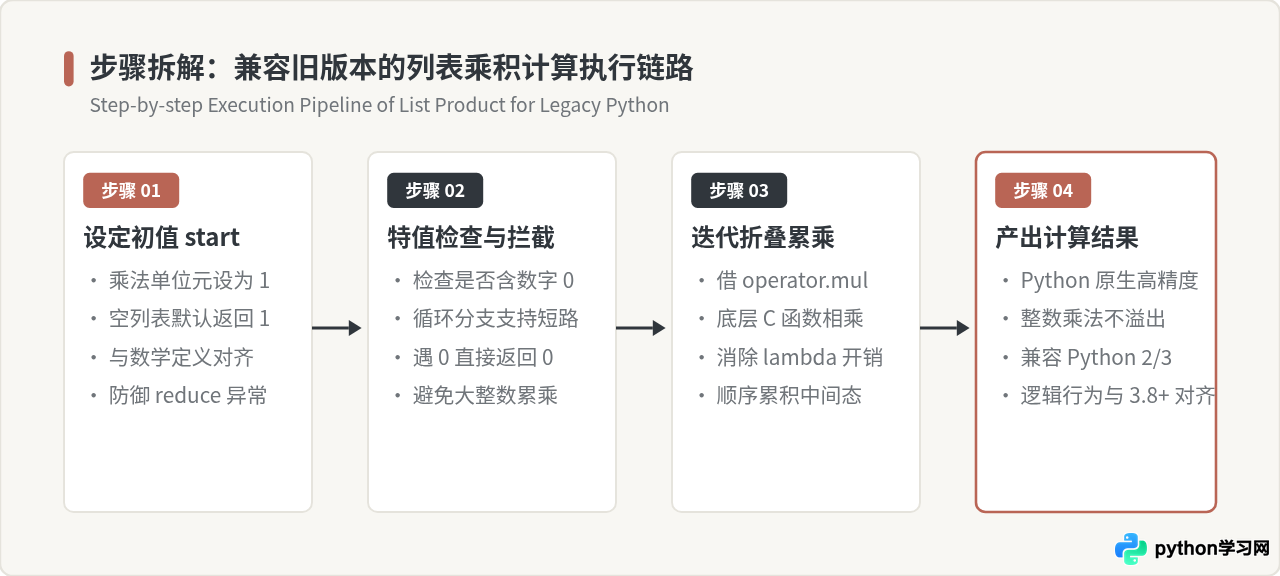
在 Python 3 中,reduce 位于标准库模块 functools 内,而基本的算术乘法操作可以通过 operator.mul 获得。两者结合是 Python 社区公认的函数式标准写法。
1. 完整示例代码
from functools import reduce
import operator

def prod(iterable, *, start=1):
    """
    计算可迭代对象的乘积,向下兼容 Python 3.8 之前的版本。
    :param iterable: 包含数值的可迭代对象
    :param start: 累乘初始值,默认为 1
    :return: 序列元素的连乘积
    """
    return reduce(operator.mul, iterable, start)

# 示例验证
numbers = [2, 3, 4]
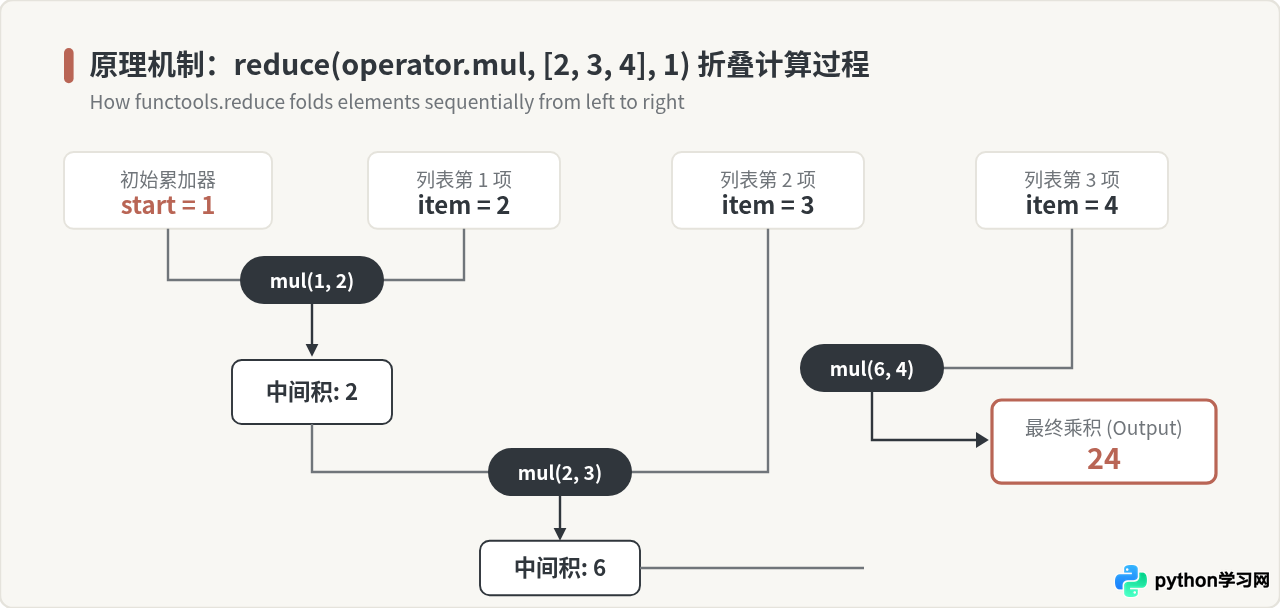
print(prod(numbers))  # 输出 24

# 空列表测试
print(prod([]))       # 输出 1
2. 为什么搭配 operator.mul 而不是 lambda
不少开发者初写 reduce 时会顺手使用匿名函数:
reduce(lambda x, y: x * y, numbers, 1)
这种写法逻辑正确,但在性能上存在劣势。每次迭代调用 lambda 都会在 Python 虚拟机中经历一次函数调用的栈帧创建与解构开销。而 operator.mul 是由 CPython 纯 C 实现的内置函数,不仅执行路径极短,而且语义更清晰,可有效缩减大列表的计算时间。
三、无需模块依赖的纯基础实现:显式 for 循环
如果代码处于轻量脚本中,或者不希望导入任何模块,最直接的方法是使用普通的 for 循环。
1. 循环实现与提前短路优化
def prod_loop(iterable, start=1):
    result = start
    for item in iterable:
        if item == 0:
            return 0  # 遇到 0 直接提前短路,避免后续冗余计算
        result *= item
    return result

# 性能敏感场景示例:当列表中间含有 0 时立即返回
data = [13, 29, 0, 99999, 1000000]
print(prod_loop(data))  # 遇到 0 直接返回 0
显式循环虽然行数比 reduce 多两三行,但它具有一个关键优势:支持提前终止(Short-circuiting)。在乘法运算中,任何数值乘以 0 都等于 0。如果在大型列表中间存在 0,functools.reduce 仍会机械地遍历完整个列表,而 for 循环可以立刻 return 0,在含有 0 的长列表场景中能节约大量计算资源。
四、科学计算场景的替代:NumPy 的 np.prod
如果工程本身已经依赖了数值计算库 NumPy(例如在数据分析、机器学习项目中),可以直接调用 numpy.prod:
import numpy as np

arr = [2, 3, 4]
res = np.prod(arr)
print(res) # 输出 24Python 内置的
int 类型具备任意精度(Arbitrary-precision),无论相乘的结果有多大都不会发生数值溢出;但 NumPy 的底层数组默认使用 C 语言固定宽度的整型(如 32 位或 64 位)。当列表中存在较多较大整数时,np.prod 可能会发生静默的整数溢出导致错误结果。如果处理纯 Python 大整数,必须优先使用 reduce 或标准循环。
五、生产级 Polyfill:无缝兼容新旧版本的统一写法
如果开发的是一个需要发布到 PyPI 的库,或者维护的代码既可能运行在 Python 3.8+ 也可能部署在老旧服务器(如 CentOS 7 默认的 Python 3.6 环境)上,最佳实践是采用 特性探测回退(Polyfill)模式。
在模块头部先尝试导入官方的 math.prod;如果抛出 ImportError 或 AttributeError,则平滑降级为 reduce + mul 实现:
try:
    # 优先尝试 Python 3.8+ 官方优化实现
    from math import prod
except ImportError:
    # 降级支持 Python 3.7 及更早版本
    from functools import reduce
    import operator

    def prod(iterable, *, start=1):
        """兼容旧版本的 math.prod 等效实现"""
        return reduce(operator.mul, iterable, start)

# 后续业务逻辑统一调用 prod(),无需关心当前 Python 具体小版本
result = prod([1, 2, 3, 4, 5])
print(result)  # 输出 120
这种模式的好处在于:在现代 Python 3.8~3.12+ 环境中能享受到官方 C 语言级别的性能加速,而在旧版本环境下又能自动降级、绝不报错,代码干净且零侵入。
六、边界与异常处理避坑指南
1. 空列表必须明确初始值 start=1
在数学代数中,空和(Empty Sum)等于 0(加法单位元),而空积(Empty Product)定义为 1(乘法单位元)。
使用 reduce 时如果不传第三个参数 initializer,当列表为空时会直接抛出致命异常:
from functools import reduce
import operator

# 错误示范:未传递初始值
reduce(operator.mul, [])
# 抛出异常: TypeError: reduce() of empty sequence with no initial value
因此,封装或使用 reduce 计算乘积时,必须显式传递 start=1,既对齐数学规范,又防范运行期崩溃。
2. 包含浮点数时的精度累积
与加法相同,连续的浮点数乘法运算存在二进制精度截断问题。例如 0.1 * 0.1 * 0.1 在浮点运算中无法精确表示。如果业务场景对金融精度要求极高,应在传入列表前将数值转换为 decimal.Decimal,上述 reduce + operator.mul 或 math.prod 均能自然兼容 Decimal 对象。
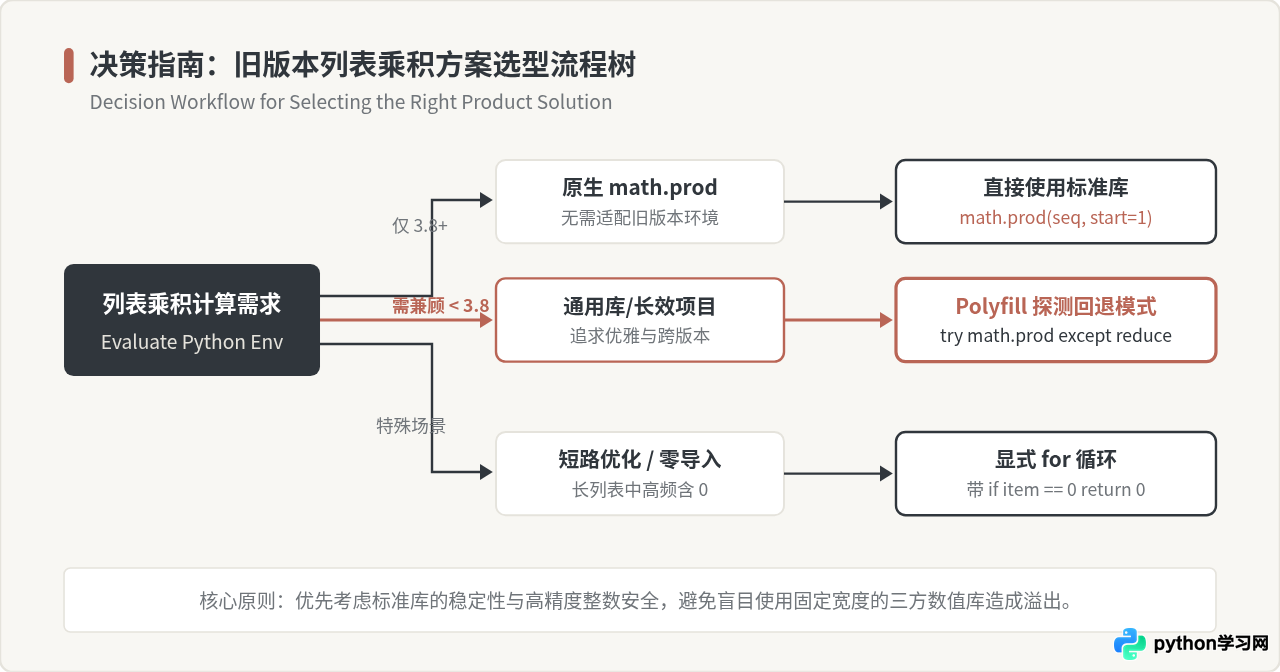
七、总结
面对 Python 3.8 之前缺乏原生 math.prod 的限制,开发者应当结合实际工程环境选取最适合的手段:
- 通用库与跨版本开发:推荐采用
try: from math import prod except: ...的 Polyfill 结构,回退实现采用reduce(operator.mul, iterable, start),兼具性能与向下兼容性。 - 简单脚本或含零稠密序列:采用手写
for循环并在遇到0时提前短路,既免去引入模块的繁琐,又能在特殊分布数据上获得更高的执行效率。 - 科学计算环境:若数组规模大且数值已知在 64 位范围内,可用
numpy.prod;涉及大整数相乘时务必回归纯 Python 实现以规避溢出风险。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









