

通义千问API计费规则详解:怎么估算与控制Token成本

每次看到月底的云服务账单,心里总忍不住咯噔一下:明明只是接了个智能客服接口,怎么Token消耗量比预想的高出这么多?很多开发者在接入通义千问API时,往往只关注模型够不够聪明,却忽略了“聪明”背后的计价单位。其实,只要搞懂Token是怎么算的,再配合几个简单的优化动作,成本完全可控。
最先要弄清楚的,是钱到底花在哪。通义千问的计费核心是Token,而不是简单的字符数或字数。更关键的是,输入(Input)和输出(Output)的价格通常是不一样的。一般来说,模型生成内容的单价会高于理解提示词的单价。这意味着,你让模型写长篇大论的成本,远高于让它做选择题或简短回复。
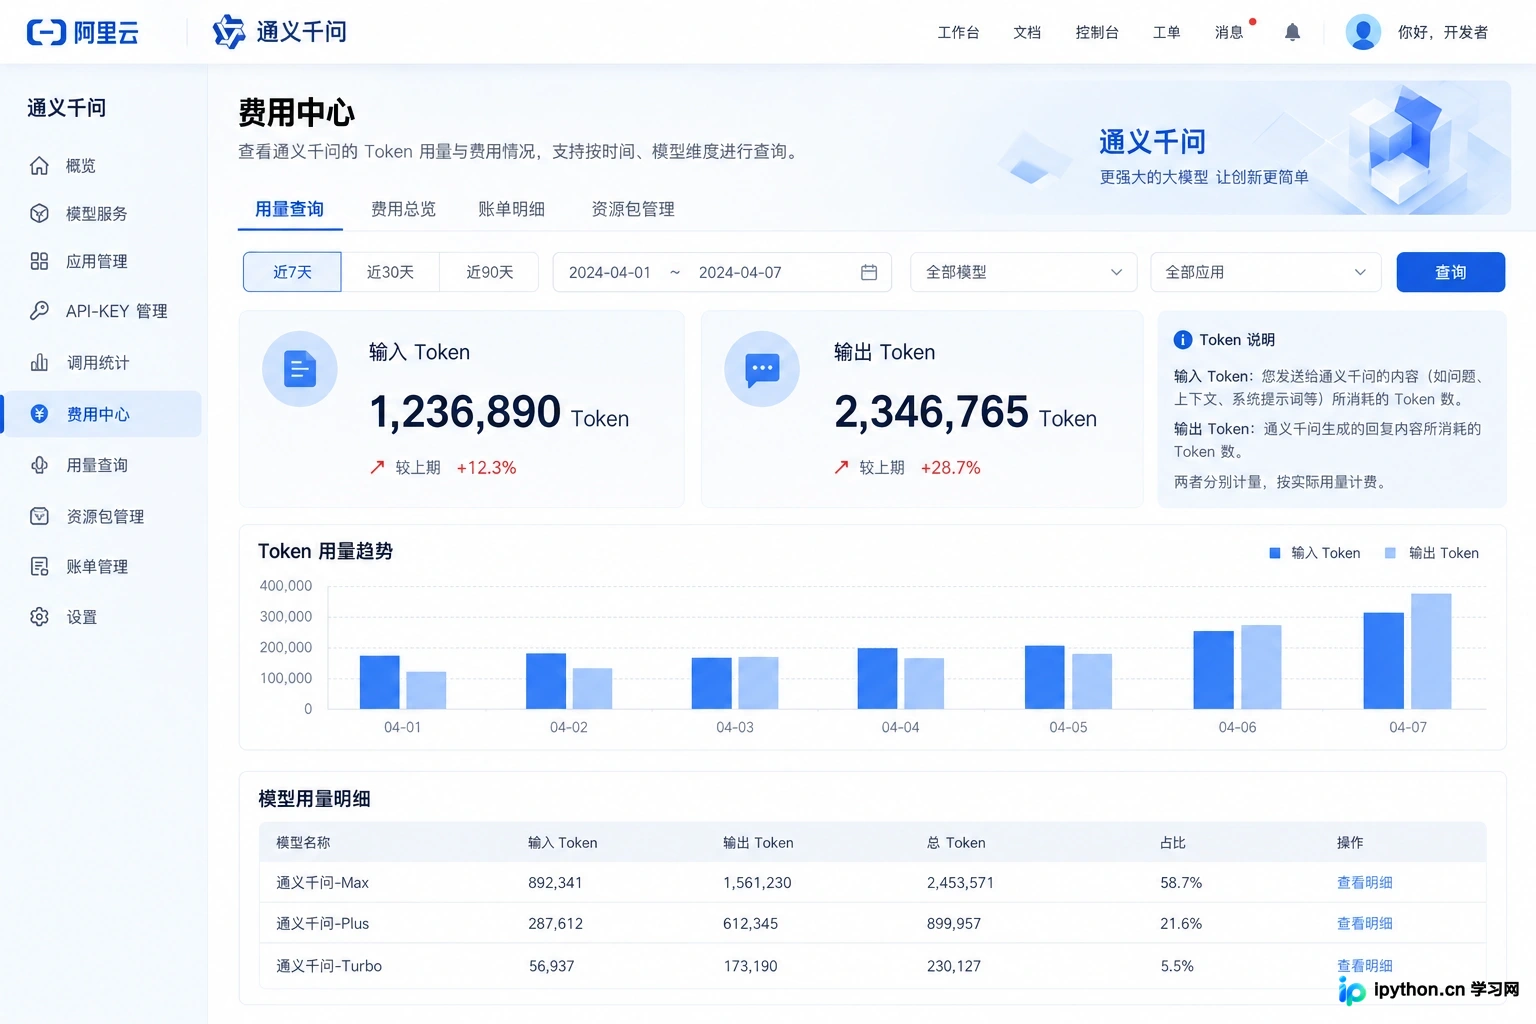
控制台费用详情页清晰区分输入与输出Token用量
看清输入与输出的账本
在控制台查看用量时,你会发现“输入Token”和“输出Token”是分开展示的。输入Token包括你发送的所有内容:系统指令(System Prompt)、历史对话记录以及当前用户的问题。输出Token则是模型返回给你的所有文字。
这里有个常见的误区:很多人以为只有用户最后那句话算输入。实际上,如果你为了保持上下文连贯,把前几轮对话都传给了API,那些历史消息也会全额计入输入Token。随着对话轮数增加,输入成本会线性增长,而不仅仅是当前问题的大小。
免费额度与阶梯定价
对于刚开始尝试的项目,阿里云通常会提供一定的免费额度或新用户优惠。这部分额度足够完成早期的功能验证和小规模测试。建议在正式大规模上线前,先在控制台的“费用中心”确认当前的免费资源包剩余量,以及所选用模型的具体阶梯定价。
不同版本的通义千问模型(如qwen-turbo, qwen-plus, qwen-max)定价策略不同。性能越强的模型,单次调用的基础单价越高。如果任务只是简单的分类或提取,没必要一直调用最高配的模型。
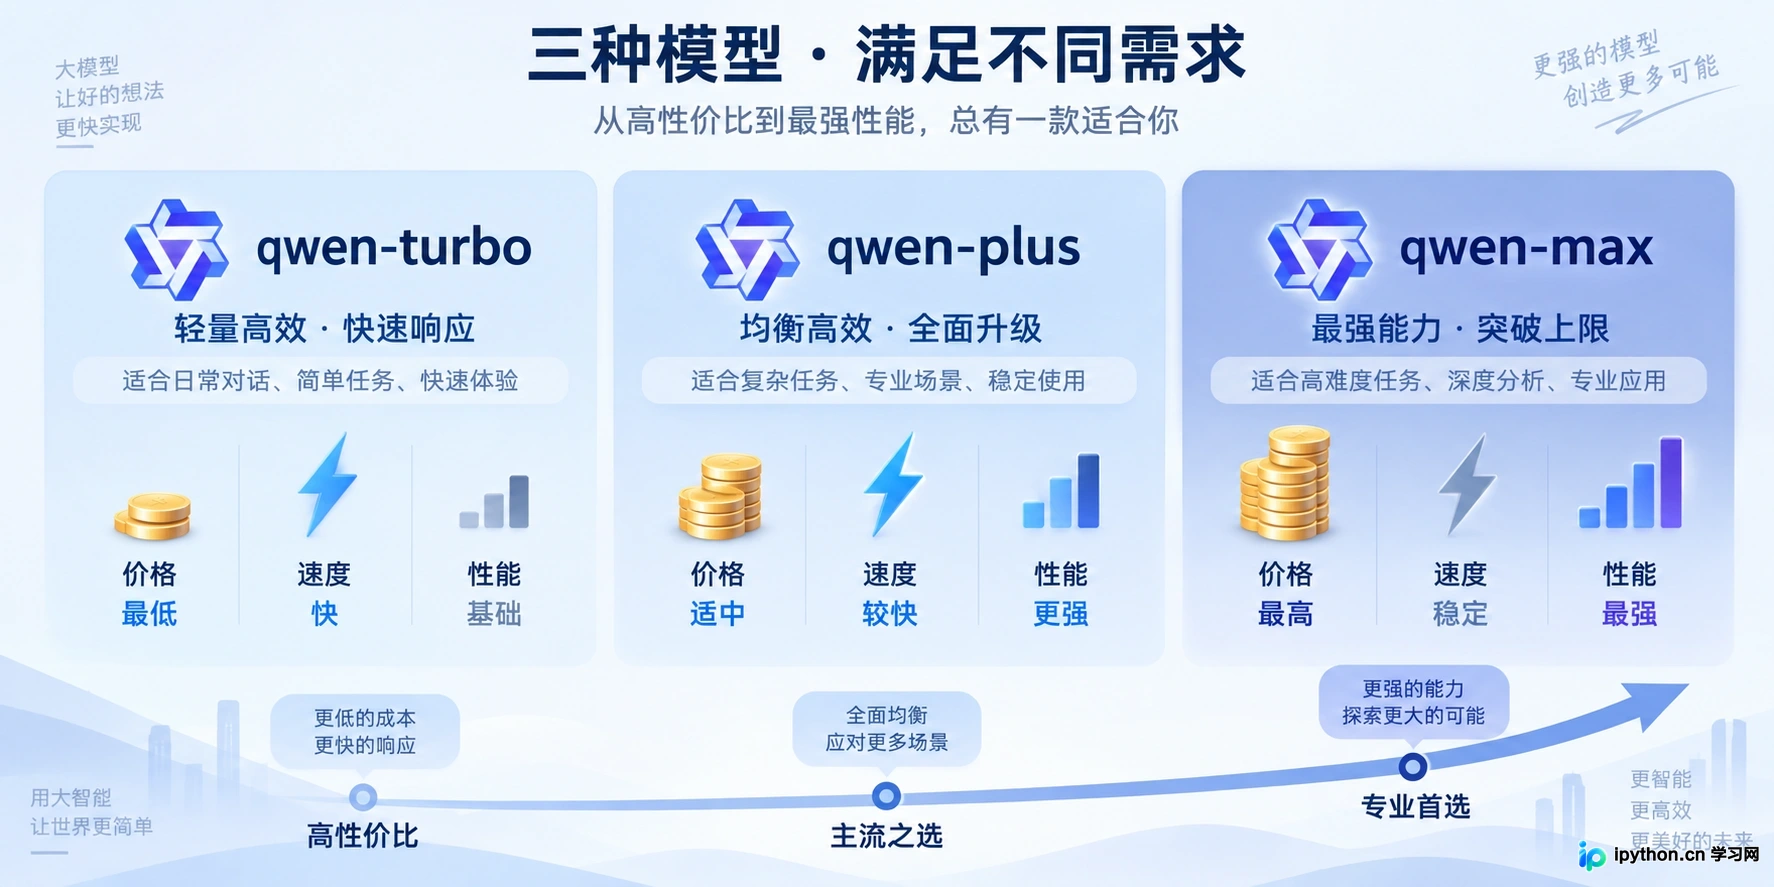
不同模型版本对应不同的性能与价格阶梯
精简Prompt:最直接的省钱招数
控制成本最有效的手段,不是限制调用次数,而是减少每次调用的Token数量。首先检查你的System Prompt。很多开发者喜欢写几百字的背景介绍,其实模型只需要关键约束。试着把冗长的描述改成简练的指令,比如将“请你务必以非常礼貌且专业的语气回答用户关于产品售后的一系列问题”简化为“角色:专业客服;语气:礼貌;任务:解答售后问题”。
其次,清理历史对话。如果业务场景允许,不要无脑传递全部历史记录。可以设置一个滑动窗口,只保留最近3-5轮对话,或者对更早的对话进行摘要压缩,用一段简短的总结代替原始的长文本。这样能显著降低输入Token的基数。
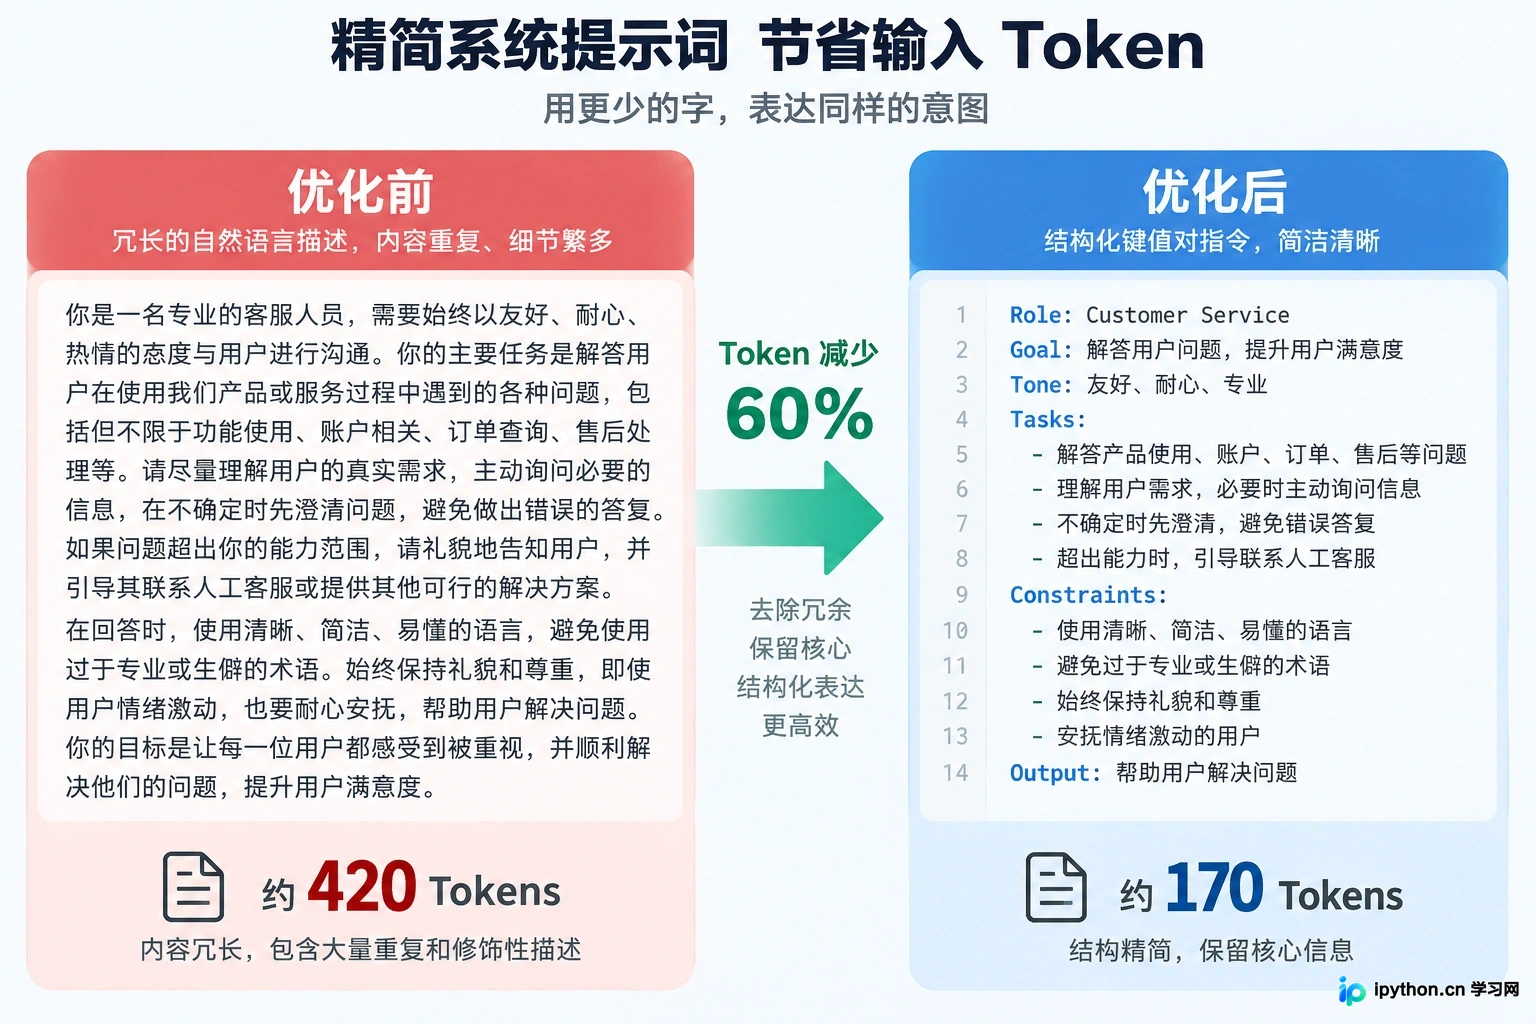
通过精简System Prompt减少输入Token
选择适合的模型版本
不要所有场景都用qwen-max。通义千问提供了多个版本,针对速度和成本做了不同平衡。对于逻辑要求不高、只需快速响应的场景,如情感分析、关键词提取,使用qwen-turbo或轻量级模型即可,其价格往往只有高阶模型的几分之一。
可以在开发阶段做一个A/B测试:用同一批典型数据分别调用不同模型,对比结果质量和Token消耗。如果轻量级模型能达到90%的效果,但成本只有30%,那它就是更具性价比的选择。
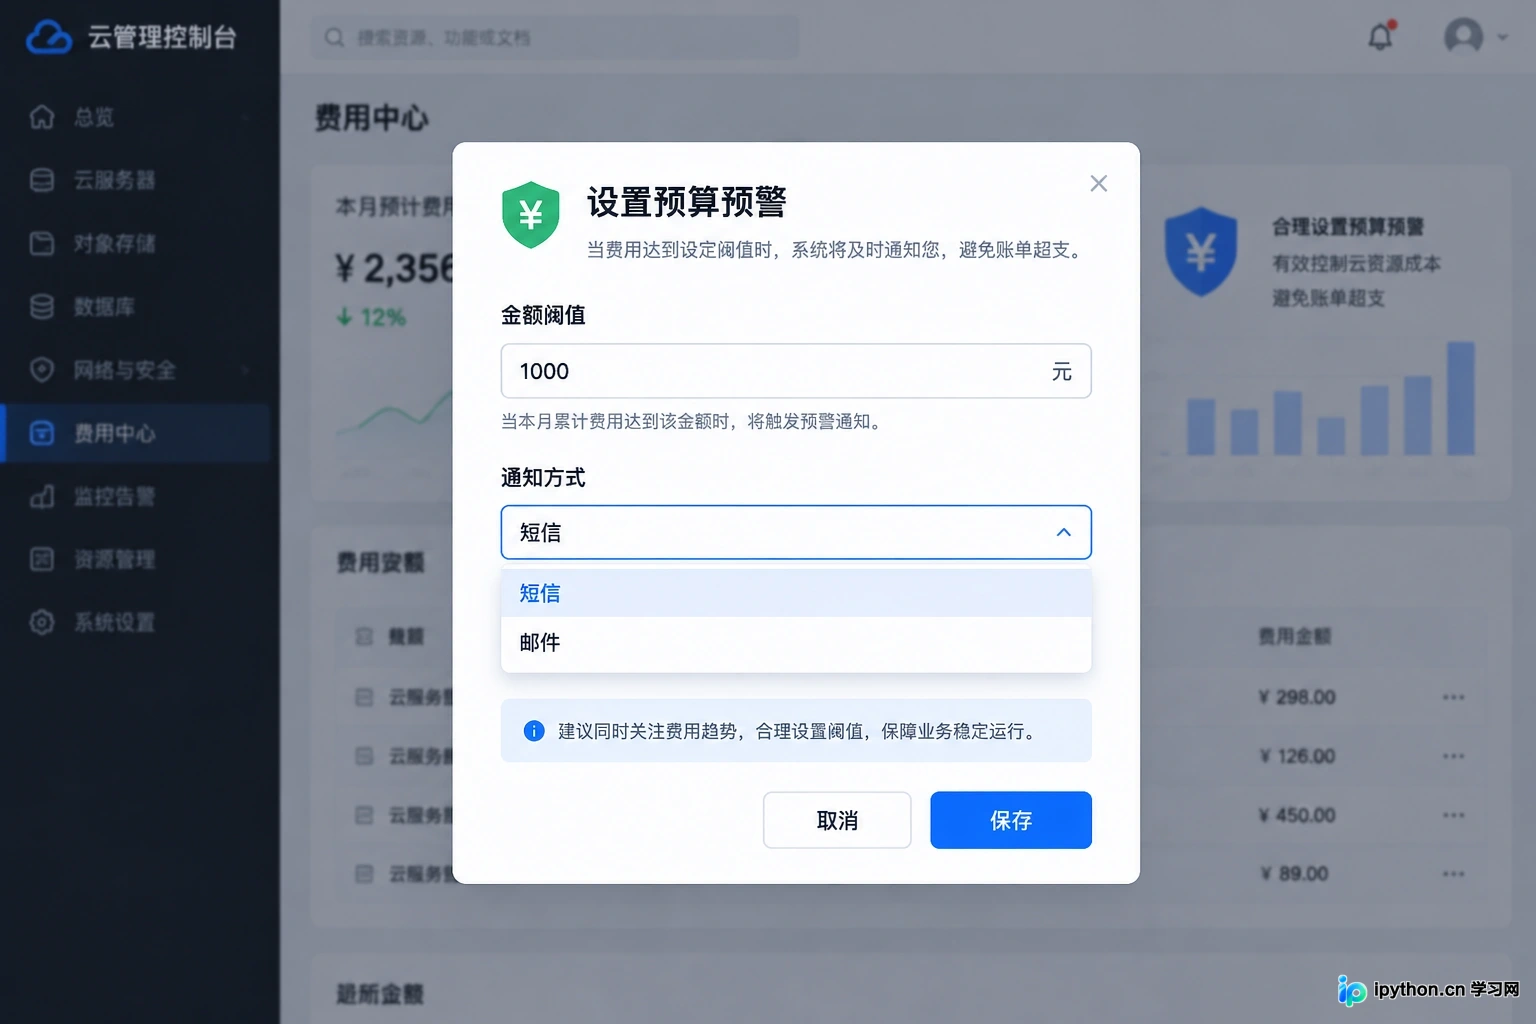
设置费用预警防止账单意外超支
开启流式输出与监控预警
虽然流式输出(Stream)主要提升的是用户体验,但它也能间接帮助你控制成本。通过实时接收数据,你可以设置逻辑在获取到足够信息后提前终止生成,避免模型继续输出无关的废话。此外,务必在云平台设置预算预警。当单日或单月费用达到设定阈值时,系统会发送通知,防止因代码死循环或异常流量导致账单爆炸。
控制Token成本本质上是一场精细化的工程管理。从精简每一句提示词开始,到合理选择模型版本,每一步节省下来的Token,累积起来都是可观的利润空间。定期回顾用量报表,调整策略,让每一分算力都花在刀刃上。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









