

通义千问API怎么实现流式输出(SSE)与函数调用

在构建现代AI应用时,等待一个完整的长文本生成完毕再展示给用户,是一种过时的交互体验。用户希望看到文字逐个蹦出的“打字机”效果,更希望AI不仅能聊天,还能真正“做事”——比如查询实时天气或检索数据库。这种从“静态问答”到“动态交互”的转变,核心在于两个关键技术:服务端发送事件(SSE)实现的流式输出,以及让模型具备行动能力的函数调用(Function Calling)。
通义千问API为这两者提供了标准化的支持。但这不仅仅是开启一个开关那么简单,流式输出需要处理碎片化的数据块拼接,而函数调用则要求开发者精确定义工具接口并处理模型的决策逻辑。本文将剥离繁琐的参数表,直接切入代码与场景,展示如何在实际工程中落地这两项能力。
流式输出:消除等待焦虑的SSE机制
想象一下,用户询问一个复杂的编程问题,如果系统沉默了十秒钟然后突然吐出一大段代码,这种中断感会极大地削弱信任度。流式输出(Streaming)通过服务器端发送事件(SSE)协议,将生成的内容分片实时推送到客户端。在通义千问API中,这主要通过设置 stream=True 参数来实现。
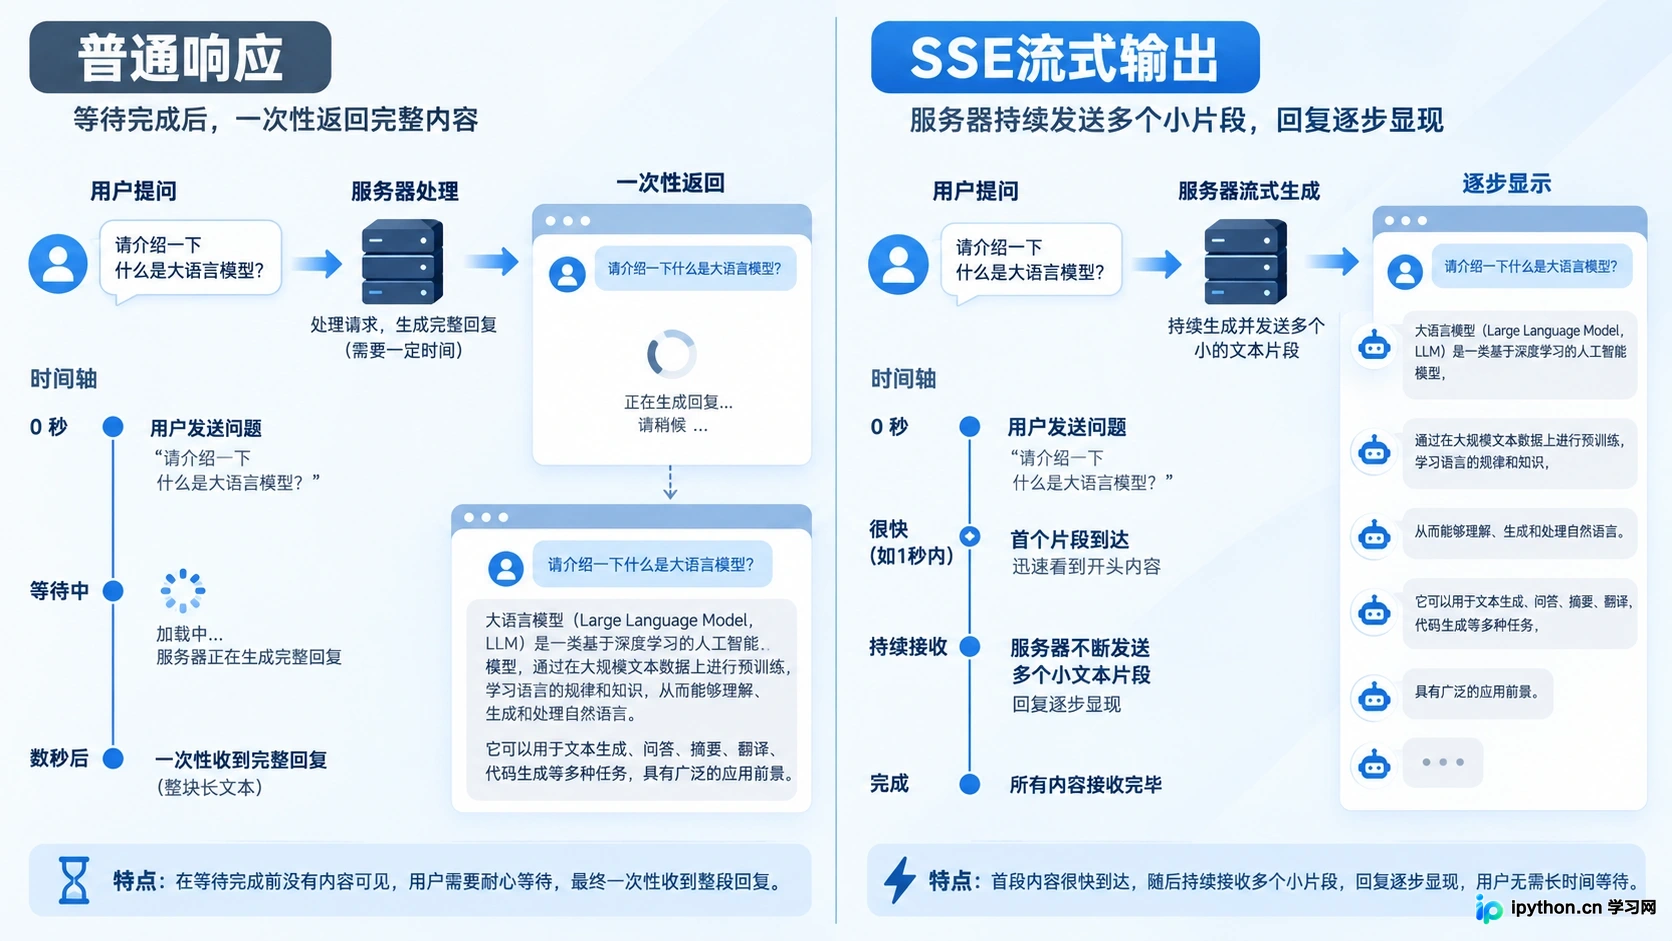
SSE流式数据传输与传统一次性响应的对比
在Python SDK中,启用流式模式后,返回的对象不再是包含完整文本的单一响应,而是一个迭代器。你需要遍历这个迭代器,逐块获取生成的内容。这里的关键在于处理 delta 字段,它包含了当前步骤新增的文本片段。
import dashscope
from dashscope.api_entities.dashscope_response import Role

def call_with_stream():
    messages = [
        {'role': 'system', 'content': 'You are a helpful assistant.'},
        {'role': 'user', 'content': '写一首关于春天的短诗'}
    ]

    response = dashscope.Generation.call(
        model='qwen-turbo',
        messages=messages,
        result_format='message',
        stream=True, # 关键参数:开启流式输出
        incremental_output=True # 推荐:增量输出,减少客户端拼接压力
    )

    full_content = ""
    for chunk in response:
        if chunk.status_code == 200:
            # 获取增量内容
            delta_text = chunk.output.choices[0].message.content
            if delta_text:
                print(delta_text, end='', flush=True)
                full_content += delta_text
        else:
            print(f"Error: {chunk.code} - {chunk.message}")

    return full_content
注意代码中的 incremental_output=True。虽然默认情况下流式输出也会工作,但开启增量输出模式可以让每个chunk只包含新生成的文本,而不是累积的历史文本。这对于前端渲染至关重要,避免了客户端需要不断截取字符串末尾的额外计算开销。在这种场景下,用户可以几乎零延迟地看到第一个字出现,随后的内容如流水般自然展开,极大地提升了交互的流畅感。
函数调用:让模型从“说话”到“做事”
如果说流式输出改善了“怎么说”,那么函数调用(Function Calling)则解决了“做什么”。大模型本身不具备访问实时数据或执行外部操作的能力。通过Function Calling,我们可以定义一组工具(如搜索API、计算器、数据库查询),让模型根据用户意图判断是否需要调用这些工具,并生成符合规范的调用参数。
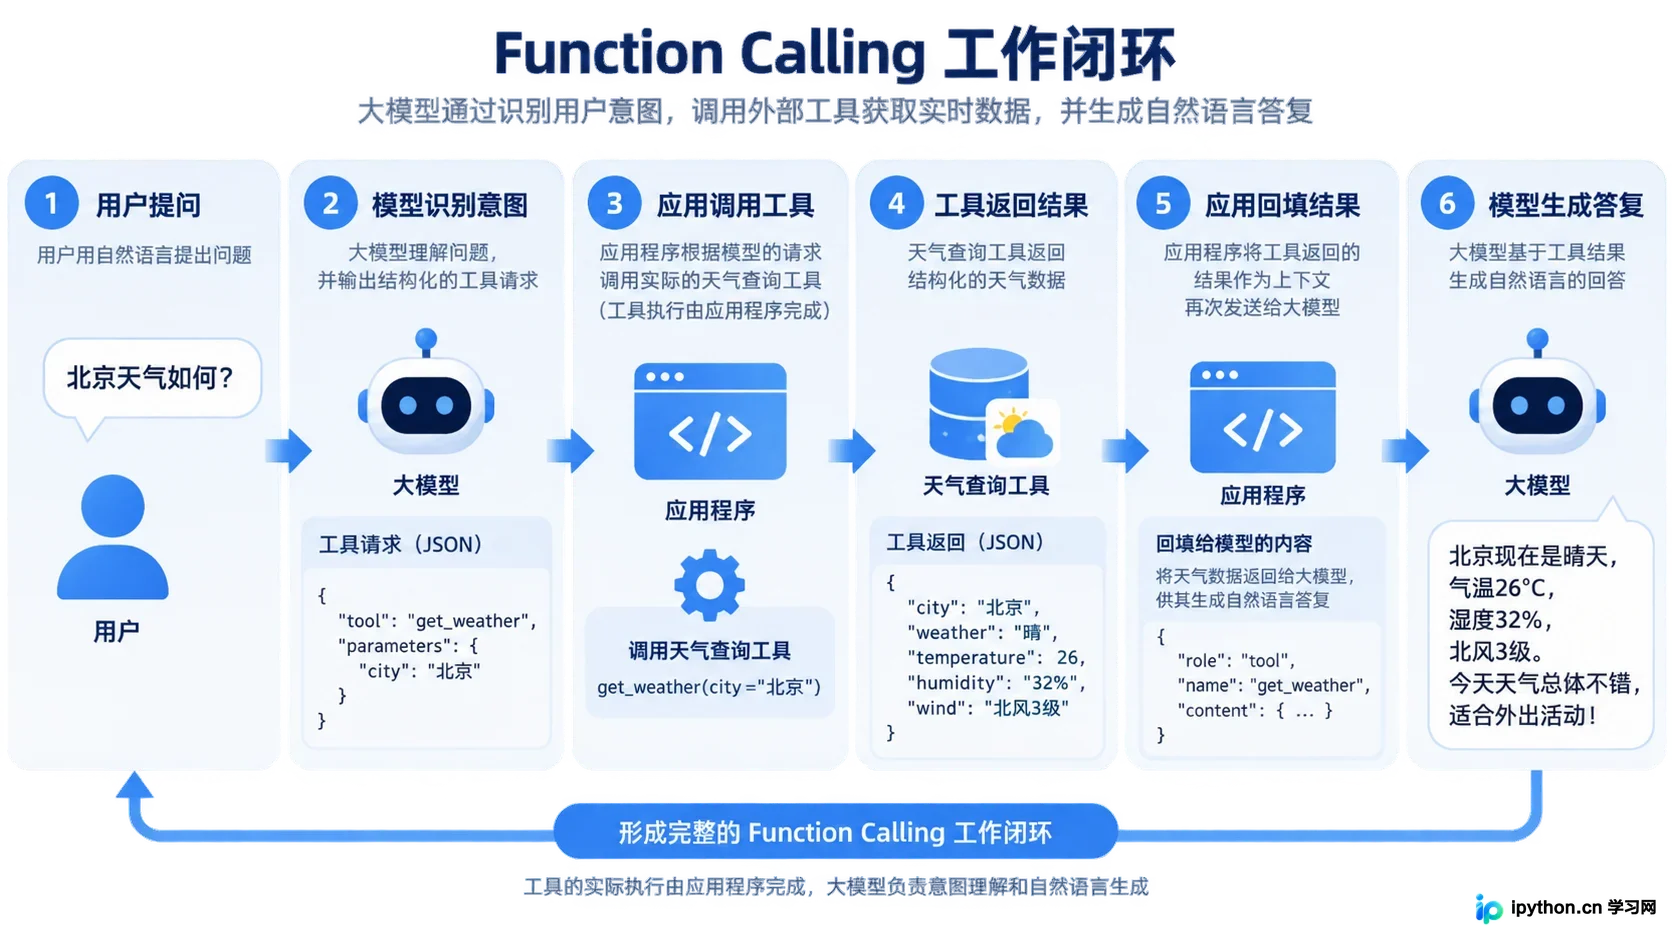
用户提问、模型决策、工具执行与结果回填的闭环流程
这一过程分为三个阶段:定义工具、模型决策、执行与回填。首先,你需要以JSON Schema的形式向模型描述可用的函数。描述越清晰,模型调用的准确率越高。
tools = [
    {
        'type': 'function',
        'function': {
            'name': 'get_current_weather',
            'description': '获取指定城市的当前天气情况',
            'parameters': {
                'type': 'object',
                'properties': {
                    'location': {
                        'type': 'string',
                        'description': '城市名称,例如:北京、上海'
                    },
                    'unit': {
                        'type': 'string',
                        'enum': ['celsius', 'fahrenheit'],
                        'description': '温度单位'
                    }
                },
                'required': ['location']
            }
        }
    }
]
当用户提问“北京今天天气怎么样?”时,模型不会直接编造天气,而是识别出意图,返回一个特殊的消息结构,指示需要调用 get_current_weather 函数,并提取出参数 location: "北京"。
解析与执行:闭环的逻辑处理
拿到模型的调用指令后,开发者需要在代码中进行拦截和处理。这不是自动执行的魔法,而是需要显式编写的逻辑。你需要检查返回消息中是否包含 tool_calls 字段。
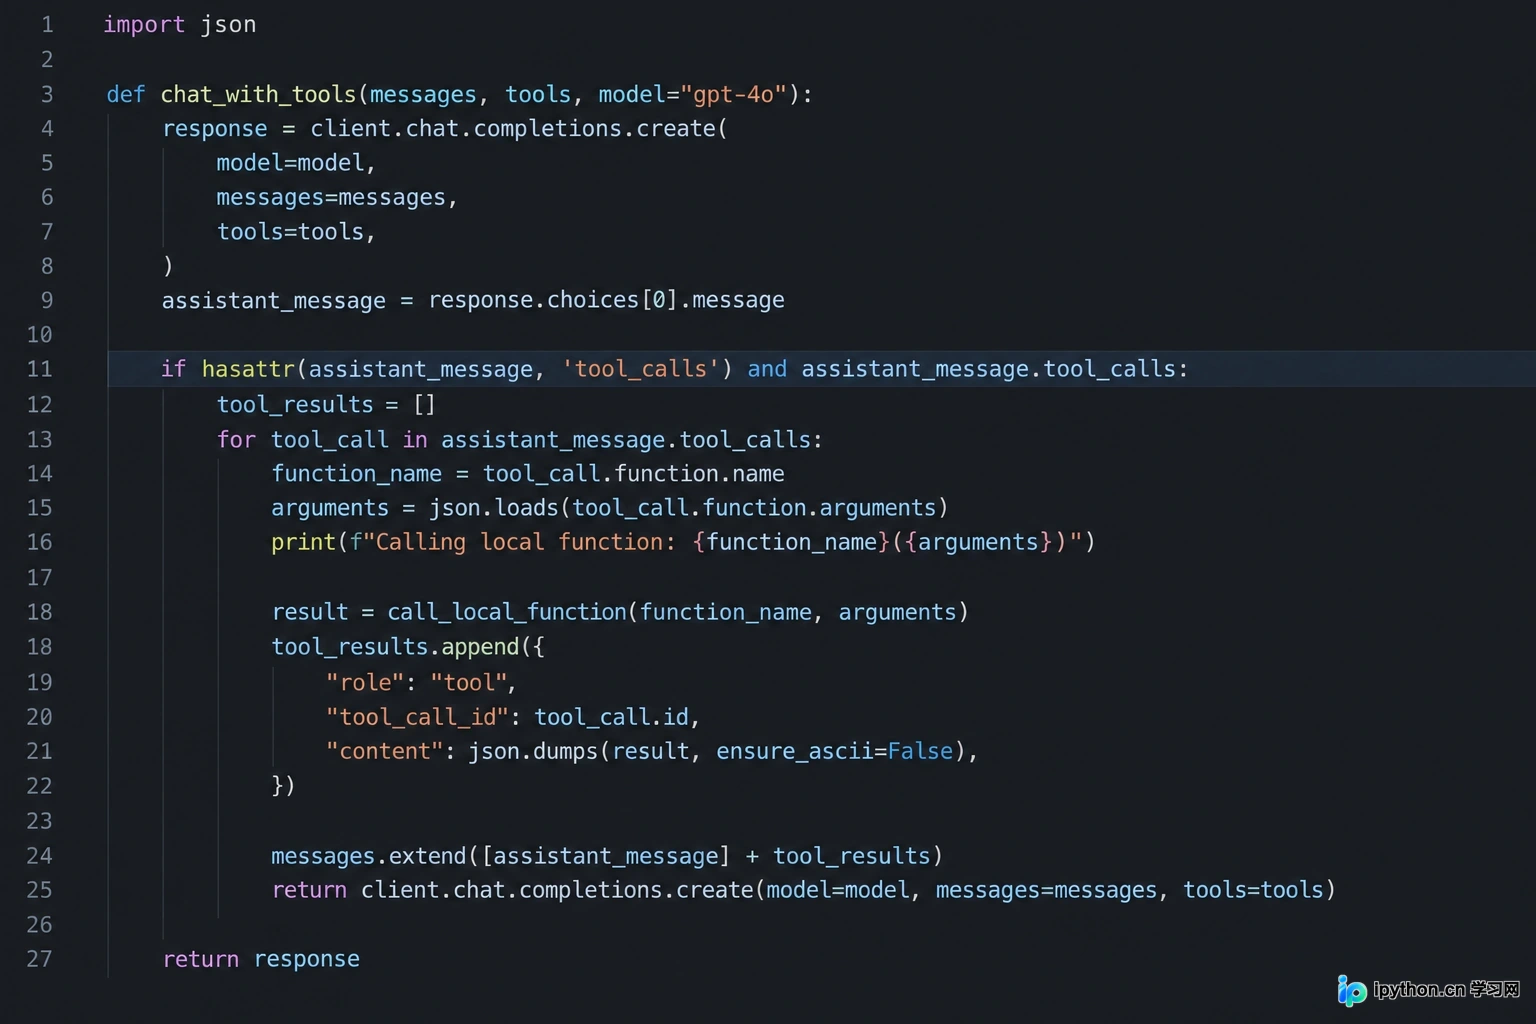
Python代码中处理tool_calls字段并执行外部函数的逻辑片段
如果存在工具调用,程序应暂停生成回答,转而执行本地或远程的函数逻辑。获取结果后,再将结果作为一条新的“工具消息”回填给对话历史,并再次请求模型生成最终的自然语言回答。
def handle_function_call(messages, tools):
    # 第一次请求:让模型决定是否需要调用工具
    response = dashscope.Generation.call(
        model='qwen-plus',
        messages=messages,
        tools=tools,
        result_format='message'
    )

    assistant_message = response.output.choices[0].message

    # 检查是否有工具调用
    if hasattr(assistant_message, 'tool_calls') and assistant_message.tool_calls:
        tool_call = assistant_message.tool_calls[0]
        function_name = tool_call.function.name
        arguments = json.loads(tool_call.function.arguments)

        # 模拟执行外部函数
        if function_name == 'get_current_weather':
            weather_result = mock_weather_api(arguments['location'])

            # 将工具执行结果加入消息历史
            messages.append(assistant_message)
            messages.append({
                'role': 'tool',
                'name': function_name,
                'content': str(weather_result),
                'tool_call_id': tool_call.id
            })

            # 第二次请求:让模型基于工具结果生成最终回答
            final_response = dashscope.Generation.call(
                model='qwen-plus',
                messages=messages,
                result_format='message'
            )
            return final_response.output.choices[0].message.content

    return assistant_message.content
这种“两次交互”的模式是函数调用的核心。第一次交互用于决策和参数提取,第二次交互用于基于事实生成回答。边界在于,模型只能调用你明确定义的函数,且参数的准确性依赖于你的Schema定义质量。如果描述模糊,模型可能会遗漏必填参数或产生幻觉。
进阶融合:流式输出与函数调用的共存
在实际应用中,我们往往希望两者兼得:既要有工具执行的准确性,又要有流式输出的流畅体验。然而,这带来了一个技术挑战:在流式模式下,工具调用的信息也是分片返回的,我们需要先完整接收并解析出工具调用指令,执行完函数后,再将最终的回答以流式形式推送给用户。
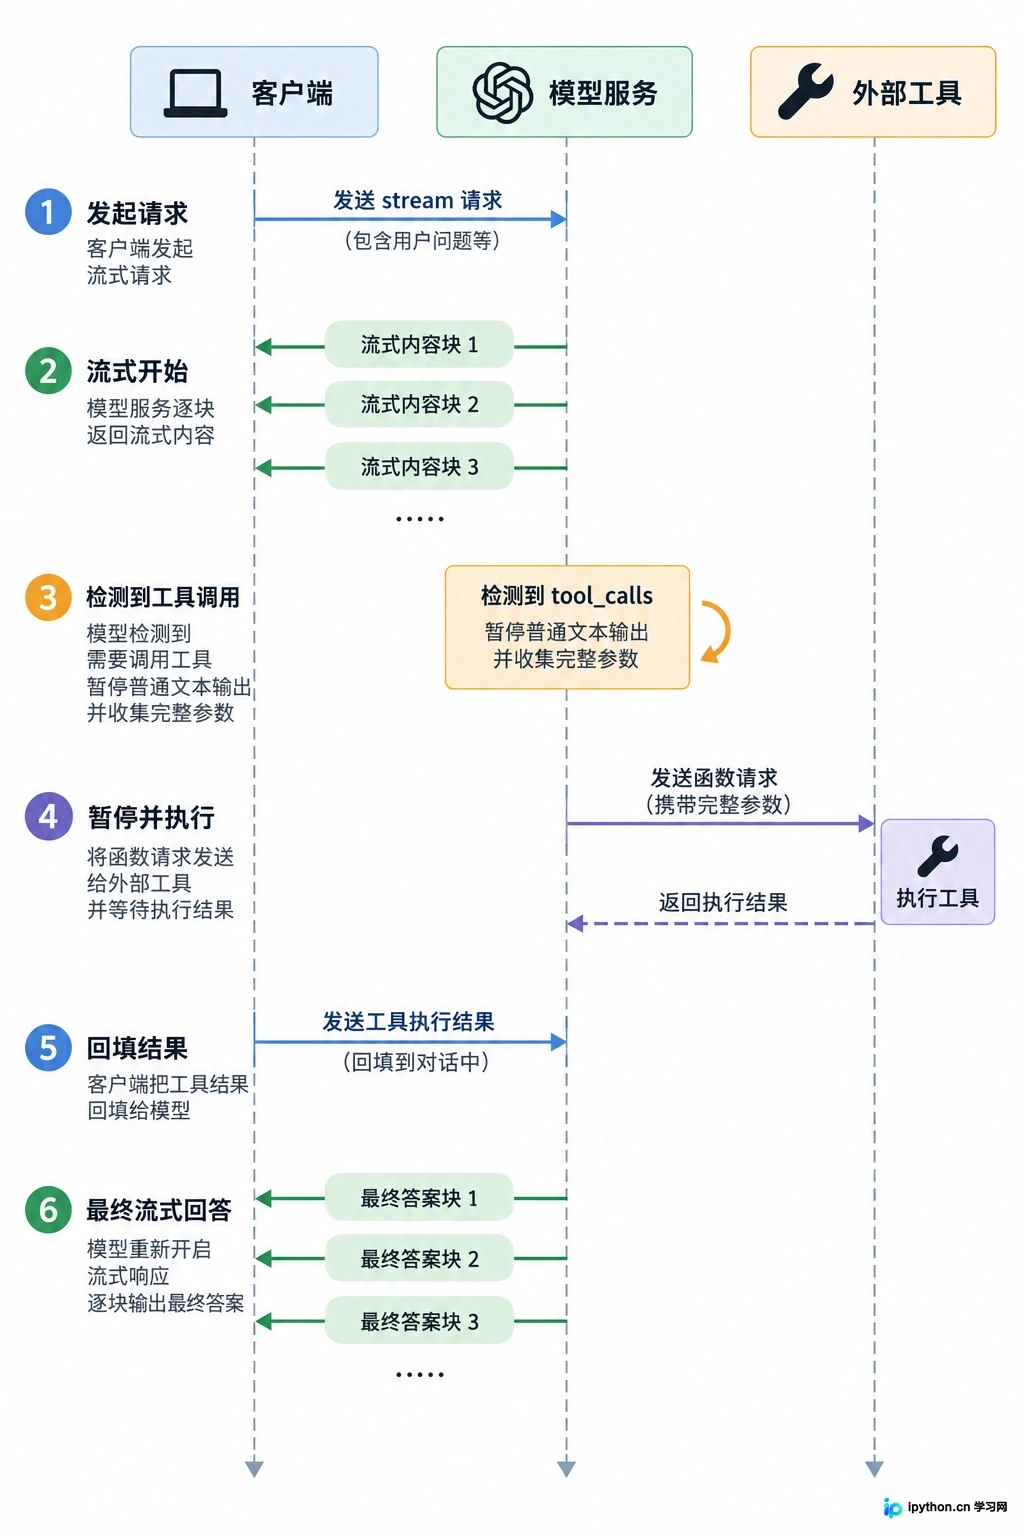
流式模式下处理工具调用与最终回答生成的时序关系
这意味着代码逻辑需要更加精细的状态管理。在接收到流式数据块时,首先要判断是否正在构建工具调用参数。一旦检测到工具调用结束,立即执行函数,然后在第二轮API调用中再次开启 stream=True,将最终结果流式传回前端。虽然逻辑复杂度增加,但这种组合提供了最佳的端到端体验:用户能看到模型“思考”和“查询”的过程(可以通过UI显示加载状态),并最终快速获得格式良好的答案。
通义千问API的这些高级特性,本质上是将大模型从一个黑盒聊天机器人,转变为一个可集成、可控制的应用组件。流式输出解决了人机交互的节奏问题,函数调用解决了模型与真实世界的数据隔阂。对于开发者而言,掌握这两者,就掌握了构建下一代智能应用的基石。不需要追求所有场景都上复杂逻辑,但在需要实时反馈和外部数据支持的场景中,这套组合拳是不可或缺的。
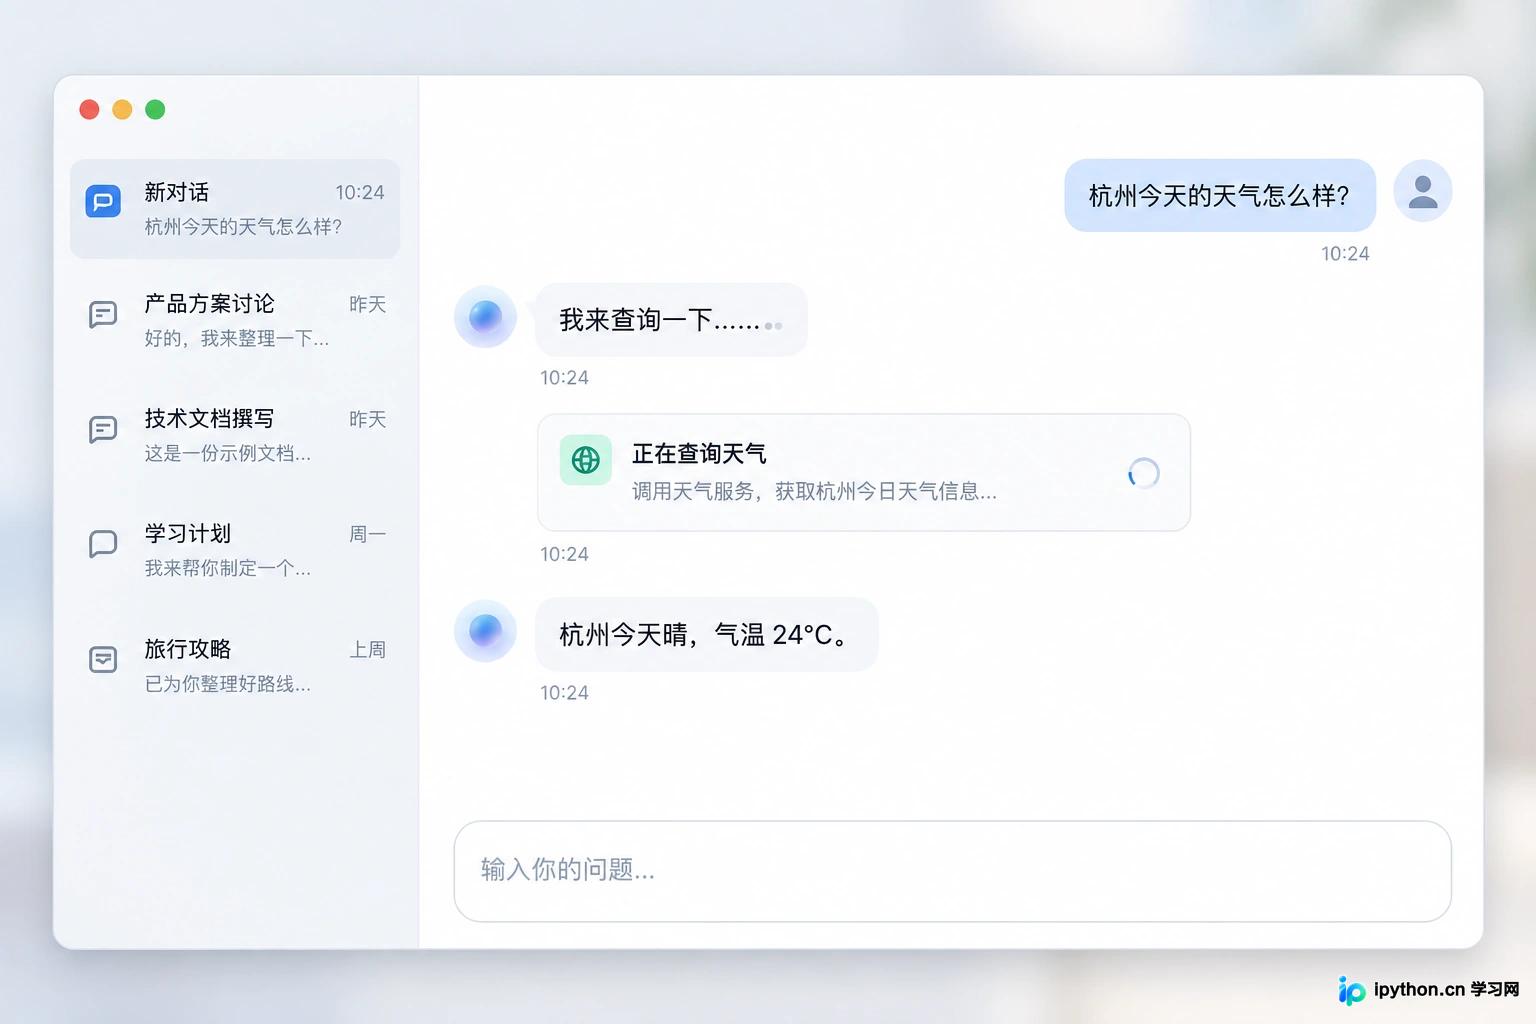
集成了流式回复和工具执行状态的现代化聊天界面
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









