

Python使用deep-translator库实现免费多语言翻译

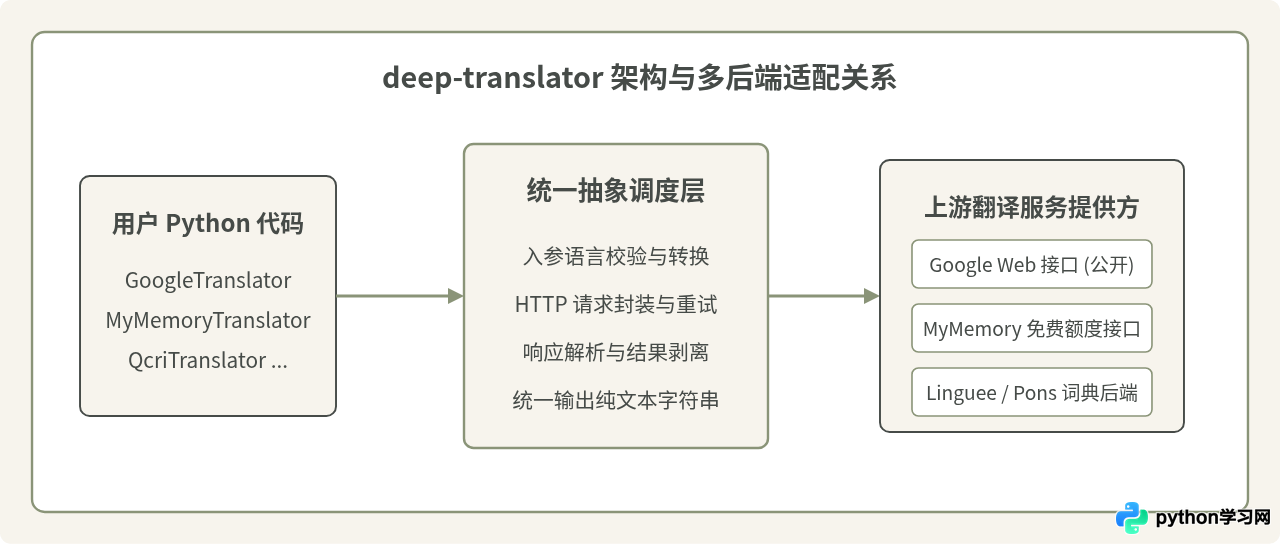
在日常数据处理、国际化文本生成或多语言内容清洗中,调用各大商业翻译API通常需要注册开发者账号、绑定信用卡并管理API密钥。而deep-translator是一个轻量且灵活的Python第三方库,它封装了包括Google Translate、MyMemory、Pons、Linguee等在内的多种翻译后端,允许开发者在无需繁琐凭证配置的前提下,直接通过几行简洁的代码完成多语言文本的高质量免费翻译。本文将介绍该库的安装配置、核心接口用法、批量处理技巧以及生产中的使用限制与应对策略。
一、库的安装与运行准备
deep-translator 托管在官方 PyPI 仓库中,依赖较少,安装流程十分直接。在终端中执行以下 pip 命令即可完成部署:
pip install deep-translator安装完成后,建议在 Python 交互环境或脚本中验证当前安装版本及基础环境是否可用:
import deep_translator
print(deep_translator.__version__)GoogleTranslator 后端调用的是 Google Translate 的公开 Web 接口,在特定网络环境下可能需要配置代理,否则请求可能会发生超时(Connection Timeout)。如果网络无法直连 Google,可切换为支持国内网络的 MyMemoryTranslator 或通过代理参数执行。
二、核心操作步骤与基础翻译实现
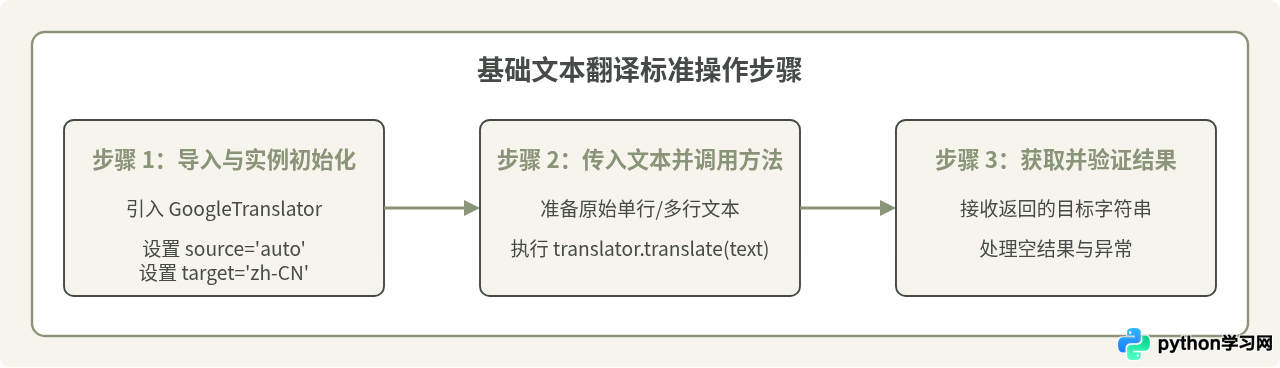
通过 deep-translator 实现翻译遵循“实例化翻译器、指定源语言与目标语言、调用翻译方法”的标准化三步流程。最常用的后端是 GoogleTranslator。
1. 单句翻译与自动源语言识别
以下示例演示将一段英文翻译为中文简体,其中 source='auto' 表示让库自动检测原句语种:
from deep_translator import GoogleTranslator

# 实例化翻译器,设置自动识别源语言,目标为中文简体
translator = GoogleTranslator(source='auto', target='zh-CN')

# 传入待翻译字符串
source_text = "Python makes data processing and automation simple and elegant."
translated_text = translator.translate(source_text)

print("原文:", source_text)
print("译文:", translated_text)
示例输出:
原文: Python makes data processing and automation simple and elegant.
译文: Python 使数据处理和自动化变得简单而优雅。
2. 查看支持的语言列表
为了防止传入未知的语言代码导致程序抛错,可以使用 get_supported_languages() 方法动态获取当前后端所支持的所有语言代码与名称:
from deep_translator import GoogleTranslator

# 获取支持的语言列表(默认返回语言名称)
langs = GoogleTranslator().get_supported_languages()
print(f"支持的语言数量: {len(langs)}")
print("部分支持语言示例:", langs[:8])

# 获取支持语言的字典映射形式(名称与 ISO 编码对照)
langs_dict = GoogleTranslator().get_supported_languages(as_dict=True)
print("中文简体对应代码:", langs_dict.get('chinese (simplified)'))
三、批量翻译与多后端切换
在处理列表数据或结构化文本时,反复单独调用翻译不仅开销大,还容易触发高频限流。deep-translator 提供了内置的批量列表翻译支持。同时,当某些翻译源不可用时,开发者可以平滑切换后端实现。
1. 批量列表翻译(translate_batch)
from deep_translator import GoogleTranslator

translator = GoogleTranslator(source='en', target='zh-CN')

text_list = [
    "Machine learning is transforming industries.",
    "Open source libraries empower developers worldwide.",
    "Fast delivery and high accuracy are essential."
]

# 批量翻译列表
results = translator.translate_batch(text_list)

for original, translated in zip(text_list, results):
    print(f"[{original}] -> [{translated}]")
2. 使用 MyMemoryTranslator 后端
当网络受限无法直接连通 Google 时,MyMemoryTranslator 是一种无需代理的优质免费替代方案。它的初始化参数基本一致,且支持传入联系邮箱提升每日免费查询配额:
from deep_translator import MyMemoryTranslator

# MyMemory 建议指定源语言与目标语言标准编码
mm_translator = MyMemoryTranslator(source='en-US', target='zh-CN')
res = mm_translator.translate("Hello, world!")
print("MyMemory 译文:", res)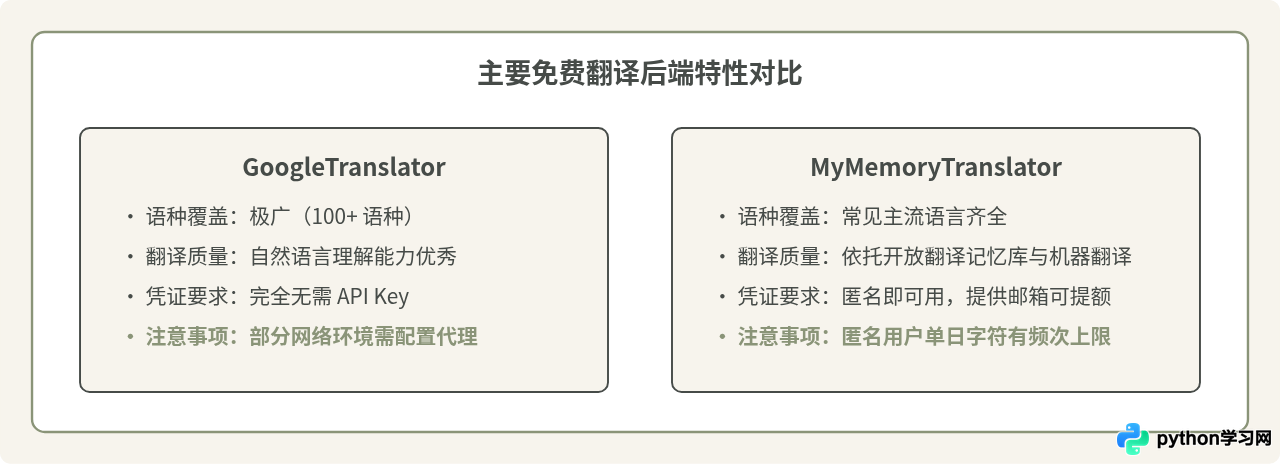
四、异常处理与使用边界
虽然 deep-translator 实现了免凭证免费翻译,但在生产脚本中直接使用时,需要清醒认识其底层机制。该库的“免费”本质上是通过模拟浏览器或调用各平台的公开免密端点完成的,因此必须注意以下两点约束:
- 单次字符长度限制: 公开 Web 端点通常限制单次请求文本在 5000 字符以内。超过该长度时,底层接口会直接拒绝或截断。
- 请求频率限制(Rate Limiting): 若在短时间内使用多线程或密集循环发起成百上千次调用,IP 地址极易被临时封禁,导致返回
TooManyRequestsException或连接中断。
因此,在编写长期运行的自动化脚本时,应加入异常捕获、文本分块机制以及请求间隔延时:
import time
from deep_translator import GoogleTranslator
from deep_translator.exceptions import TranslationNotFound, RequestError, TooManyRequestsException

def safe_translate(text, source='auto', target='zh-CN', delay=0.5):
    """
    具备基础防护与限流控制的翻译函数
    """
    # 针对超长文本进行字符数预警
    if len(text) > 4500:
        raise ValueError("文本超过单次请求安全长度(4500字符),请先拆分后再翻译。")

    try:
        translator = GoogleTranslator(source=source, target=target)
        result = translator.translate(text)
        # 加入轻微延时避免瞬时请求过密
        time.sleep(delay)
        return result
    except TooManyRequestsException:
        print("错误:请求过于频繁,被触发频率限制,建议增加休眠时间或更换代理IP。")
    except RequestError as e:
        print(f"网络请求故障: {e}")
    except TranslationNotFound:
        print("未找到有效翻译结果。")
    except Exception as e:
        print(f"发生意外异常: {e}")
    return None
五、总结与核心要点回顾
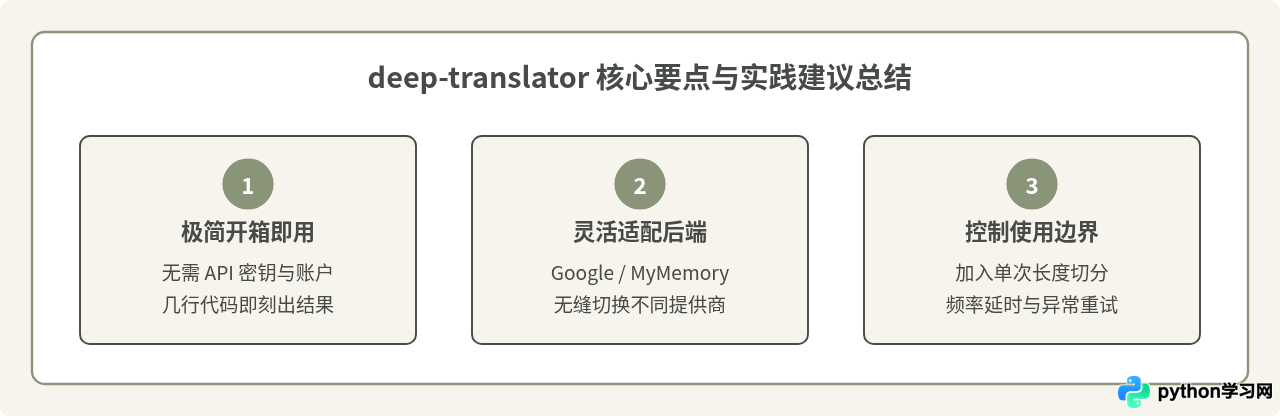
deep-translator 是 Python 生态中非常实用的文本工具,它把复杂的外部接口封装为一致的编程体验,免去了搭建认证体系的繁琐步骤。在小型脚本开发、多语言语料快速初筛、离线数据简单翻译等轻量级场景下,能够极大提升开发效率。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









