

Python时间序列数据分析方法:日期处理与趋势预测实现

在Python中进行时间序列数据分析,核心路径可以清晰地分为两步:第一步是将非结构化的字符串或混合时间戳标准化,构建高内聚的DatetimeIndex,并完成重采样与对齐;第二步是基于时序特征进行分解建模,提取趋势项并输出未来的定量预测值。本文将以Pandas与Statsmodels为核心支撑库,直接演示从原始日期清洗到经典趋势预测落地的完整代码与实施细节。
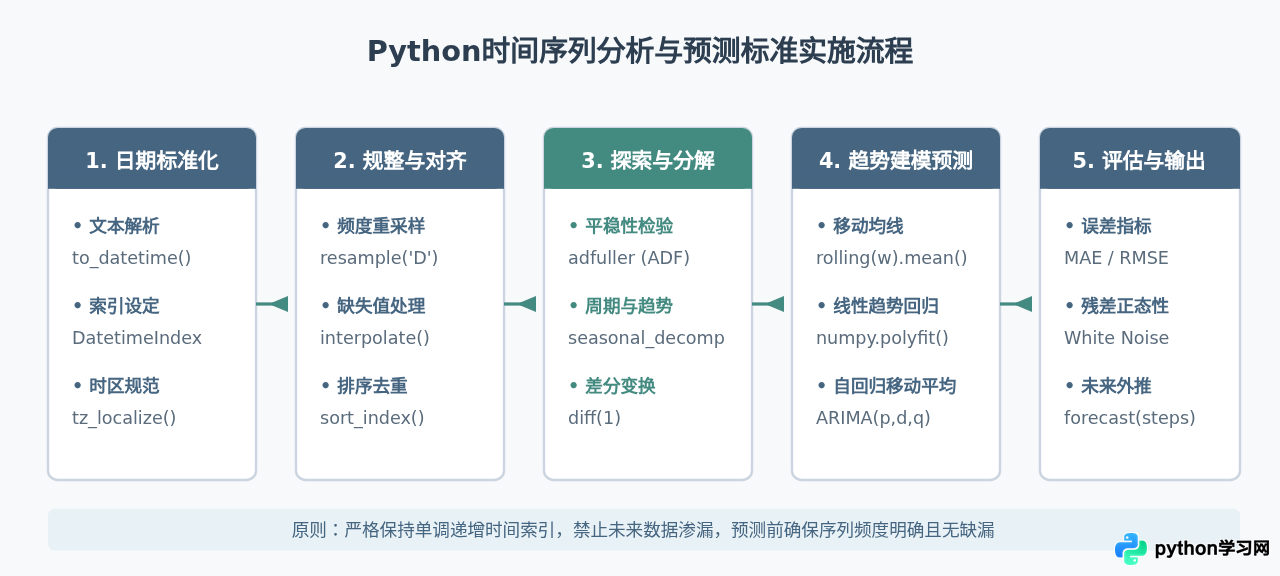
一、时间序列分析与预测全流程架构
许多初学者直接套用回归算法预测时序数据,容易出现时间穿越或均方误差失真的问题。严谨的时间序列处理流程由五个闭环阶段组成:原始序列标准化、时钟频度对齐、时序特征分解、趋势模型构建、以及残差诊断与度量。各阶段职责明确,上游输出直接决定下游模型的预测边界。
二、日期时间数据处理核心操作(Pandas实战)
日期时间处理是时序建模的基石。在多数业务系统中,日期通常以字符串形式存储(如 "2026-03-15 08:30:00" 或 Unix 时间戳)。必须将其转化为 Pandas 的 Timestamp 类型,并设置为索引以解锁时间切片、窗口运算和重采样能力。
1. 日期解析与类型转换
使用 pd.to_datetime() 解析日期字符串。当数据源存在脏数据时,务必设置 errors='coerce',将无法解析的异常文本转为 NaT(Not a Time),避免程序中断中断执行。
import pandas as pd
import numpy as np

# 模拟原始业务数据
raw_data = {
    'date_str': ['2026-01-01', '2026-01-02', '2026/01/03', 'invalid_date', '2026-01-05'],
    'value': [102.5, 105.0, 108.2, 99.0, 114.6]
}
df = pd.DataFrame(raw_data)

# 转换为标准时间序列格式
df['timestamp'] = pd.to_datetime(df['date_str'], errors='coerce')

# 剔除无效时间戳并设置索引
df = df.dropna(subset=['timestamp'])
df = df.set_index('timestamp').sort_index()

print("清洗后的索引类型:", type(df.index))
print(df)
2. 时间切片与频度重采样(Resample)
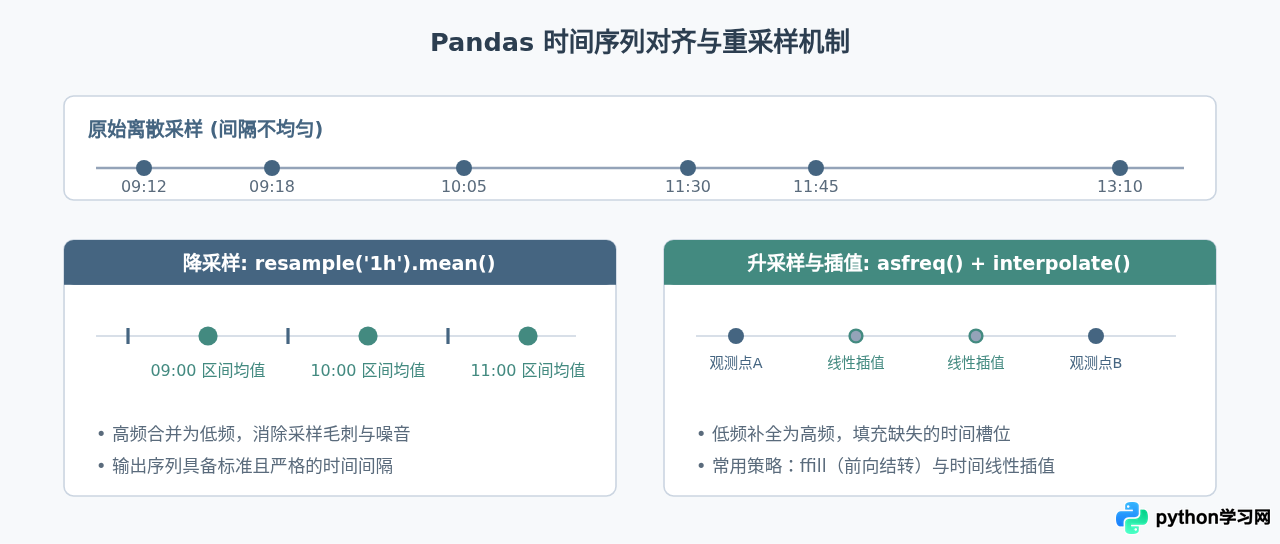
设置 DatetimeIndex 后,即可支持直观的时间切片语法(例如 df['2026-01'])。更关键的操作是频度重采样:将不规则或高频采样数据汇总至标准时间间隔。
- 降采样(Downsampling):例如将分钟级数据降采样为按天汇总,使用聚合函数如
mean()、sum()。 - 升采样(Upsampling):例如将天级数据扩展为小时级,需要选择合适的插值策略(如前向填充
ffill()或线性插值interpolate())。
3. 滑动窗口与滞后特征
在捕捉趋势之前,利用 rolling() 可以快速平滑短期波动,而 shift() 则用于构造时序分析中关键的自相关滞后项。
# 设定每日固定频度,补齐缺失日期
daily_ts = df['value'].resample('D').mean().interpolate(method='time')

# 计算 7 天滑动平均与滑动标准差(用于观察中短期趋势走势)
df_features = pd.DataFrame({'actual': daily_ts})
df_features['ma_7d'] = daily_ts.rolling(window=7, min_periods=1).mean()
df_features['std_7d'] = daily_ts.rolling(window=7, min_periods=1).std()

# 构造滞后 1 阶特征(前一日值)
df_features['lag_1'] = daily_ts.shift(1)
三、时序特征与趋势成分分解
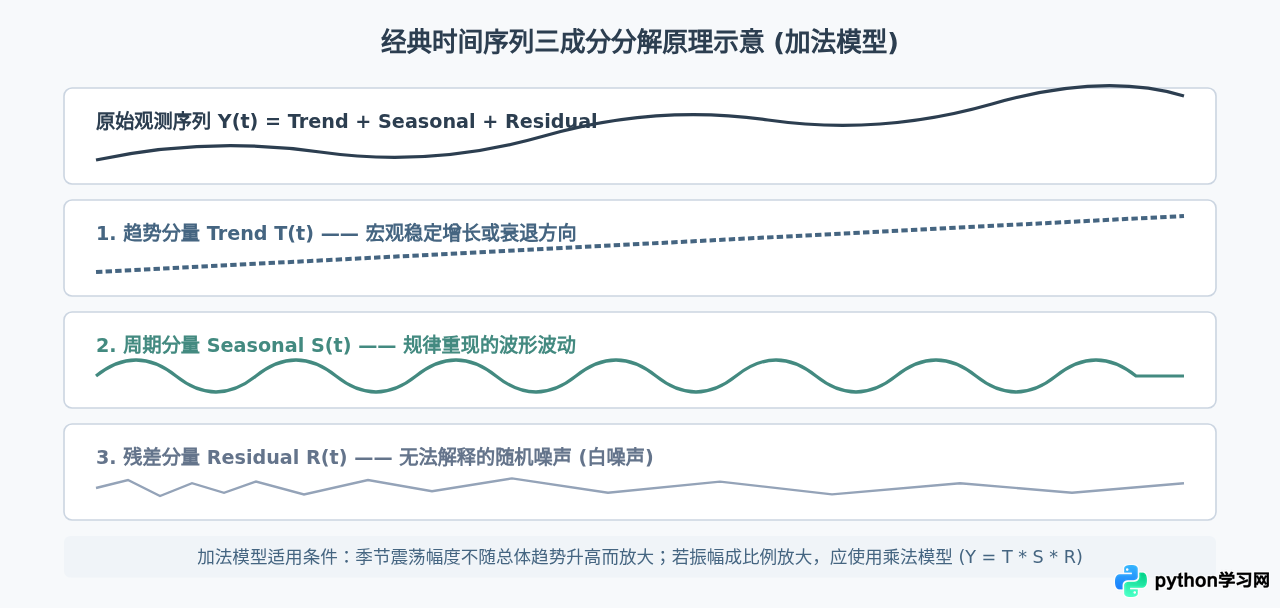
真实的时间序列数据通常不是单一形态,而是由多种动力机制混合而成。经典时间序列分解理论将观测序列 $Y_t$ 拆解为三大部分:
- 趋势项(Trend, $T_t$):长期的上升或下降态势,反映整体发展规律。
- 季节项/周期项(Seasonal, $S_t$):固定或可复现的周期性震荡(如按周、按季或按年重现的规律)。
- 残差项(Residual/Noise, $R_t$):剔除趋势和周期后的随机扰动项。理想状态下应为均值为0的白噪声。
代码实现:Statsmodels 时序分解
from statsmodels.tsa.seasonal import seasonal_decompose

# 假定 daily_series 为完整无缺失的天级时间序列,设置周期 period=7 (周周期)
decomposition = seasonal_decompose(daily_ts, model='additive', period=7)

trend = decomposition.trend
seasonal = decomposition.seasonal
residual = decomposition.resid

# 趋势项两端由于卷积滤波会出现 NaN,分析时注意丢弃
valid_trend = trend.dropna()diff(1) 消除趋势后再建模。
四、趋势预测模型的具体实现
针对时间序列的趋势预测,根据业务场景的严苛程度,主要有三类实现策略:简单几何趋势外推法(适合单调稳定趋势)、自回归移动平均模型(ARIMA,适合具备统计相关性的序列),以及组合时序预测。以下给出可复现的完整代码实现。
方法 1:多项式/线性趋势回归外推法
当序列主要体现为确定性趋势(如稳定的季度业绩持续攀升),可将时间点序号作为自变量,建立线性或二次曲线回归。
import numpy as np

# 1. 构造时间数字坐标轴
y = daily_ts.values
n = len(y)
x = np.arange(n)

# 2. 拟合一阶线性方程: y = slope * x + intercept
slope, intercept = np.polyfit(x, y, deg=1)

# 3. 向未来外推 14 个步长 (14天)
future_steps = 14
x_future = np.arange(n, n + future_steps)
trend_forecast = slope * x_future + intercept

# 4. 生成未来日期索引
last_date = daily_ts.index[-1]
future_dates = pd.date_range(start=last_date + pd.Timedelta(days=1), periods=future_steps, freq='D')
forecast_series = pd.Series(trend_forecast, index=future_dates)

print("未来7天线性预测趋势:")
print(forecast_series.head(7))
方法 2:ARIMA(p, d, q) 趋势预测实现
ARIMA(AutoRegressive Integrated Moving Average)整合了自回归项(p)、差分阶数(d)与滑动平均误差(q),是经典时序分析的标准工具。通过引入差分项 $d=1$,模型能自动捕捉序列的漂移趋势并向未来延展。
from statsmodels.tsa.arima.model import ARIMA
from sklearn.metrics import mean_squared_error, mean_absolute_error

# 划分训练集与测试集 (最后 14 天作为验证)
train = daily_ts.iloc[:-14]
test = daily_ts.iloc[-14:]

# 构建 ARIMA 模型:此处设定阶数 (p=1, d=1, q=1)
# 实际项目中可借助 AIC/BIC 最小化准则自动化网格搜索最优超参数
model = ARIMA(train, order=(1, 1, 1))
model_fit = model.fit()

# 向后预测 14 个步长
forecast_res = model_fit.get_forecast(steps=14)
predicted_mean = forecast_res.predicted_mean
conf_int = forecast_res.conf_int(alpha=0.05)  # 95% 置信区间

# 评估预测准确度
rmse = np.sqrt(mean_squared_error(test, predicted_mean))
mae = mean_absolute_error(test, predicted_mean)

print(f"验证集 RMSE: {rmse:.3f}, MAE: {mae:.3f}")
模型评估指标对比
| 评估指标 | 计算公式核心 | 特点与适用场景 |
|---|---|---|
| MAE (平均绝对误差) | $\frac{1}{n}\sum |y_i - \hat{y}_i|$ | 直观表达真实误差的平均水平,对异常离群值不敏感。 |
| RMSE (均方根误差) | $\sqrt{\frac{1}{n}\sum (y_i - \hat{y}_i)^2}$ | 平方放大较大误差,对模型偶尔出现的重大预测失误极其敏感。 |
| MAPE (平均绝对百分比误差) | $\frac{1}{n}\sum |\frac{y_i - \hat{y}_i}{y_i}| \times 100\%$ | 相对比例度量,跨尺度业务对比首选(但真实值为0时不适用)。 |
五、生产实践中的关键注意事项与总结
在落地时间序列分析系统时,仅掌握代码并不足以保证预测结果的可靠。以下是工程实践中最常踩坑的要点与选型指南:
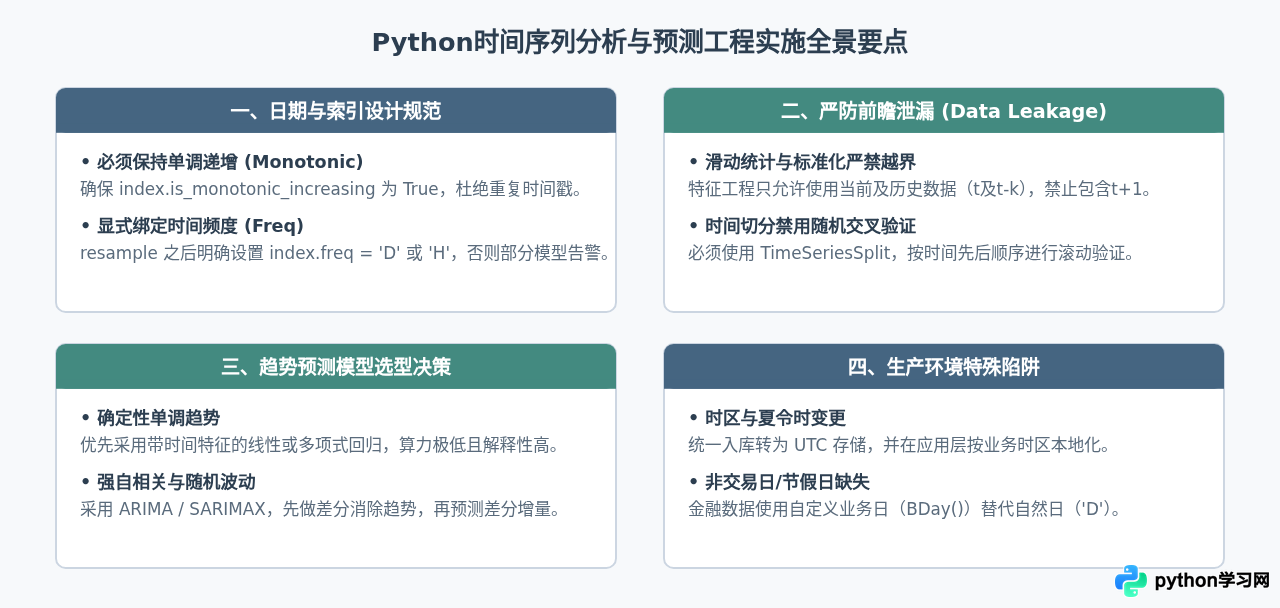
to_datetime()、resample()、seasonal_decompose() 与差分回归有机结合,能以极高稳定性支撑绝大多数日常趋势预测与业务决策需求。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









