

Python实现AES加密解密:详解CBC/GCM模式、IV生成与填充处理

在对称加密应用中,AES(高级加密标准)是数据保密传输与落盘存储的基石。在 Python 工程落地中,正确使用 AES 的关键往往不在于调用加密函数本身,而在于理解工作模式(CBC 与 GCM)的运行机理、严格保证初始向量(IV)的密码学随机性,以及准确处理块密码所必需的数据对齐填充。本文将直入核心,拆解各个机制的技术细节并提供规范完整的实现方案。
一、AES 的核心机制与关键要素
AES 是分组密码(Block Cipher),其固定分组大小为 128 位(16 字节)。无论选择哪种密钥长度(AES-128、AES-192 或 AES-256),每次内部变换操作处理的数据块始终是 16 字节。在实际工程中,加密的数据长度通常不是 16 字节的整数倍,而且往往远大于单个分组。这就引出了分组密码的两个核心衍生概念:填充机制与工作模式。
在实现 AES 保护之前,需要明确三个技术要素:
- 密钥(Key):对称算法要求加密和解密使用同一私密密钥。密钥长度必须严格匹配模式参数,128 位密钥对应 16 字节,256 位对应 32 字节。
- 初始向量(IV / Nonce):引入初始向量的目的是打破相同明文块生成相同密文块的确定性规律,确保即便多次加密相同的明文,输出密文也完全不同。
- 工作模式(Mode):定义了多个数据分组之间如何协作加密。最常见的两种传统与现代模式是 CBC(密码分组链接模式)和 GCM(伽罗瓦/计数器模式)。
在 Python 生态中,目前工业级推荐的标准密码学库是 cryptography。早期的 pycrypto 已长期无人维护,而 pycryptodome 虽常用但维护口径存在分歧。本文所有示例均采用底座坚固、合规性更高的 cryptography 官方标准 API 实现。通过命令 pip install cryptography 即可完成依赖安装。
二、填充处理:PKCS#7 机制与对齐逻辑
像 CBC 这样要求以固定 16 字节分组为基本单位的工作模式,如果输入明文长度不是 16 的倍数,在送入加密器前必须补充若干字节达到对齐要求,这一过程就是填充(Padding)。而在解密完成后,又必须能够准确无误地识别并移除这些补充字节。
国际通用的工业标准是 PKCS#7 填充(其在 8 字节块时对应 PKCS#5,对 16 字节块统称为 PKCS#7)。PKCS#7 的规则非常清晰且具有自解释性:
- 计算缺少的字节数
pad_len = 16 - (len(data) % 16)。 - 若缺少
N个字节(1 ≤ N ≤ 15),则在数据末尾填充N个值为N的单字节(如缺少 3 字节,追加0x03 0x03 0x03)。 - 全块补全原则:若原始数据恰好是 16 字节的整数倍(即
len(data) % 16 == 0),必须额外追加一整块由 16 个0x10(十进制 16)组成的填充块。如果不追加,解密方读取末尾字节时将无法区分该字节属于原始数据还是填充标志。
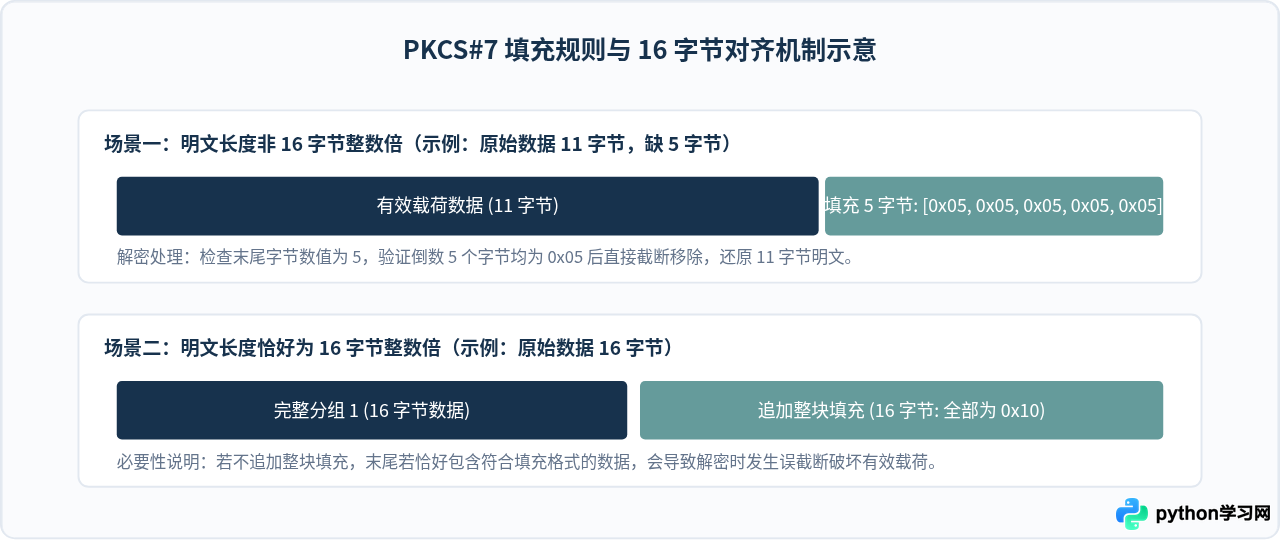
在 cryptography 库中,填充与去填充由 padding.PKCS7(128) 对象管理(此处 128 指的是算法的块位宽 128-bit,即 16 字节)。在调用时,通过其 padder() 和 unpadder() 进行流式对齐和校验处理。
三、初始向量(IV / Nonce)的安全生成与存储
初始向量(IV)或随机数(Nonce)是保证对称加密安全的核心防线。在加密协议设计中,对于 IV 必须牢记以下三条硬性原则:
- 绝对不能使用伪随机生成器:严禁使用 Python 语言自带的标准库
random生成 IV。random模块使用的是梅森旋转算法(Mersenne Twister),其内部状态在观察到一定数量的输出后即可被完全推导,属于非密码学安全随机。必须且只能使用系统级的安全熵源,如os.urandom()或secrets.token_bytes()。 - 同密钥下不可重用:在 CBC 模式下,重用 IV 会泄露首个明文分组的信息;在 GCM 模式下,同密钥重用 IV/Nonce 更会导致灾难性的安全崩塌——攻击者可直接推导出鉴别密钥,进而随意伪造密文。
- IV 无需保密,但需完整传输:IV 不是私钥,不需要进行加密。常见的做法是将生成的固定长度 IV(如 CBC 需 16 字节,GCM 推荐 12 字节)直接拼接在密文头部(
IV + Ciphertext),解密端直接根据固定字节长度切片解析。
四、Python 实现 AES-CBC 模式加密与解密
CBC(Cipher Block Chaining)模式的工作机制是串行的:每个明文块在送入 AES 加密前,先与前一个密文块进行按位异或(XOR)运算;首个明文块则与初始向量(IV)进行异或。解密时则执行相反过程,密文块先经过 AES 解密,再与前一个密文块(或 IV)异或得到明文。
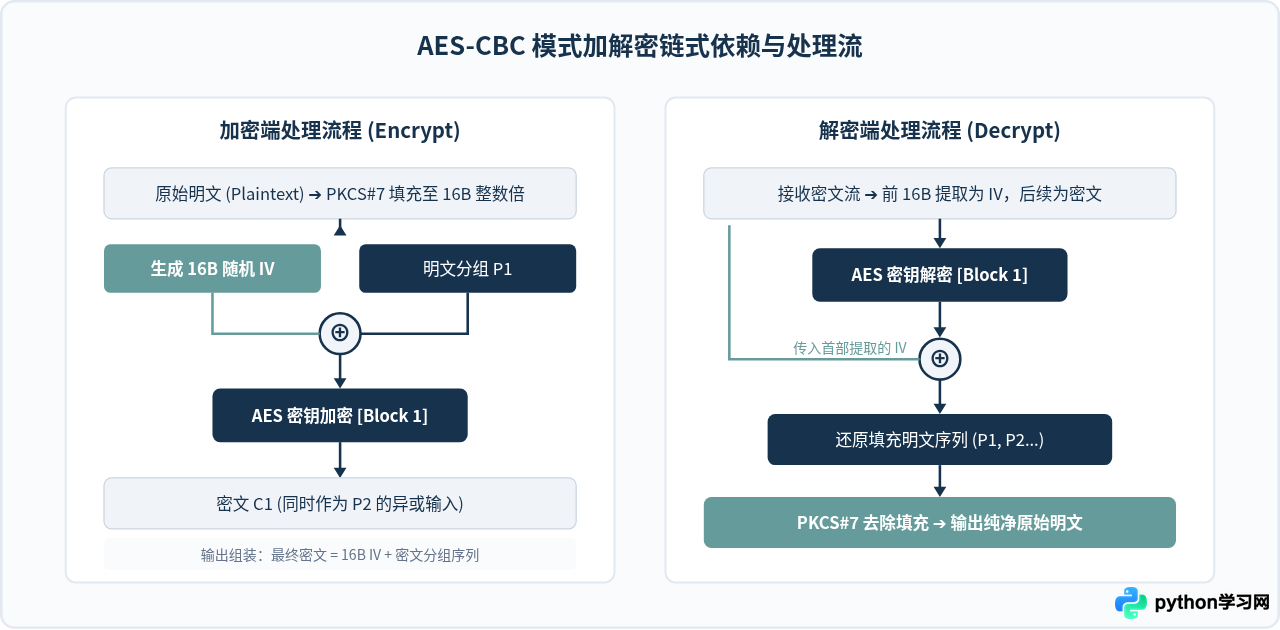
下面是完整的 AES-CBC 加密与解密可执行代码。代码实现了密钥长度自检、密码学随机 IV 生成、PKCS#7 自动填充与去填充,以及将 IV 与密文无缝合并存储的完整闭环:
import os
from cryptography.hazmat.primitives.ciphers import Cipher, algorithms, modes
from cryptography.hazmat.primitives import padding
from cryptography.hazmat.backends import default_backend

def aes_cbc_encrypt(plaintext: bytes, key: bytes) -> bytes:
    """
    使用 AES-CBC 模式加密数据。
    :param plaintext: 待加密的原始字节数据
    :param key: 对称密钥(16/24/32 字节,分别对应 AES-128/192/256)
    :return: 拼接了 16 字节 IV 的完整密文数据 (IV + Ciphertext)
    """
    if len(key) not in (16, 24, 32):
        raise ValueError("密钥长度必须是 16、24 或 32 字节。")

    # 1. 生成 16 字节密码学安全的初始向量 IV
    iv = os.urandom(16)

    # 2. 对明文执行 PKCS#7 填充,使其长度为 16 字节的倍数
    padder = padding.PKCS7(128).padder()
    padded_data = padder.update(plaintext) + padder.finalize()

    # 3. 创建加密器并执行加密
    cipher = Cipher(algorithms.AES(key), modes.CBC(iv), backend=default_backend())
    encryptor = cipher.encryptor()
    ciphertext = encryptor.update(padded_data) + encryptor.finalize()

    # 4. 将 IV 附加在密文前端便于解密提取
    return iv + ciphertext

def aes_cbc_decrypt(encrypted_data: bytes, key: bytes) -> bytes:
    """
    使用 AES-CBC 模式解密数据。
    :param encrypted_data: 包含 16 字节 IV 前缀的密文数据
    :param key: 对称密钥
    :return: 解密并去除填充后的原始明文
    """
    if len(key) not in (16, 24, 32):
        raise ValueError("密钥长度必须是 16、24 或 32 字节。")
    if len(encrypted_data) < 32:
        raise ValueError("密文数据长度不合法,至少包含 16 字节 IV 和 16 字节数据块。")

    # 1. 拆分 IV 与真实密文
    iv = encrypted_data[:16]
    ciphertext = encrypted_data[16:]

    # 2. 创建解密器还原带填充的明文
    cipher = Cipher(algorithms.AES(key), modes.CBC(iv), backend=default_backend())
    decryptor = cipher.decryptor()
    padded_plaintext = decryptor.update(ciphertext) + decryptor.finalize()

    # 3. 校验并移除 PKCS#7 填充
    unpadder = padding.PKCS7(128).unpadder()
    plaintext = unpadder.update(padded_plaintext) + unpadder.finalize()

    return plaintext

# 验证执行
if __name__ == "__main__":
    test_key = os.urandom(32)  # AES-256 密钥
    raw_message = "加密工程实践:深入解析 CBC 与 GCM 模式".encode("utf-8")

    # 加密
    encrypted = aes_cbc_encrypt(raw_message, test_key)
    print(f"CBC 密文总长度: {len(encrypted)} 字节(含 16 字节 IV)")

    # 解密
    decrypted = aes_cbc_decrypt(encrypted, test_key)
    assert decrypted == raw_message
print(f"CBC 解密结果成功: {decrypted.decode('utf-8')}")五、Python 实现 AES-GCM 模式认证加密
GCM(Galois/Counter Mode)是现代密码学中最受推崇的认证加密模式(AEAD, Authenticated Encryption with Associated Data)。它结合了计数器模式(CTR)的高性能流式加密与伽罗瓦域(Galois Field)的高效消息认证码(GMAC)。
相比于传统的 CBC 模式,GCM 具有两大颠覆性优势:
- 无需任何填充(无需 PKCS#7):底层采用 CTR 计数器派生密钥流与明文进行异或。输入明文是多少字节,输出密文就是多少字节,彻底杜绝了填充机制和填充预言机攻击。
- 内置防篡改认证标签(Tag):加密过程在输出密文的同时,基于多项式计算生成一个 16 字节(128 位)的认证标签(Authentication Tag)。任何针对密文或关联数据(AAD)的篡改,都会导致解密时验签失败并立即拒绝输出任何明文。
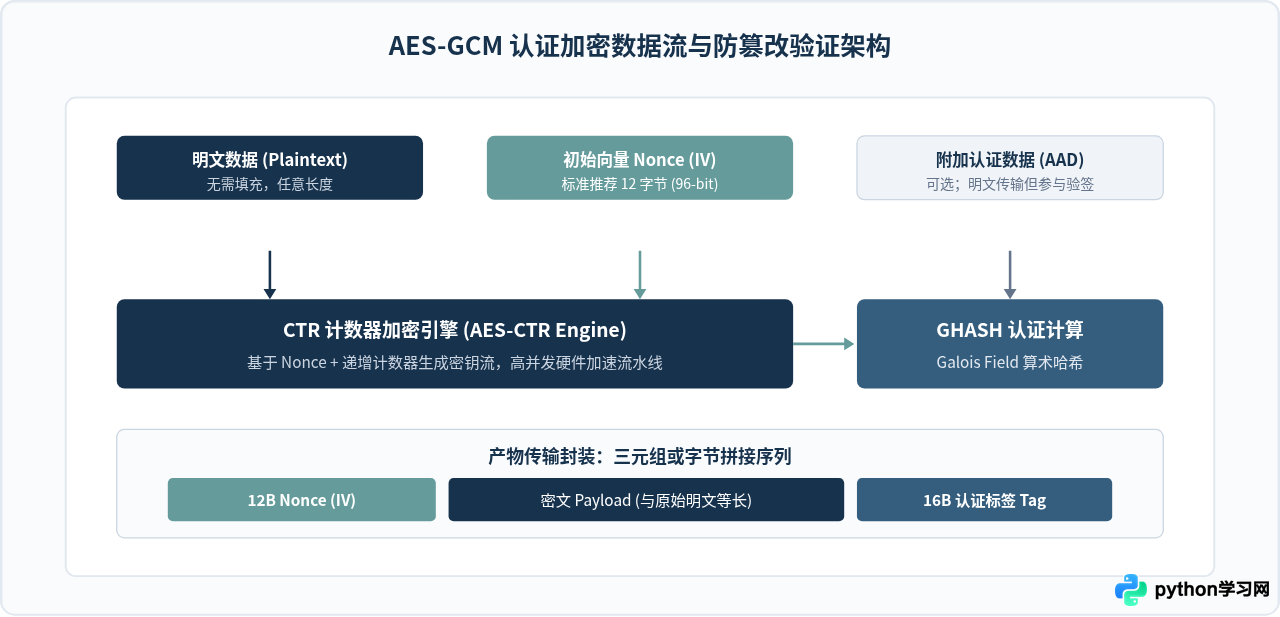
在 GCM 规范中,推荐的 Nonce 长度为 12 字节(96 位)。如果使用非 12 字节的 Nonce,加密库在内部必须额外运行 GHASH 运算将其压缩或扩展为 12 字节,这不仅徒增计算开销,还可能增加碰撞风险。
以下为完整的 AES-GCM 加密、解密与防篡改验证实现代码:
import os
from cryptography.hazmat.primitives.ciphers import Cipher, algorithms, modes
from cryptography.hazmat.backends import default_backend
from cryptography.exceptions import InvalidTag

def aes_gcm_encrypt(plaintext: bytes, key: bytes, associated_data: bytes = None) -> bytes:
    """
    使用 AES-GCM 模式加密数据(内置 16 字节认证标签)。
    :param plaintext: 待加密的原始字节数据(无需填充)
    :param key: 对称密钥(16/24/32 字节)
    :param associated_data: 可选的附加认证数据 (AAD),参与认证但不加密
    :return: 拼接格式密文 (12 字节 Nonce + 16 字节 Tag + 真实密文)
    """
    if len(key) not in (16, 24, 32):
        raise ValueError("密钥长度必须是 16、24 或 32 字节。")

    # 1. 生成标准的 12 字节(96 位)安全随机 Nonce
    nonce = os.urandom(12)

    # 2. 构建 GCM 加密器
    cipher = Cipher(algorithms.AES(key), modes.GCM(nonce), backend=default_backend())
    encryptor = cipher.encryptor()

    # 3. 注入附加认证数据(若有)
    if associated_data:
        encryptor.authenticate_additional_data(associated_data)

    # 4. 执行加密(流式处理,长度无需对齐)
    ciphertext = encryptor.update(plaintext) + encryptor.finalize()

    # 5. 提取 16 字节认证标签
    tag = encryptor.tag

    # 6. 打包输出:Nonce(12B) + Tag(16B) + 密文
    return nonce + tag + ciphertext

def aes_gcm_decrypt(encrypted_data: bytes, key: bytes, associated_data: bytes = None) -> bytes:
    """
    使用 AES-GCM 模式解密并强校验完整性。
    :param encrypted_data: 包含 Nonce(12B) 与 Tag(16B) 前缀的数据流
    :param key: 对称密钥
    :param associated_data: 加密时声明的附加认证数据
    :return: 验签通过的原始明文
    :raises InvalidTag: 密文或标签遭受哪怕 1 个比特的篡改时抛出
    """
    if len(key) not in (16, 24, 32):
        raise ValueError("密钥长度必须是 16、24 或 32 字节。")
    if len(encrypted_data) < 28:
        raise ValueError("密文数据长度不合法,至少包含 12 字节 Nonce 和 16 字节 Tag。")

    # 1. 解析头部固定长度元数据
    nonce = encrypted_data[:12]
    tag = encrypted_data[12:28]
    ciphertext = encrypted_data[28:]

    # 2. 构建 GCM 解密器并传入 tag
    cipher = Cipher(algorithms.AES(key), modes.GCM(nonce, tag), backend=default_backend())
    decryptor = cipher.decryptor()

    # 3. 注入解密校验所需的附加认证数据
    if associated_data:
        decryptor.authenticate_additional_data(associated_data)

    # 4. 解密与完整性验签(若校验失败,finalize 会自动抛出 InvalidTag)
    try:
        plaintext = decryptor.update(ciphertext) + decryptor.finalize()
        return plaintext
    except InvalidTag:
        raise ValueError("解密失败:数据完整性校验失败,密文或认证数据已被篡改!")

# 验证执行与防篡改测试
if __name__ == "__main__":
    test_key = os.urandom(32)
    sample_text = "企业级核心配置: GCM 认证加密无填充传输".encode("utf-8")
    aad = b"user-id:9527"

    # 正常加解密
    bundle = aes_gcm_encrypt(sample_text, test_key, associated_data=aad)
    recovered = aes_gcm_decrypt(bundle, test_key, associated_data=aad)
    assert recovered == sample_text
    print(f"GCM 认证解密成功: {recovered.decode('utf-8')}")

    # 模拟网络篡改密文中的 1 个字节
    tampered_bundle = bytearray(bundle)
    tampered_bundle[-1] ^= 0xFF  # 翻转最后一位
    try:
        aes_gcm_decrypt(bytes(tampered_bundle), test_key, associated_data=aad)
    except ValueError as e:
        print(f"防篡改拦截验证成功: {e}")
六、CBC 与 GCM 选型决策与安全实践指南
在实际项目做技术选型时,工程师应根据具体的安全合规要求、硬件执行环境及上下游系统兼容性做出客观评估。
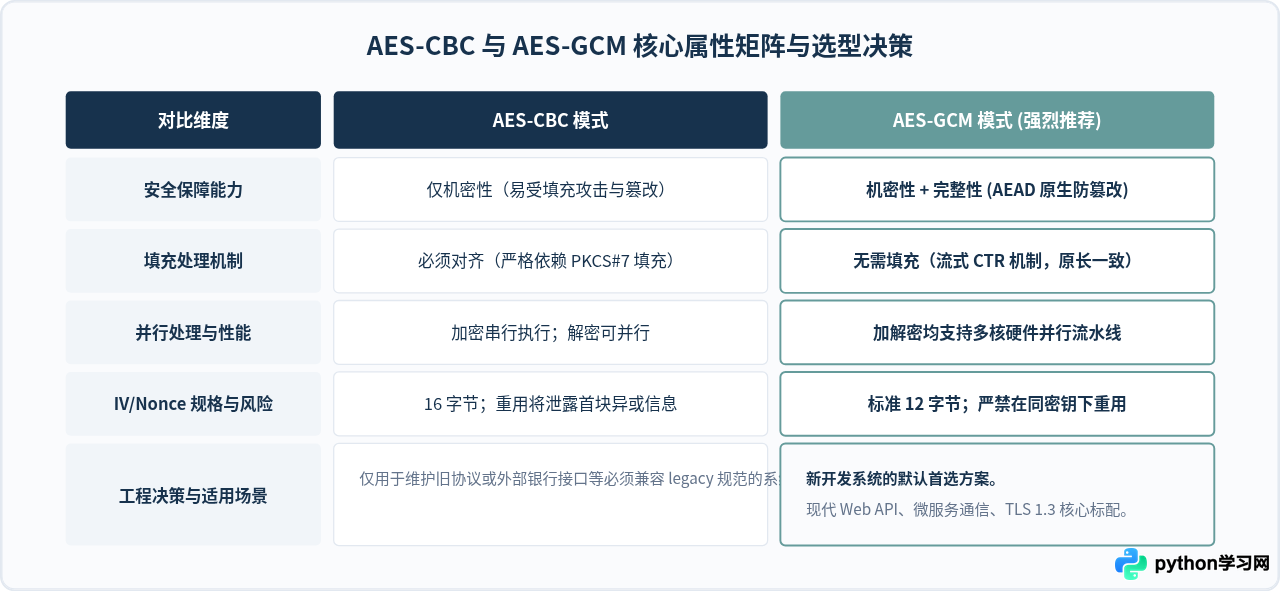
工程实践安全核对清单
| 检查项 | 正确规范要求 | 高危反例做法 |
|---|---|---|
| 随机数生成源 | 使用 os.urandom() 或 secrets.token_bytes() |
使用 random.randint() 或固定的静态字符串 |
| IV / Nonce 生命周期 | 每次加密都动态生成全新向量,直接明文拼接在密文头部 | 整个应用全局共享一个单例 IV,或长期固化在配置文件 |
| 密钥管理 | 使用专用密钥管理服务(KMS/Vault)或受控环境变量加载 | 将明文密钥直接硬编码在业务源码或 Git 仓库中 |
| 数据完整性 | 优先选择 GCM;若被迫使用 CBC,需采用 Encrypt-then-MAC (HMAC) | 裸用 CBC 接收不受信网络的密文请求并解密 |
| 字符编码 | 对输入文本统一以 UTF-8 转换为 bytes,绝不传递原生 str |
跨系统传输时隐式依赖平台默认编码 |
七、常见排查问题与避坑指南
在日常开发与联调时,常会遇到各类加解密异常,以下是两类最容易出现的问题与对应根因:
1. 解密提示 ValueError: Invalid padding bytes.
在 CBC 解密时发生此报错,90% 以上的原因是解密密钥不匹配、IV 字节发生错位,或者传输过程中密文字节遭到了意外截断。AES-CBC 解密出的结果是一堆乱码,最后 1 个字节极大概率不满足 PKCS#7 校验逻辑,解密库因此抛出填充损坏错误。
2. GCM 抛出 cryptography.exceptions.InvalidTag
此错误代表认证标签验证不通过。请按以下顺序排查:
- 解密时传入的
associated_data是否与加密时传入的完全一致(哪怕差一个换行符也会导致验签失败)。 - 检查切片时的字节偏移量,确保 Nonce 严格截取前 12 字节,Tag 严格截取接下来的 16 字节。
- 检查网络传输组件是否对二进制流进行了非法字符转义或篡改(跨 HTTP/JSON 传输建议统一包装为 Base64 字符串)。
通过遵循上述规范,开发者能够在 Python 环境中快速构建出既满足高性能、又具备严密抗攻击能力的现代数据加解密服务。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









