

Python中==与is的区别:相等性运算符与身份运算符辨析

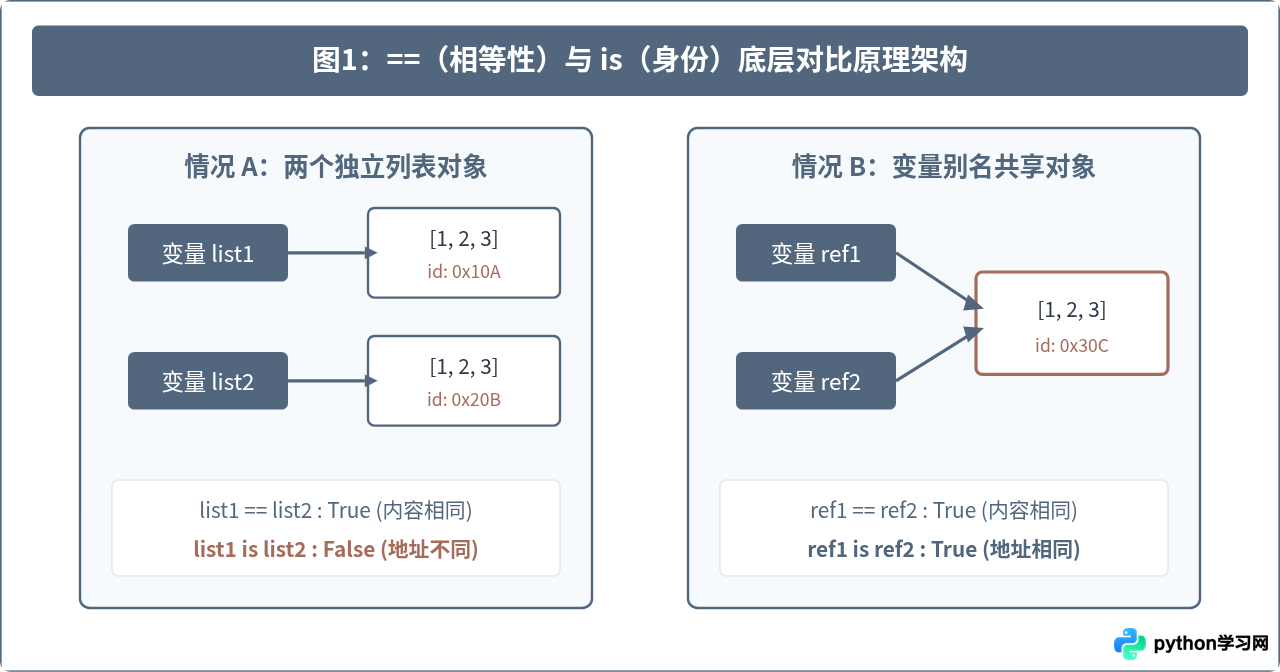
在 Python 中,== 与 is 都常被用来对比两个变量,但它们关心的核心问题截然不同:== 是相等性运算符(Equality Operator),用来比较两个对象所包含的内容或数值是否相等;而 is 是身份运算符(Identity Operator),用来判断两个变量是否引用自内存中的同一个对象。简单概括就是:== 比较“长得是否一样”,is 比较“是不是同一个物体”。理解这一差别是编写稳健 Python 代码并避免诡异逻辑 Bug 的基本功。
一、核心概念:内容相等与内存身份
在 Python 的对象模型中,每一个对象都拥有三个核心属性:身份标识(Identity)、数据类型(Type)以及值(Value)。变量本身并不直接存放数据,而是作为贴在对象上的“标签”或指针。
当我们执行 a == b 时,Python 会调用对象内部的 __eq__ 特殊方法,逐一对比二者的字段与数值。只要业务逻辑上定义的属性相等,无论它们在内存中处于哪个角落,== 均会返回 True。
而执行 a is b 时,Python 比较的是两个变量所指向的内存首地址。通过内置函数 id(obj) 可以获取该对象唯一的整数标识(在 CPython 实现中即为对象的内存物理地址)。a is b 完全等价于 id(a) == id(b)。
二、直观代码验证:可变对象测试
列表(list)作为典型的可变数据结构,最能体现两者的边界。我们可以通过一个简短的交互示例进行观察:
# 示例代码:通过列表观察 == 与 is
list_a = [1, 2, 3]
list_b = [1, 2, 3]
list_c = list_a

print(f"list_a id: {id(list_a)}")
print(f"list_b id: {id(list_b)}")
print(f"list_c id: {id(list_c)}")

print("list_a == list_b:", list_a == list_b)  # 示例输出: True
print("list_a is list_b:", list_a is list_b)  # 示例输出: False
print("list_a is list_c:", list_a is list_c)  # 示例输出: True
在这个示例中:
list_a和list_b虽然内部元素完全一样,但它们是通过独立的列表字面量创建的。解释器为它们分配了两块独立的内存堆空间,因此id(list_a) != id(list_b),list_a is list_b返回False。- 赋值语句
list_c = list_a并不会复制列表数据,仅仅是将list_c这个引用指向现有的list_a所在内存,因此list_a is list_c返回True。如果此时修改list_c.append(4),list_a也会同步发生改变。
三、选择判断步骤:在开发中该用哪一个?
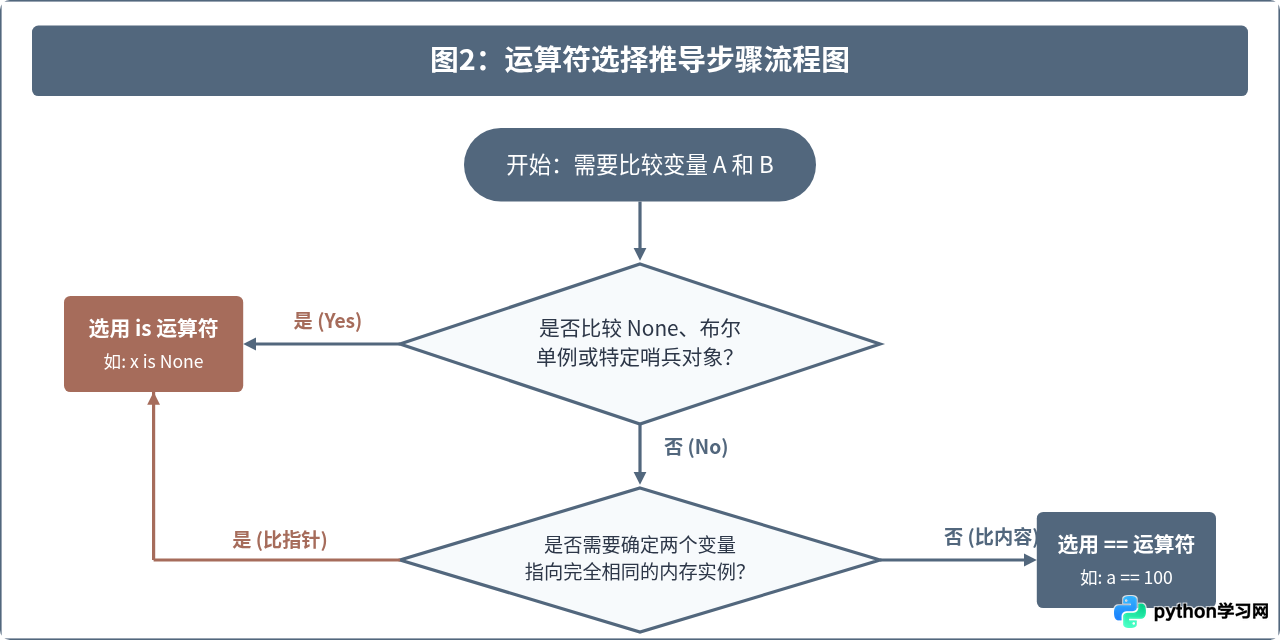
在编写业务逻辑时,很多初学者容易误用 is 来代替 ==。为了在实际编码中做出正确选择,可以遵循下面的推导流程:
四、深陷误区:小整数与字符串驻留(Interning)的障眼法
很多 Python 初学阶段的开发者之所以混淆 == 和 is,是因为在交互式终端(REPL)或者简单数字测试中,它们常常给出看似完全一样的返回值:
# 看似等价的现象
x = 10
y = 10
print(x == y)  # 示例输出: True
print(x is y)  # 示例输出: True (令人困惑的返回)

m = 1000
n = 1000
print(m == n)  # 示例输出: True
print(m is n)  # 示例输出: False (在部分环境或逐行执行中)
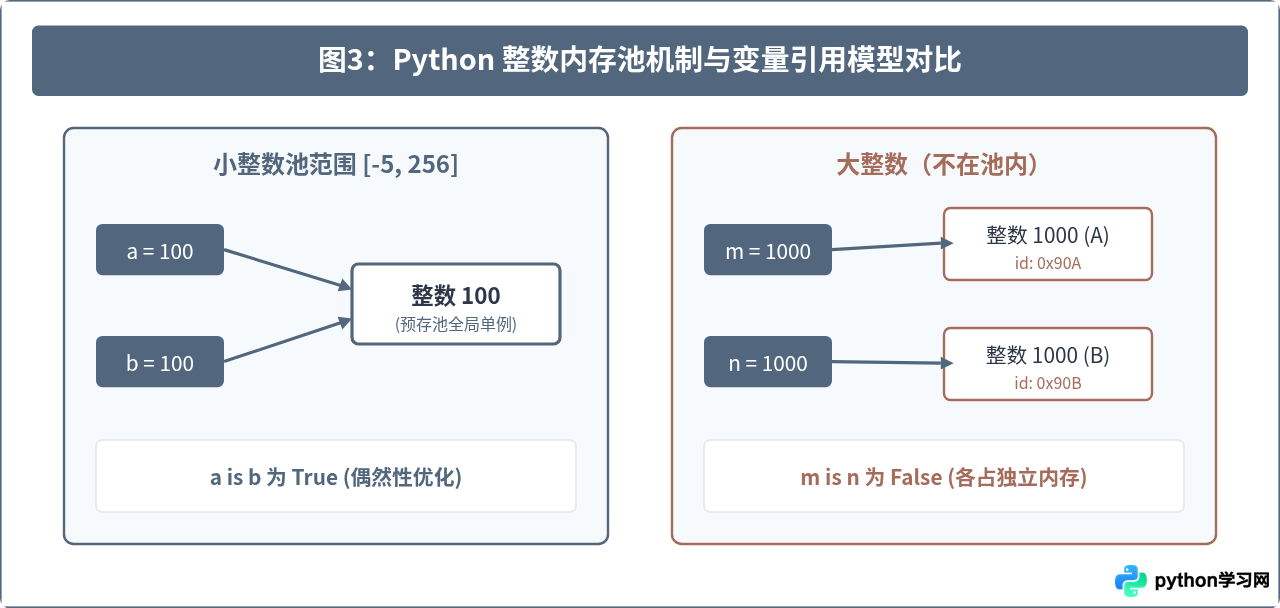
为什么 10 is 10 是 True,而 1000 is 1000 可能是 False?
这是因为 CPython 解释器内部实现了一项性能优化机制——小整数对象池(Integer Cache)。Python 在启动时,会自动预先创建范围在 [-5, 256] 之间的整数对象,并将它们常驻内存。当你在代码中声明这个范围内的数字时,Python 不会创建新对象,而是直接把变量指向已经缓存好的那个对象。因此,对于属于该区间的整数,其内存地址永远相同。
类似地,Python 还对符合标识符命名规则的短字符串实行字符串驻留机制(String Interning)。但这完全属于底层实现细节,并没有任何语言标准保证其跨版本或跨平台的一致性。绝不能依赖驻留机制使用 is 来比较数值或文本内容。
五、为什么比较 None 必须坚持用 is?
在 PEP 8(Python 官方代码风格指南)中有一条明确规定:像 None 这类单例对象的比较,应该总是使用 is 或 is not,决不要使用等号运算符。
这一要求的背后有两个重要原因:
- 语言级单例保障:在整个 Python 进程生命周期中,
None是NoneType唯一的单例对象。内存中有且仅有一处None,因此判断是否为None就是最纯粹的身份确认。 - 防止
__eq__被恶意重载或引发意外行为:由于==会触发目标对象的__eq__魔术方法,如果某个自定义类重载了__eq__,它完全可能在与None进行==比较时返回出人意料的结果甚至抛出异常:
# 示例代码:重载 __eq__ 带来的相等性失真
class MisbehavedObject:
    def __eq__(self, other):
        # 故意让 == 比较总是返回 True
        return True

bad_inst = MisbehavedObject()

print(bad_inst == None)  # 示例输出: True (逻辑彻底错乱!)
print(bad_inst is None) # 示例输出: False (正确识别出并不是 None)is 作为底层指针比对指令(字节码 COMPARE_OP (is) 或专有指令),不需要函数调用栈开销,执行速度远快于需要进行方法分发的 ==。
六、总结与对比速查
为了加深记忆并便于日常速查,我们将相等性运算符与身份运算符的核心特征归纳如下:
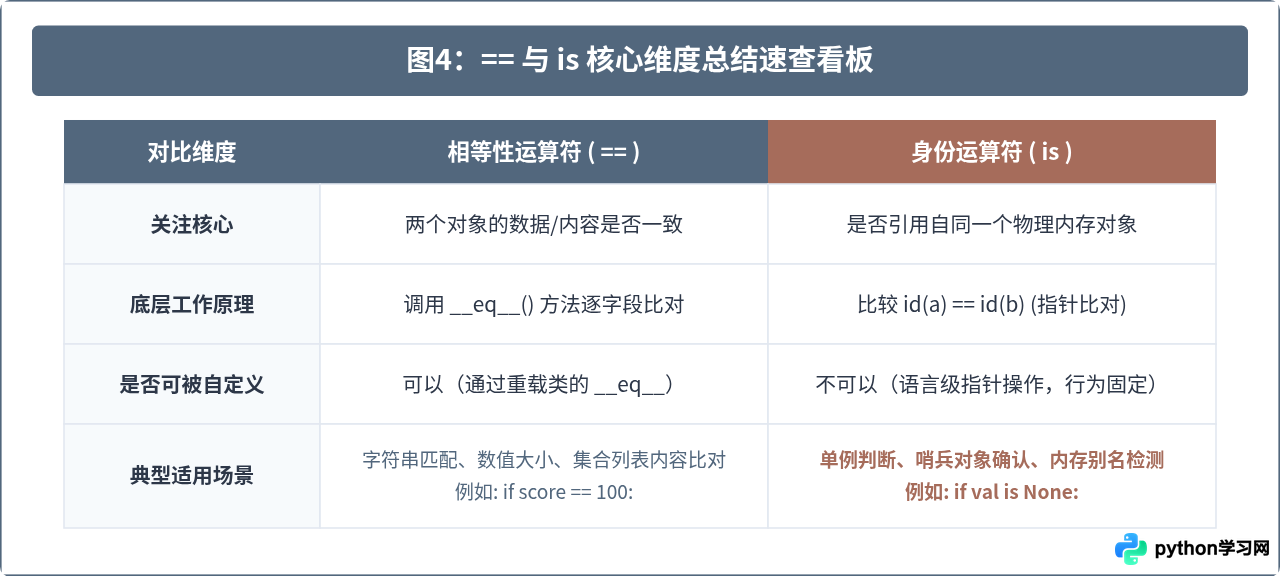
在实际编码中,只要牢记一条黄金法则:绝大多数比较业务数据值的时候,使用 ==;唯独在判断 None、特定单例对象或者确认两个变量是否指向完全相同的同一份内存实体时,才使用 is。遵循这一准则,就能彻底避开 Python 身份比较与相等性判断中的各种隐蔽陷阱。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









