

Python常用数据结构使用场景指南:何时用列表、字典或集合

发布时间:2026-10-22| 5人浏览过
分类:Python 核心基础 / 开发指南 · 预计阅读时间:8 分钟
在 Python 编程中,选对内置数据结构是写出高效、清晰代码的第一步。列表(list)、字典(dict)和集合(set)是最基础也是使用最频繁的三种容器。判定使用哪一个的核心依据只有三点:数据是否依赖先后顺序、是否需要按自定义唯一键快速查值,以及是否要求元素唯一且需要高效做归属判断。
一、核心选型总览:一目了然的决策路径
在动手写业务逻辑前,面对批量数据,可以按照以下三个关键问题逐步推导,明确该用哪种数据结构:
- 问题 1(是否需要键值映射):每个数据项是否由一个“名称/标识符”与一个“具体数值”绑定?如果是,优先选用字典(dict)。
- 问题 2(是否需要去重或高频判定存在):如果数据不需要成对映射,且核心诉求是排重或极速判断
x in collection,选用集合(set)。 - 问题 3(是否依赖先后次序或按位置访问):如果数据允许重复,需要严格保留读入/追加顺序,或者要通过下标
data[0]提取,选用列表(list)。
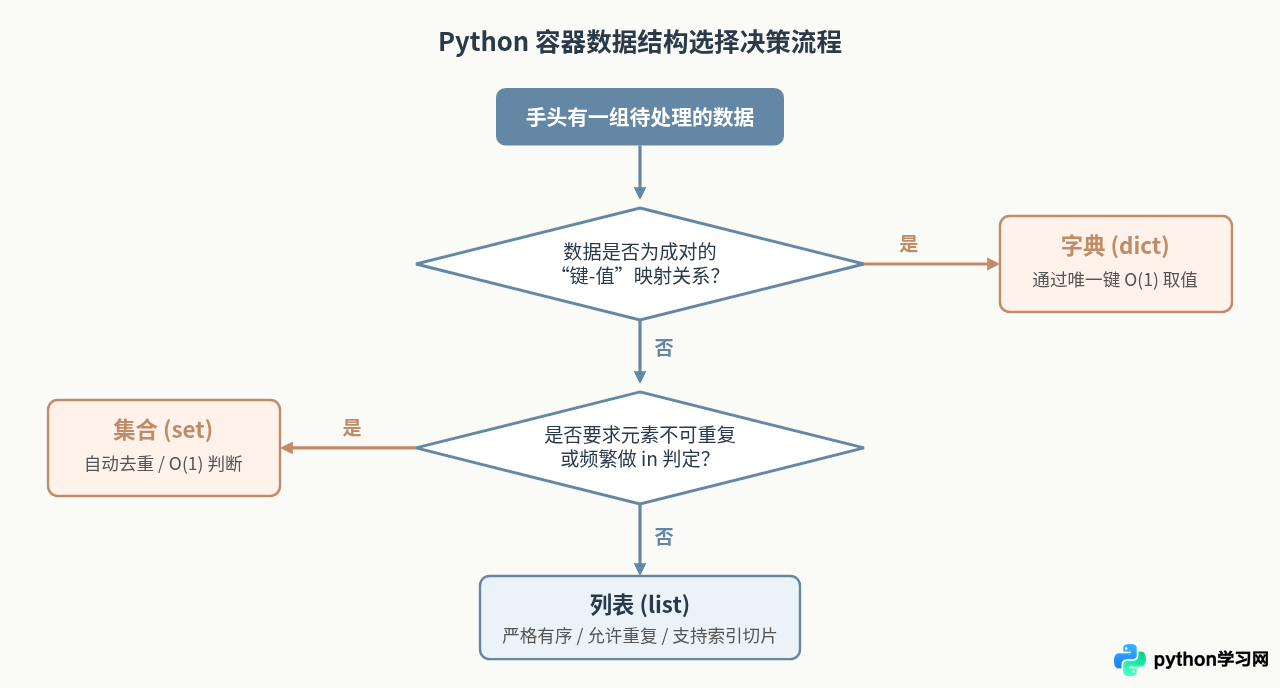
图 1:Python 基础数据结构选择流程图
二、列表(list):有序序列与动态流水线
列表是 Python 中最通用也是最容易上手的数据结构。在底层实现上,Python 的 list 是一个连续内存指针数组,每个槽位存放指向具体对象的内存地址。
1. 什么时候该用列表
- 需要维持固定的前后顺序:例如任务流水线、按时间排队的消息日志、操作历史记录撤销栈等。
- 需要频繁使用整数索引或切片:比如提取前 10 个数据
items[:10]、读取最后一个元素items[-1]。 - 数据允许重复出现:例如用户的多次浏览点击记录、传感器连续采集的温度读数。
- 操作集中在末尾追加:使用
append()将数据加入末端,具有极高且稳定的性能。
2. 代码示例:有序流处理
# 示例:日志收集与最近访问流水线
recent_logs = []

# 按产生顺序追加
recent_logs.append({"time": "10:00:01", "event": "login"})
recent_logs.append({"time": "10:00:05", "event": "view_page"})
recent_logs.append({"time": "10:00:12", "event": "click_ad"})

# 利用索引与切片获取最新 2 条记录
latest_events = recent_logs[-2:]
print("最新动作:", [item["event"] for item in latest_events])
# 示例输出: 最新动作: ['view_page', 'click_ad']
避坑提醒:不要在庞大列表(如几十万项)中反复使用
if x in my_list:。在列表中查找元素必须从第 0 个逐一比对到最后一个(时间复杂度为 O(n)),如果置于循环内部,整体耗时会急剧飙升至 O(n²)。
三、字典(dict):高效检索与属性建模
字典是 Python 中极其重要的数据结构。它是基于哈希表实现的键值对(Key-Value)容器。从 Python 3.7 开始,字典在官方规范中已经默认保留键的插入顺序。
1. 什么时候该用字典
- 需要通过特定标识符瞬间定位内容:例如通过“用户ID”获取用户资料、通过“订单编号”检索订单详情。
- 描述具象实体或配置参数:当一个对象包含多个不同维度的属性时,用字典清晰且灵活。
- 统计频次与建立倒排索引:例如统计文本词频(Word Count)或按分类将元素分组汇聚。
2. 代码示例:键值检索与频次聚合
# 示例:快速属性映射与词频计数
user_table = {
    "uid_101": {"name": "张三", "role": "admin"},
    "uid_102": {"name": "李四", "role": "editor"},
}

# 无论数据表中有多少万条记录,通过 key 定位耗时恒定 O(1)
current_user = user_table.get("uid_101")
print(f"当前用户: {current_user['name']},权限: {current_user['role']}")

# 场景:频次统计
word_counts = {}
sample_words = ["python", "dict", "list", "dict", "set", "dict"]
for word in sample_words:
    word_counts[word] = word_counts.get(word, 0) + 1
print("统计结果:", word_counts)
# 示例输出: 统计结果: {'python': 1, 'dict': 3, 'list': 1, 'set': 1}
限制条件:字典的“键(Key)”必须是可哈希(不可变)对象,如字符串、数字或元组;不能用列表或字典作为键。如果需要键具有复杂对象特征,应先转换为不可变类型。
四、集合(set):去重过滤与高效归属判定
集合是一个无序且元素不可重复的容器。其底层同样依赖哈希散列表,可以看作是一个“所有 Value 都为空”的精简字典。
1. 什么时候该用集合
- 海量数据去重:消除重复项最快捷的代码就是
list(set(raw_data))(注意:此操作不保证原列表顺序)。 - 高频成员检查(Membership Testing):判断某个元素是否属于黑名单、已处理列表等场景。在集合中执行
item in set的耗时几乎不随集合规模增长,平均时间复杂度为 O(1)。 - 数学逻辑运算:需要快速计算两个数据群体的交集(共同好友)、并集(所有用户)、差集(未完成清单)时,集合提供了原生的操作符。
2. 代码示例:去重、过滤与集合运算
# 示例:权限比对与重复数据过滤
staff_roles = {"admin", "finance", "auditor"}
user_permissions = {"editor", "finance"}

# 判断是否有交集(即是否包含任意核心权限)
has_core_access = bool(staff_roles & user_permissions)
print("具备关键管理权限:", has_core_access)

# 查出用户缺少的权限(差集)
missing_roles = staff_roles - user_permissions
print("缺失的角色:", missing_roles)
# 示例输出: 缺失的角色: {'admin', 'auditor'}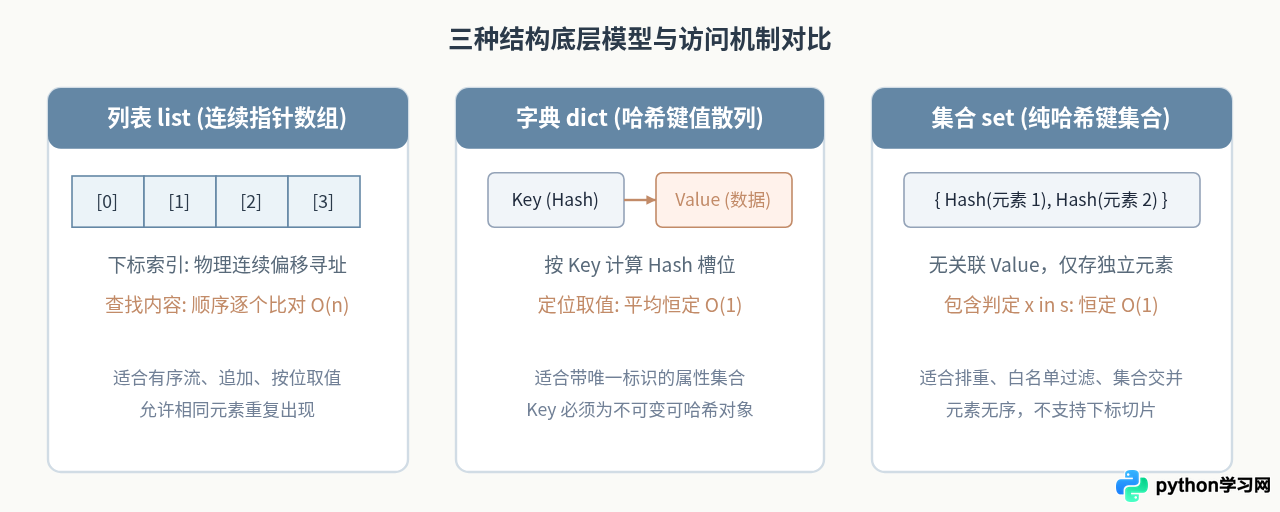
图 2:列表、字典与集合底层存储与访问机制
五、性能与时间复杂度对比
在小规模数据(几十个元素)下,三种容器的耗时差异几乎无法感知;但在处理万级、百万级数据时,选错数据结构可能导致运行时间从数毫秒剧增到数十分钟。
下表归纳了常见操作在各数据结构下的平均时间复杂度:
| 操作类型 | 列表 (list) | 字典 (dict) | 集合 (set) | 核心原因与考量 |
|---|---|---|---|---|
| 按索引/键取值 | O(1) [通过下标] | O(1) [通过键] | 不支持 | 列表通过内存地址偏移计算;字典通过键哈希直接定位。 |
判断元素是否存在 (x in col) |
O(n) | O(1) [查键] | O(1) | 列表必须遍历全表;字典和集合通过哈希计算直达槽位。 |
| 新增单项 | O(1) [末尾追加] / O(n) [头部插入] | O(1) | O(1) | 在列表头部插入会导致后续所有元素在内存中后移。 |
| 删除单项 | O(n) [按值删除或前部弹出] | O(1) [按键删除] | O(1) [按值删除] | 列表删除中间元素后需要搬移后续指针填充空洞。 |
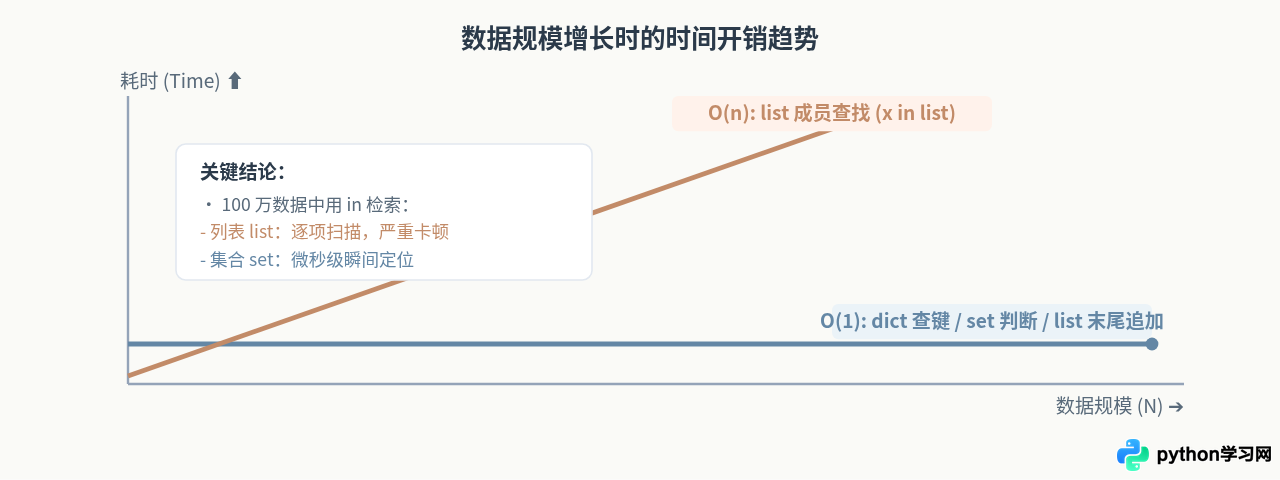
图 3:常见操作在不同数据规模下的耗时表现差异
六、经典实战场景选型速查
在日常业务开发中,不同场景通常有固定的最佳选型模式:
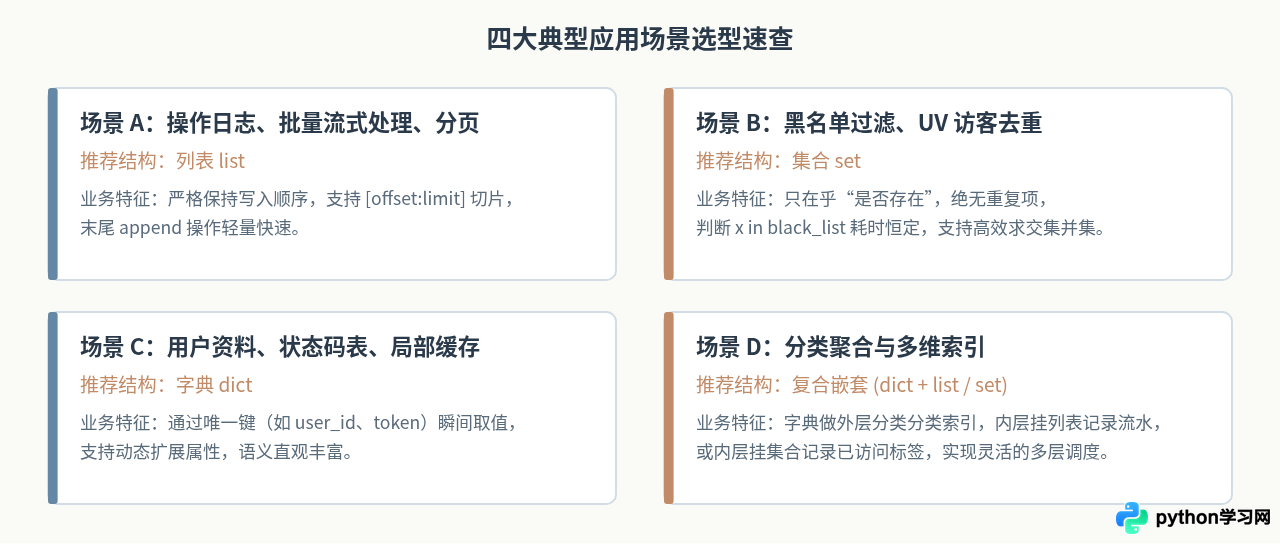
图 4:常见工程业务场景选型速查矩阵
七、容易忽视的三个实操陷阱
-
陷阱一:为了去重简单使用
list(set(data))破坏了原始顺序。
set是无序结构,转为集合后再转回列表,原有的排队顺序会被打乱。如果业务要求“去重但严格保留首次出现的次序”,可以使用list(dict.fromkeys(data))。由于 Python 3.7+ 字典保证插入顺序,这种写法既能实现去重,又完全保留原有顺序。 -
陷阱二:在庞大循环中在列表头部
insert(0, item)。
列表在头部插入数据会导致底层数组将已有元素整体往后搬移一位,时间复杂度为 O(n)。如果存在高频的两端进出需求,应该使用标准库中的collections.deque(双端队列),其首尾操作均为 O(1)。 -
陷阱三:试图用可变对象(如列表、字典)作为字典的 Key 或集合的元素。
哈希表要求键必须拥有固定不变的哈希值。如果将list放入set,会直接引发TypeError: unhashable type: 'list'。正确的做法是先将列表转为元组tuple(my_list)再存入集合或作为字典键。
八、总结简析
在 Python 日常开发中选择容器,不需要生搬硬套复杂的架构模式,只需记住三个问答原则:
- 有明确的 Key,按名称找内容 ➔ 选字典 dict;
- 要去除重复项,或只关心“在不在里面” ➔ 选集合 set;
- 关注前后位置、顺序读写、需要切片下标 ➔ 选列表 list。
理解它们各自的底层工作机制与时间复杂度,不仅能写出运行更平稳高效的代码,也能让程序逻辑更加自然清晰。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









