

Python操作数据库入门:sqlite3标准库与常用驱动对比

在 Python 生态中,操作关系型数据库并不需要一上来就安装复杂的独立服务。Python 官方内置了轻量易用的 sqlite3 标准库,同时在早期的 PEP 249 中制定了统一的数据库接口规范(Python Database API Specification v2.0,简称 DB-API 2.0)。无论是使用文件型单机库 SQLite,还是通过第三方驱动连接 MySQL、PostgreSQL 等独立数据库系统,其底层的连接、游标创建、SQL 传参与事务管理结构高度一致。本文首先基于 sqlite3 梳理完整的规范化操作流,随后横向对比主流生产数据库常用驱动的选型差异与适用边界。
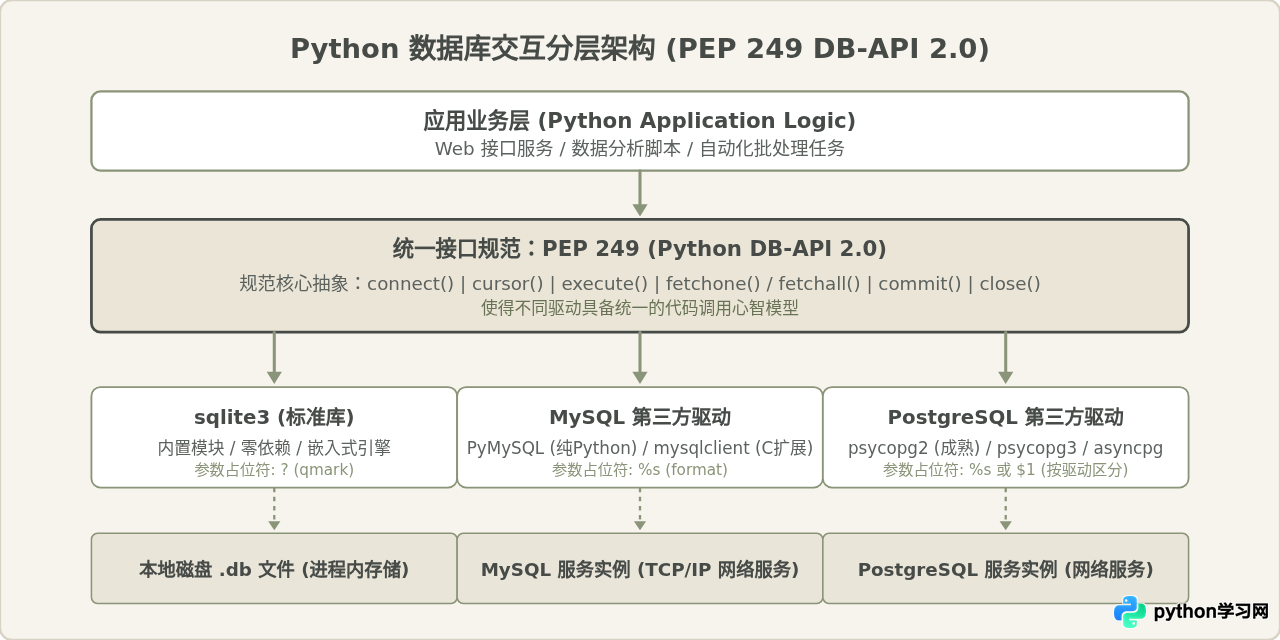
理解 Python DB-API 2.0 与 sqlite3 标准库
很多初学者在学习 Python 数据库编程时,常常误以为每换一种数据库,就要从头学习一套全新的编程接口。实际上,Python 社区早在 1999 年就确立了 PEP 249 规范,规定了数据库驱动模块必须实现的常量、连接对象(Connection)以及游标对象(Cursor)的核心行为。
Python 标准库自带的 sqlite3 正是这一规范的标准参考实现。SQLite 本身是一个自包含、无服务器、零配置的事务型 SQL 数据库引擎,其数据全部存储在单个普通磁盘文件中,或者直接保存在内存中。因此,掌握 sqlite3 的操作模式,不仅能直接满足本地工具、桌面软件以及中小型脚本的数据持久化需求,更为后续学习 MySQL、PostgreSQL 驱动打下了统一的方法论基础。
sqlite3 标准五步操作流与代码实现
符合 PEP 249 规范的数据库操作遵循清晰的五步时序流程:建立物理连接、派生工作游标、执行带参数的 SQL 语句、读取数据或提交事务变更,最后显式释放资源。
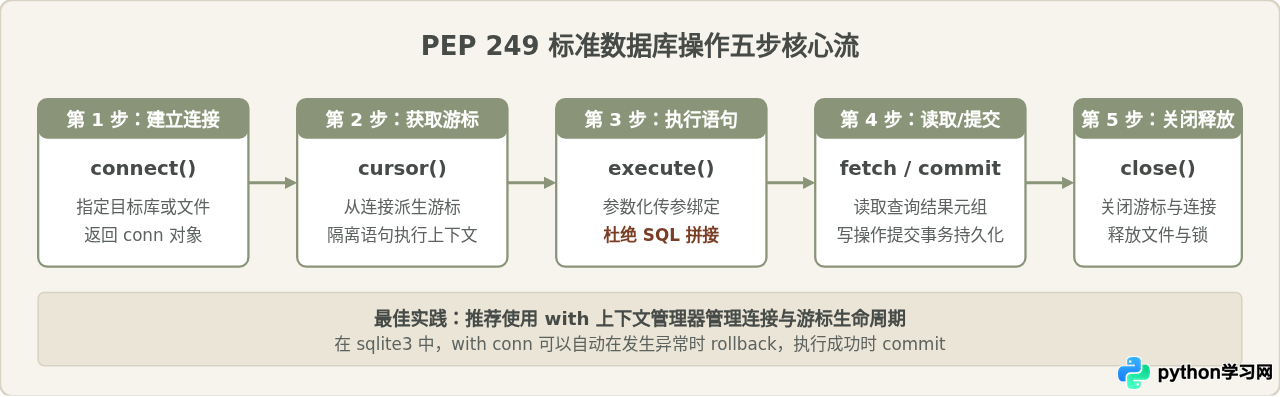
以下为使用 sqlite3 完成建表、安全写入、查询及异常处理的完整可运行示例代码:
import sqlite3

def init_and_query_database():
    # 步骤 1:建立连接(指定本地文件路径;若传 ":memory:" 则为内存数据库)
    conn = sqlite3.connect("app_data.db")

    # 将行结果配置为 sqlite3.Row,允许通过列名访问字段(类似字典)
    conn.row_factory = sqlite3.Row

    try:
        # 步骤 2:获取游标
        cursor = conn.cursor()

        # 步骤 3:执行 DDL 建表语句
        cursor.execute("""
            CREATE TABLE IF NOT EXISTS users (
                id INTEGER PRIMARY KEY AUTOINCREMENT,
                username TEXT NOT NULL UNIQUE,
                email TEXT NOT NULL,
                balance REAL DEFAULT 0.0
            );
        """)

        # 写入数据:严格使用参数化传参(? 占位符),绝不能用 f-string 拼接
        sample_users = [
            ("alice", "alice@example.com", 150.0),
            ("bob", "bob@example.com", 280.5)
        ]
        cursor.executemany("""
            INSERT OR IGNORE INTO users (username, email, balance)
            VALUES (?, ?, ?);
        """, sample_users)

        # 步骤 4:写操作必须显式 commit 提交事务
        conn.commit()

        # 查询数据:传入单个参数时需使用元组 (param,)
        min_balance = 100.0
        cursor.execute("SELECT id, username, email, balance FROM users WHERE balance >= ?", (min_balance,))

        rows = cursor.fetchall()
        print(f"--- 余额大于等于 {min_balance} 的用户列表 ---")
        for row in rows:
            print(f"ID: {row['id']} | 用户: {row['username']} | 余额: {row['balance']}")

    except sqlite3.Error as e:
        print(f"数据库执行发生异常: {e}")
        conn.rollback() # 出现错误时主动回滚
    finally:
        # 步骤 5:释放游标与连接资源
        cursor.close()
        conn.close()

if __name__ == "__main__":
    init_and_query_database()
在上述代码中,传递查询条件使用的是
(min_balance,) 与 SQL 内部的 ? 绑定。很多初学者习惯用 Python 的字符串拼接或 f"SELECT ... WHERE balance = {val}",这会直接把数据内容当做 SQL 语法解析,造成灾难性的 SQL 注入漏洞。在所有 DB-API 驱动中,务必把 SQL 模板与参数元组分开传给 execute(sql, params)。
常见认知偏差与辨析
在探讨数据库驱动选型时,社区中常常存在一些片面但广为流传的观点。厘清这些说法的成立条件与边界,有助于在实际架构设计中做出客观合理的判断。
辨析一:“SQLite 只是玩具级数据库,绝对不能用于生产环境”
观点来源与合理部分:这一观点的产生主要源于 SQLite 采用基于文件锁的并发模型。在默认的日志回滚(Rollback Journal)模式下,写事务会直接持有库级排他锁,此时其他连接无论是读还是写都会被阻塞;若并发写请求密集,容易出现 sqlite3.OperationalError: database is locked 错误。因此,对于电商订单系统、高频点赞流等每秒存在数百上千并发写操作的场景,SQLite 确实不适用。
修正与成立条件:“不能用于生产”是过度概括。事实上,SQLite 是全球部署量最大的数据库软件之一。当通过 PRAGMA journal_mode=WAL; 开启预写式日志(Write-Ahead Logging)模式后,SQLite 实现了读写互不阻塞(一个写操作与多个读操作可并发执行)。对于中小型企业内部系统、内容只读发布站、个人博客、边缘物联网网关、桌面客户端以及微服务的本地缓存,SQLite 运行极其稳定、内存开销极小且维护成本几乎为零,是极其优秀乃至首选的生产方案。
辨析二:“不同数据库的驱动各不相同,换数据库就必须重写所有交互代码”
观点来源与合理部分:不同数据库引擎的连接参数(如主机、端口、用户名密码 vs 文件路径)、内置函数、分页语法(LIMIT vs 游标分页)以及参数占位符风格(例如 SQLite 使用 ?,MySQL 使用 %s,PostgreSQL 部分驱动使用 $1)确实存在差异,直接把原有 SQL 语句不做任何检查地迁移往往会报错。
修正与成立条件:虽然 SQL 细节与连接初始化代码需要微调,但 Python 代码的控制骨架完全不需要推翻。因为 connect()、cursor()、execute()、fetchall() 以及 commit() 等方法的方法名、返回值类型和异常处理时机均受 PEP 249 约束。如果项目中遵循了良好的分层设计,把数据访问逻辑集中封装,迁移驱动的改造成本主要集中在连接配置项与方言参数上,而非程序逻辑本身。
主流数据库常用驱动横向对比
当业务体量增长或系统需要拆分为网络化分布式部署时,通常会引入 MySQL 或 PostgreSQL 作为中心化数据库。此时需要根据生产环境的技术栈选择适配的第三方驱动。
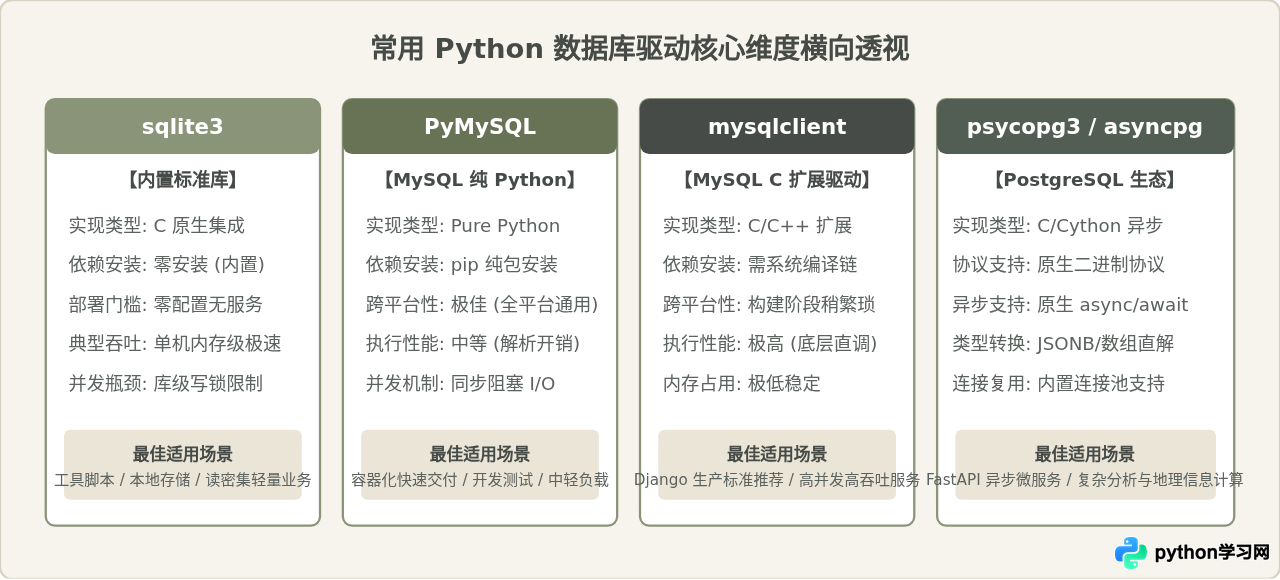
1. MySQL 生态驱动:PyMySQL 与 mysqlclient
MySQL 是互联网业务最常用的关系型数据库之一。Python 连接 MySQL 的两大主流驱动各有侧重:
- PyMySQL:完全使用纯 Python 代码编写,实现了 MySQL 客户端协议。其最大的优势在于免编译、零环境门槛。在任何平台上只需执行
pip install pymysql即可使用,绝不会出现 C 依赖缺失导致的编译报错。它的劣势在于当返回数十万条记录时,纯 Python 对象的内存分配与协议解析性能明显弱于 C 扩展。 - mysqlclient(前身为 MySQL-python / MySQLdb):底层基于官方 C 语言客户端库封装。由于在底层直接完成网络通信和类型转换,其吞吐性能和 CPU 利用率极佳,是 Django 官方文档明确首选推荐的 MySQL 驱动。缺点是在初次安装时,宿主机系统必须提供
default-libmysqlclient-dev或相关编译工具链。
2. PostgreSQL 生态驱动:psycopg2、psycopg3 与 asyncpg
PostgreSQL 以其强大的 JSONB 支撑、丰富的扩展插件和严谨的 ACID 闻名,Python 社区对它的驱动支持同样演进了多个阶段:
- psycopg2:长期以来的行业基石,由 C 语言精心优化打造,极其成熟稳健。然而由于其早期架构深度绑定同步阻塞模型,且历史包袱较重,官方已转向新一代重构。
- psycopg (psycopg3):新一代官方驱动,彻底支持 Python 3.8+ 现代类型提示与
async/await异步模型。它同时提供了预编译二进制包(pip install "psycopg[binary]"),兼顾了极速部署与高性能。 - asyncpg:专为
asyncio打造的高并发纯异步驱动。它不使用传统的 libpq 动态链接库,而是直接基于 Python asyncio 原生解析 PostgreSQL 二进制前端/后端协议,在大批量查询与高并发并发吞吐场景下,其吞吐指标甚至数倍于传统同步驱动。
| 驱动名称 | 目标数据库 | 底层实现 | PEP 249 符合度 | 异步 async/await | 主要安装依赖 |
|---|---|---|---|---|---|
| sqlite3 | SQLite | C (Python 内置) | 完全符合 | 否 (需 aiosqlite 包装) | 无 (标准库自带) |
| PyMySQL | MySQL / MariaDB | Pure Python | 完全符合 | 否 (需 aiomysql 包装) | 无编译依赖,极易安装 |
| mysqlclient | MySQL / MariaDB | C 扩展 (libmysqlclient) | 完全符合 | 否 | 需本地 C 编译器与 MySQL 开发库 |
| psycopg2 | PostgreSQL | C 扩展 (libpq) | 完全符合 | 有限支持异步轮询 | 提供 binary 轮子或需 libpq-dev |
| psycopg (v3) | PostgreSQL | C / Python 混编 | 完全符合 | 原生支持 | 支持预编译 binary,安装平滑 |
| asyncpg | PostgreSQL | Cython / 原生协议 | 不严格遵循 (专用异步 API) | 原生强支持 | 编译好的二进制 wheel |
生产环境选型决策指南
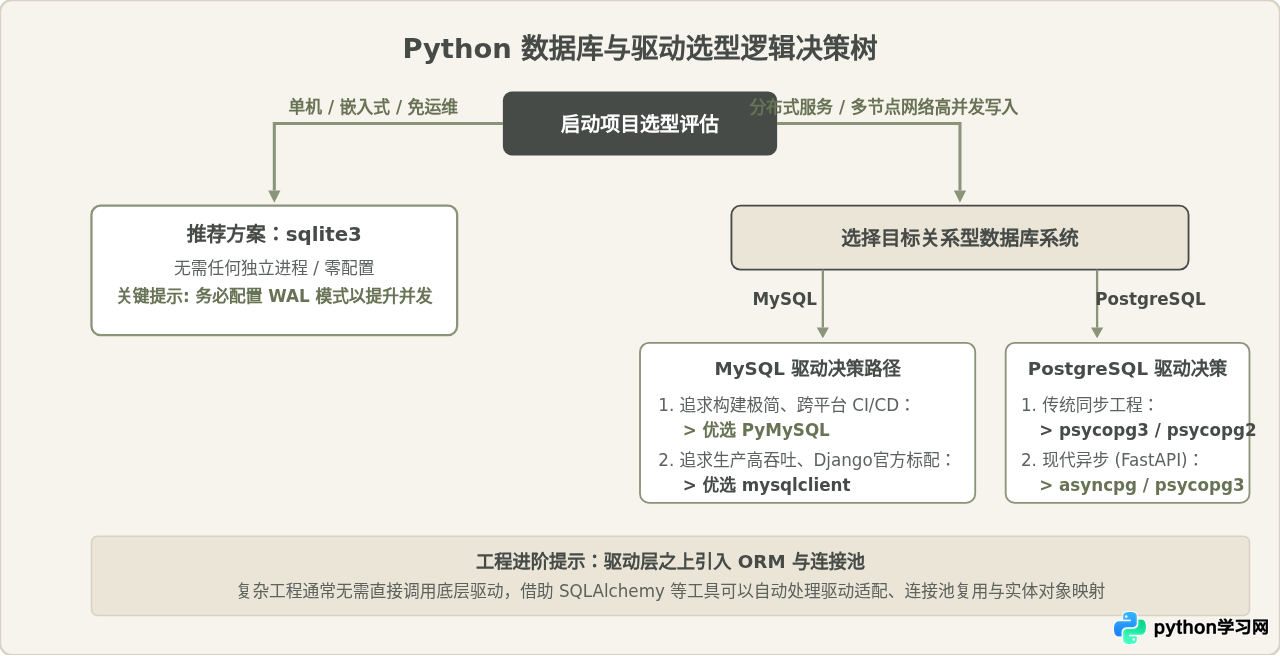
面对众多的驱动与数据库组合,开发者应当根据部署环境、并发规模以及应用框架形态来制定清晰的选型路径:
总结与实战建议
回顾 Python 操作数据库的技术路径,核心结论可以归纳为以下三点:
- 重视 PEP 249 的基石作用:掌握
sqlite3的connect、cursor、参数化execute、commit与资源释放闭环,就能掌握所有符合规范驱动的 80% 核心操作逻辑。 - 永远杜绝 SQL 拼接:无论是使用
sqlite3的?还是 MySQL 驱动的%s,绝不可使用字符串格式化合成 SQL,必须借助参数占位符由底层引擎安全转义。 - 按需升级生产架构:本地轻量开发与小型系统优先利用
sqlite3(记得开启 WAL 模式);当业务演进至多节点高并发分布式阶段,MySQL 首选mysqlclient或PyMySQL,PostgreSQL 首选psycopg3或asyncpg。在更大型工程中,推荐在底层驱动之上结合 SQLAlchemy 或 Django ORM,以获得更健壮的连接池管理与模型抽象能力。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









