

降低AI智能体开发成本:Token消耗监控与模型调用优化策略

看着月底的API账单,很多开发者心里都咯噔一下:明明只是做个内部用的助手,怎么Token消耗跑得比预想快这么多?尤其是当智能体开始处理长文档或进行多轮复杂推理时,那种“每说一句话都在烧钱”的感觉尤为强烈。
其实,降本不需要重写整个架构,最立竿见影的动作往往藏在细节里。第一步不是急着换便宜模型,而是先看清钱到底花哪儿了。如果没有准确的监控数据,任何优化都像在盲猜。
建立可视化的Token消耗看板
很多团队只关注总费用,却忽略了单次调用的明细。你需要在代码层埋点,记录每次请求的输入Token(Prompt)、输出Token(Completion)以及所调用的模型名称。
不要只看总数,要按功能模块拆分。比如,将“用户意图识别”、“知识库检索”和“最终回答生成”分开统计。通常你会发现,某些看似不起眼的预处理步骤,因为频繁调用大模型,反而成了成本大头。
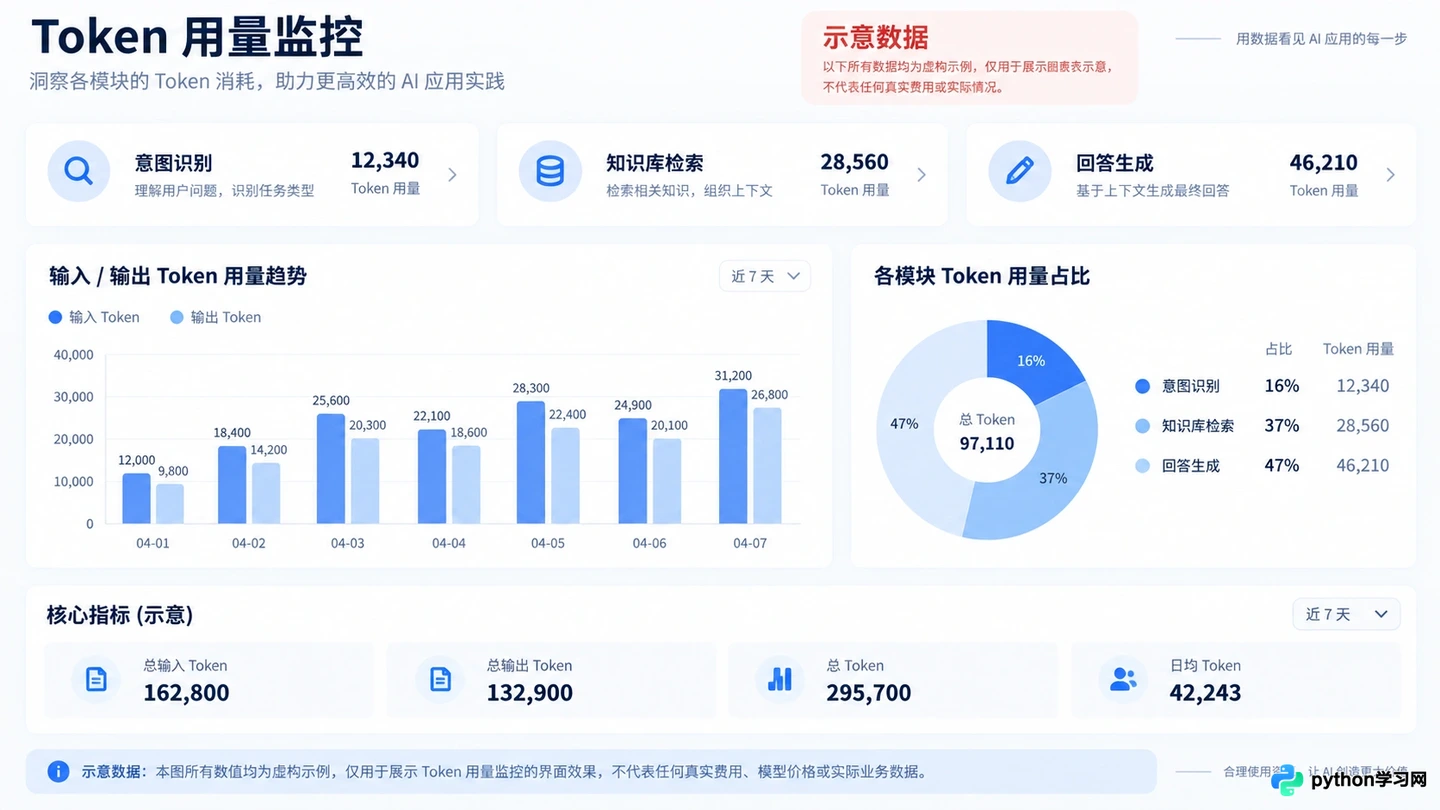
细粒度的Token消耗监控面板,展示不同模块的费用占比
一旦有了细分数据,你就能发现异常。例如,某个搜索接口每次返回都带着几万字的相关片段,直接塞进Prompt,这不仅浪费Token,还会拖慢响应速度。这时候,优化方向就清晰了:要么截断文本,要么改用更高效的摘要方式。
让相同的提问不再重复计费
在智能体交互中,大量问题是重复或高度相似的。如果每次用户问“今天天气如何”,你都去调一次大模型,那就是纯粹的浪费。
引入语义缓存是性价比极高的手段。对于完全相同的查询,直接使用标准Key-Value缓存;对于语义相似的问题,可以使用向量数据库存储历史问答对。当新请求进来时,先计算相似度,如果超过阈值(如0.9),直接返回缓存结果。
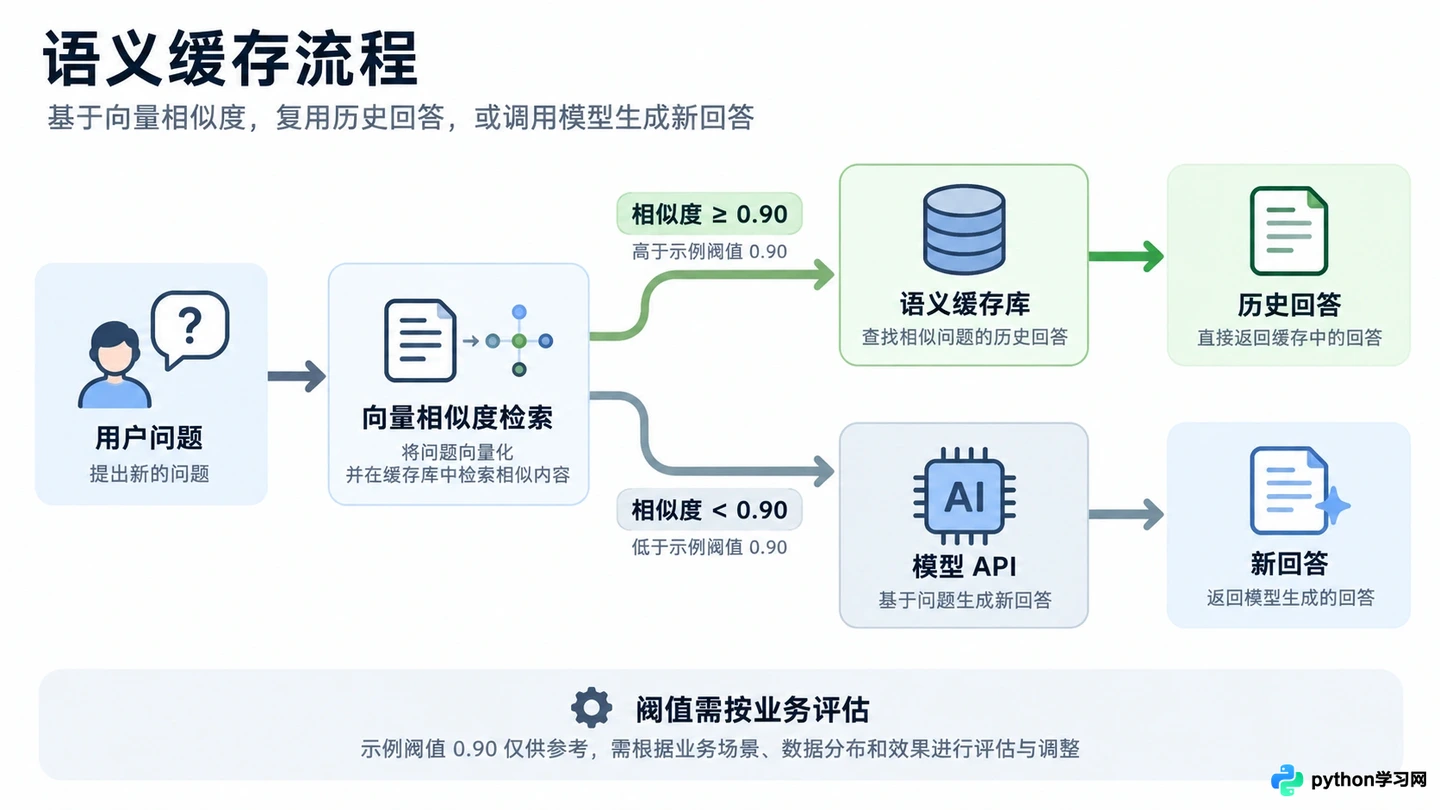
语义缓存机制:通过向量相似度匹配直接返回历史答案
注意设置合理的过期时间(TTL)。对于时效性强的内容,如新闻或股价,缓存时间要短;而对于公司制度、通用常识,可以长期缓存。这一步往往能拦截掉30%以上的无效请求,且几乎零延迟。
精简Prompt,拒绝“废话文学”
大模型是按Token计费的,Prompt里的每一个字都是钱。很多开发者喜欢把整个系统提示词写得长篇大论,甚至包含大量示例和背景信息,这在开发阶段没问题,但在生产环境就是负担。
检查你的System Prompt,删除所有不影响核心逻辑的修饰性词语。将复杂的指令拆解,只在需要时才动态插入上下文。例如,不要每次都把用户的历史聊天记录全量传入,而是只保留最近N轮对话,或者对早期对话进行摘要压缩。
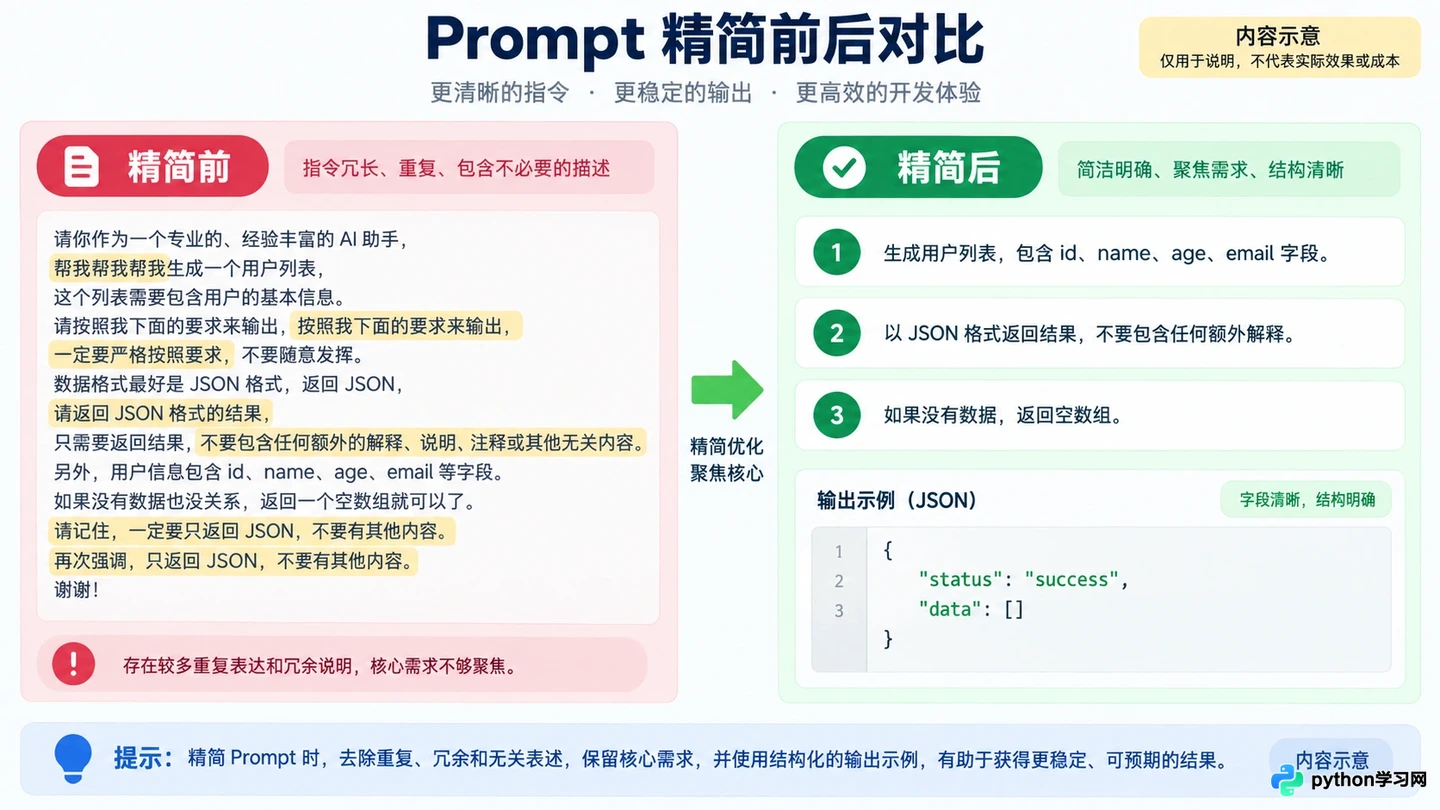
优化后的Prompt结构更紧凑,减少冗余上下文
另外,尽量使用结构化输出(如JSON模式)。这不仅方便后端解析,还能引导模型少说废话,直接给出关键数据,从而减少输出Token的数量。相比让模型写一段自然语言解释,让它直接返回 {"status": "success", "data": [...]} 要省钱得多。
采用分级模型路由策略
不是所有任务都需要GPT-4级别的智力。用大炮打蚊子,既贵又慢。建立一个简单的路由层,根据任务难度分配模型。
对于分类、提取实体、简单问答等确定性高的任务,使用轻量级模型(如Qwen-Turbo、Gemini Flash或本地部署的小参数模型)。这些模型速度快、成本低,足以胜任80%的基础工作。只有当遇到复杂推理、创意写作或代码生成时,才路由到高性能的大模型。
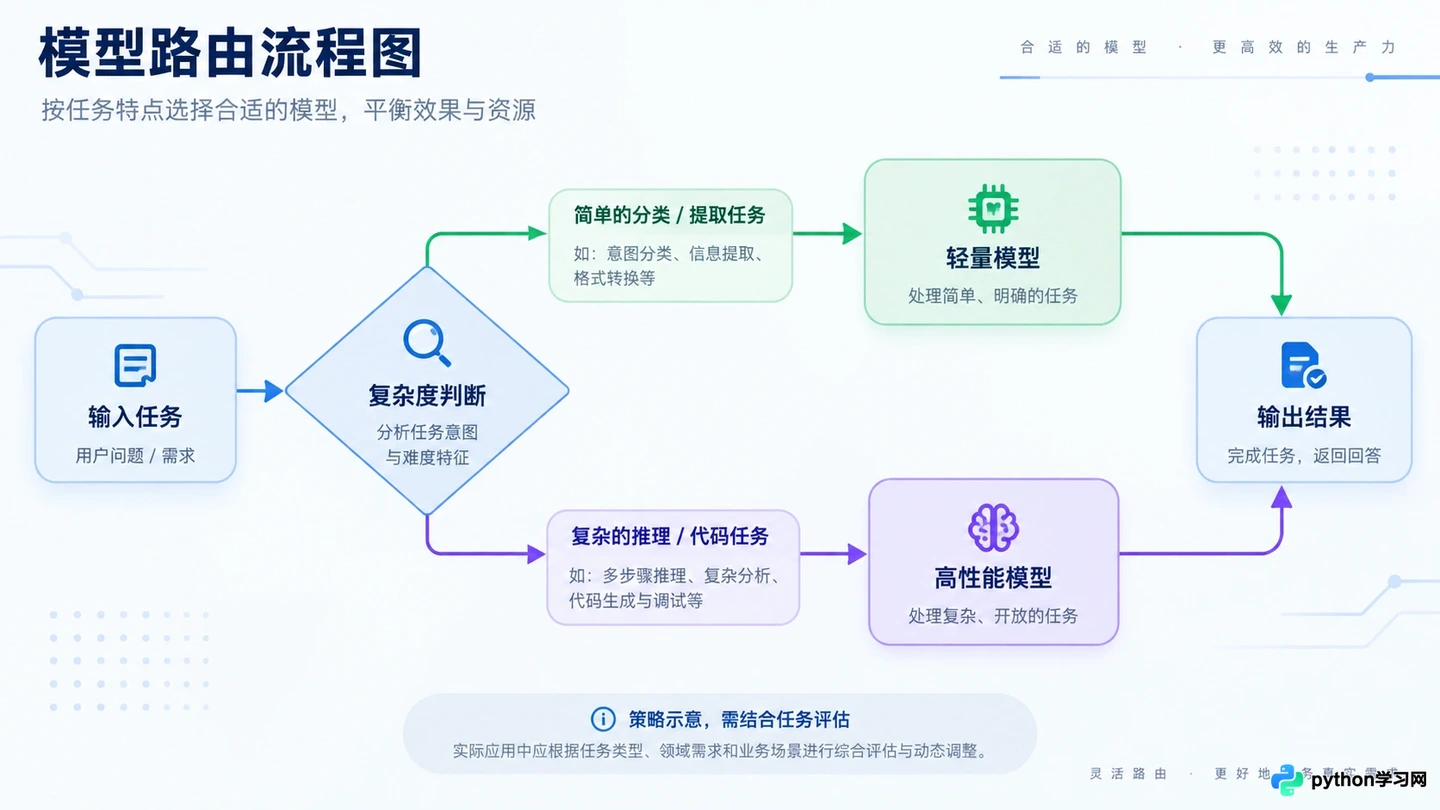
根据任务复杂度自动分配轻量级或高性能模型
这种混合架构的关键在于准确判断任务复杂度。你可以先用小模型尝试解决,如果置信度低或检测到特定关键词(如“分析”、“创作”),再转发给大模型。虽然增加了一次判断开销,但整体成本通常会下降50%以上。
优化不是一蹴而就的,而是一个持续监控和调整的过程。先从埋点监控做起,找到最耗钱的环节,再针对性地应用缓存、精简Prompt或调整模型路由。当你能清晰看到每一分钱花在哪里时,降本自然就水到渠成了。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









