

Python重构微信公众号开发:从PHP迁移的核心代码与避坑指南

本文详细记录了将微信公众号后端从PHP迁移至Python的完整过程。重点解析了基于Flask框架的api.py、dispatcher.py及robot.py核心代码,涵盖Token校验、XML消息解析及多类型消息分发机制。同时总结了Token验证、CDATA格式规范及服务稳定性保障(如uwsgi部署)等关键易错点,为开发者提供实用的重构参考。
大学期间曾短暂尝试过微信公众号开发,当时觉得颇具趣味。
https://www.jb51.net/article/133677.htm此前因服务器到期项目被迫搁置。鉴于当时发布Web程序时PHP使用较为熟练,故最初选用PHP作为开发语言。实际上,微信公众号开发的底层流程与原理与具体编程语言关联不大,核心逻辑是通用的。
临近毕业设计阶段,考虑到未来需要将代码部署至服务器以构建长期运行的系统,遂利用学生身份购置了阿里云学生机。获得服务器后,决定重启微信公众号开发项目。此次不再使用PHP,因为相较于Python,PHP在灵活性上略显局限。
选择Python的原因在于其能灵活部署爬虫程序,且与用户交互更为便捷,系统拓展性也更高。
服务器配置属于基础环节,若有疑问可参考之前的博客文章,内容较为详尽。此处仅对核心代码部分进行介绍。
项目目录结构
root@aliyun:/var/www/html/wx/py# ls *.py
api.py dispatcher.py robot.py
root@aliyun:/var/www/html/wx/py#
api.py文件
该文件充当入口关卡,主要负责Token验证及服务支持功能。
# -*- coding:utf-8 -*-    #中文编码
import sys
reload(sys) # 不加这部分处理中文还是会出问题
sys.setdefaultencoding('utf-8')
import time
from flask import Flask, request, make_response
import hashlib
import json
import xml.etree.ElementTree as ET
from dispatcher import *
app = Flask(__name__)
app.debug = True
@app.route('/') # 默认网址
def index():
 return 'Index Page'
@app.route('/wx', methods=['GET', 'POST'])
def wechat_auth(): # 处理微信请求的处理函数,get方法用于认证,post方法取得微信转发的数据
 if request.method == 'GET':
 token = '你自己设置好的token'
 data = request.args
 signature = data.get('signature', '')
 timestamp = data.get('timestamp', '')
 nonce = data.get('nonce', '')
 echostr = data.get('echostr', '')
 s = [timestamp, nonce, token]
 s.sort()
 s = ''.join(s)
 if (hashlib.sha1(s).hexdigest() == signature):
  return make_response(echostr)
 else:
 rec = request.stream.read() # 接收消息
 dispatcher = MsgDispatcher(rec)
 data = dispatcher.dispatch()
 with open("./debug.log", "a") as file:
  file.write(data)
  file.close()
 response = make_response(data)
 response.content_type = 'application/xml'
 return response
if __name__ == '__main__':
 app.run(host="0.0.0.0", port=80)
dispatcher.py文件
此文件为服务核心,用于识别用户发送的消息类型,并将其分发至相应的Handler进行处理,最终将运行结果反馈至前端并发送给用户。关于消息类型的详细定义,微信官方开发文档已有说明,此处不再赘述。
#! /usr/bin python
# coding: utf8
import sys
reload(sys)
sys.setdefaultencoding("utf8")
import time
import json
import xml.etree.ElementTree as ET
from robot import *
class MsgParser(object):
 """
 用于解析从微信公众平台传递过来的参数,并进行解析
 """
 def __init__(self, data):
 self.data = data
 def parse(self):
 self.et = ET.fromstring(self.data)
 self.user = self.et.find("FromUserName").text
 self.master = self.et.find("ToUserName").text
 self.msgtype = self.et.find("MsgType").text
 # 纯文字信息字段
 self.content = self.et.find("Content").text if self.et.find("Content") is not None else ""
 # 语音信息字段
 self.recognition = self.et.find("Recognition").text if self.et.find("Recognition") is not None else ""
 self.format = self.et.find("Format").text if self.et.find("Format") is not None else ""
 self.msgid = self.et.find("MsgId").text if self.et.find("MsgId") is not None else ""
 # 图片
 self.picurl = self.et.find("PicUrl").text if self.et.find("PicUrl") is not None else ""
 self.mediaid = self.et.find("MediaId").text if self.et.find("MediaId") is not None else ""
 # 事件
 self.event = self.et.find("Event").text if self.et.find("Event") is not None else ""
 return self
class MsgDispatcher(object):
 """
 根据消息的类型,获取不同的处理返回值
 """
 def __init__(self, data):
 parser = MsgParser(data).parse()
 self.msg = parser
 self.handler = MsgHandler(parser)
 def dispatch(self):
 self.result = "" # 统一的公众号出口数据
 if self.msg.msgtype == "text":
  self.result = self.handler.textHandle()
 elif self.msg.msgtype == "voice":
  self.result = self.handler.voiceHandle()
 elif self.msg.msgtype == 'image':
  self.result = self.handler.imageHandle()
 elif self.msg.msgtype == 'video':
  self.result = self.handler.videoHandle()
 elif self.msg.msgtype == 'shortvideo':
  self.result = self.handler.shortVideoHandle()
 elif self.msg.msgtype == 'location':
  self.result = self.handler.locationHandle()
 elif self.msg.msgtype == 'link':
  self.result = self.handler.linkHandle()
 elif self.msg.msgtype == 'event':
  self.result = self.handler.eventHandle()
 return self.result
class MsgHandler(object):
 """
 针对type不同,转交给不同的处理函数。直接处理即可
 """
 def __init__(self, msg):
 self.msg = msg
 self.time = int(time.time())
 def textHandle(self, user='', master='', time='', content=''):
 template = """
 <xml>
  <ToUserName><![CDATA[{}]]></ToUserName>
  <FromUserName><![CDATA[{}]]></FromUserName>
  <CreateTime>{}</CreateTime>
  <MsgType><![CDATA[text]]></MsgType>
  <Content><![CDATA[{}]]></Content>
  </xml>
 """
 # 对用户发过来的数据进行解析,并执行不同的路径
 try:
  response = get_response_by_keyword(self.msg.content)
  if response['type'] == "image":
  result = self.imageHandle(self.msg.user, self.msg.master, self.time, response['content'])
  elif response['type'] == "music":
  data = response['content']
  result = self.musicHandle(data['title'], data['description'], data['url'], data['hqurl'])
  elif response['type'] == "news":
  items = response['content']
  result = self.newsHandle(items)
  # 这里还可以添加更多的拓展内容
  else:
  response = get_turing_response(self.msg.content)
  result = template.format(self.msg.user, self.msg.master, self.time, response)
  #with open("./debug.log", 'a') as f:
  # f.write(response['content'] + '~~' + result)
  # f.close()
 except Exception as e:
  with open("./debug.log", 'a') as f:
  f.write("text handler:"+str(e.message))
  f.close()
 return result
 def musicHandle(self, title='', description='', url='', hqurl=''):
 template = """
 <xml>
  <ToUserName><![CDATA[{}]]></ToUserName>
  <FromUserName><![CDATA[{}]]></FromUserName>
  <CreateTime>{}</CreateTime>
  <MsgType><![CDATA[music]]></MsgType>
  <Music>
  <Title><![CDATA[{}]]></Title>
  <Description><![CDATA[{}]]></Description>
  <MusicUrl><![CDATA[{}]]></MusicUrl>
  <HQMusicUrl><![CDATA[{}]]></HQMusicUrl>
  </Music>
  <FuncFlag>0</FuncFlag>
 </xml>
 """
 response = template.format(self.msg.user, self.msg.master, self.time, title, description, url, hqurl)
 return response
 def voiceHandle(self):
 response = get_turing_response(self.msg.recognition)
 result = self.textHandle(self.msg.user, self.msg.master, self.time, response)
 return result
 def imageHandle(self, user='', master='', time='', mediaid=''):
 template = """
 <xml>
  <ToUserName><![CDATA[{}]]></ToUserName>
  <FromUserName><![CDATA[{}]]></FromUserName>
  <CreateTime>{}</CreateTime>
  <MsgType><![CDATA[image]]></MsgType>
  <Image>
  <MediaId><![CDATA[{}]]></MediaId>
  </Image>
  </xml>
 """
 if mediaid == '':
  response = self.msg.mediaid
 else:
  response = mediaid
 result = template.format(self.msg.user, self.msg.master, self.time, response)
 return result
 def videoHandle(self):
 return 'video'
 def shortVideoHandle(self):
 return 'shortvideo'
 def locationHandle(self):
 return 'location'
 def linkHandle(self):
 return 'link'
 def eventHandle(self):
 return 'event'
 def newsHandle(self, items):
 # 图文消息这块真的好多坑,尤其是<![CDATA[]]>中间不可以有空格,可怕极了
 articlestr = """
 <item>
  <Title><![CDATA[{}]]></Title>
  <Description><![CDATA[{}]]></Description>
  <PicUrl><![CDATA[{}]]></PicUrl>
  <Url><![CDATA[{}]]></Url>
 </item>
 """
 itemstr = ""
 for item in items:
  itemstr += str(articlestr.format(item['title'], item['description'], item['picurl'], item['url']))
 template = """
 <xml>
  <ToUserName><![CDATA[{}]]></ToUserName>
  <FromUserName><![CDATA[{}]]></FromUserName>
  <CreateTime>{}</CreateTime>
  <MsgType><![CDATA[news]]></MsgType>
  <ArticleCount>{}</ArticleCount>
  <Articles>{}</Articles>
 </xml>
 """
 result = template.format(self.msg.user, self.msg.master, self.time, len(items), itemstr)
 return result
robot.py文件
该文件起到了画龙点睛的作用。
#!/usr/bin python
#coding: utf8
import requests
import json
def get_turing_response(req=""):
 url = "http://www.tuling123.com/openapi/api"
 secretcode = "嘿嘿,这个就不说啦"
 response = requests.post(url=url, json={"key": secretcode, "info": req, "userid": 12345678})
 return json.loads(response.text)['text'] if response.status_code == 200 else ""
def get_qingyunke_response(req=""):
 url = "http://api.qingyunke.com/api.php?key=free&appid=0&msg={}".format(req)
 response = requests.get(url=url)
 return json.loads(response.text)['content'] if response.status_code == 200 else ""
# 简单做下。后面慢慢来
def get_response_by_keyword(keyword):
 if '团建' in keyword:
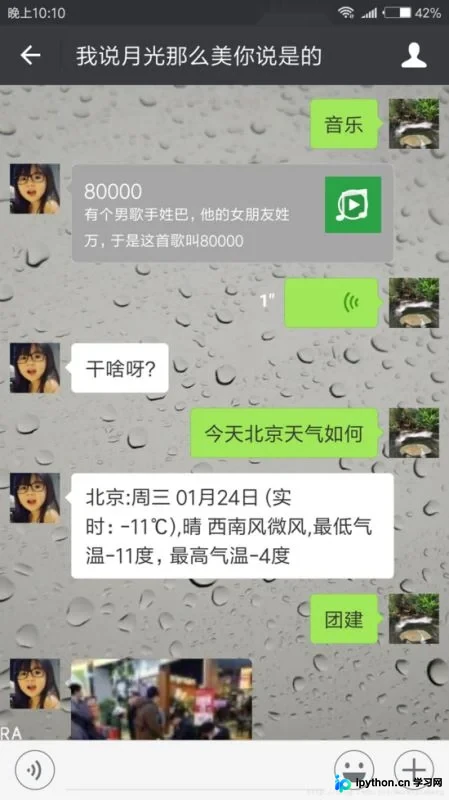
 result = {"type": "image", "content": "3s9Dh5rYdP9QruoJ_M6tIYDnxLLdsQNCMxkY0L2FMi6HhMlNPlkA1-50xaE_imL7"}
 elif 'music' in keyword or '音乐' in keyword:
 musicurl='http://204.11.1.34:9999/dl.stream.qqmusic.qq.com/C400001oO7TM2DE1OE.m4a?vkey=3DFC73D67AF14C36FD1128A7ABB7247D421A482EBEDA17DE43FF0F68420032B5A2D6818E364CB0BD4EAAD44E3E6DA00F5632859BEB687344&guid=5024663952&uin=1064319632&fromtag=66'
 result = {"type": "music", "content": {"title": "80000", "description":"有个男歌手姓巴,他的女朋友姓万,于是这首歌叫80000", "url": musicurl, "hqurl": musicurl}}
 elif '关于' in keyword:
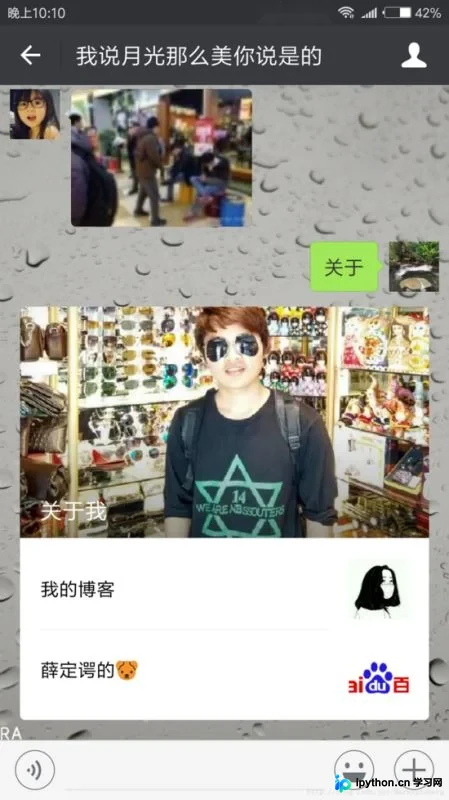
 items = [{"title": "关于我", "description":"喜欢瞎搞一些脚本", "picurl":"https://avatars1.githubusercontent.com/u/12973402?s=460&v=4", "url":"https://github.com/guoruibiao"},
   {"title": "我的博客", "description":"收集到的,瞎写的一些博客", "picurl":"http://avatar.csdn.net/0/8/F/1_marksinoberg.jpg", "url":"http://blog.csdn.net/marksinoberg"},
   {"title": "薛定谔的:dog:", "description": "副标题有点奇怪,不知道要怎么设置比较好","picurl": "https://www.baidu.com/img/bd_logo1.png","url": "http://www.baidu.com"}
   ]
 result = {"type": "news", "content": items}
 else:
 result = {"type": "text", "content": "可以自由进行拓展"}
 return result
看似单一文件,实则具备极大的拓展空间。
若需通过公众号监控服务器运行状态,可添加服务器负载监控脚本;
若希望执行爬虫任务,每日抓取高质量文章并通过公众号展示;
在不便使用电脑时,通过公众号调用特定命令也可视为一种曲线救国的方案;
等等。只要有想法,即可利用Python进行实现,并通过公众号平台进行展示。
常见易错点
在从PHP重构为Python的过程中,遇到了一些问题。以下总结旨在帮助遇到相同困扰的读者,若此文能带来帮助,则写作便有了意义。
微信公众号开发的关键在于理解其工作模式,大致包含两条路径。
用户将消息发送至微信公众平台,平台将信息拼接组装为XML格式发送至我们的服务器(经过一系列认证与校验,确保服务合法性),随后服务器对XML进行解析与处理。
服务器完成解析处理后,将数据再次拼接组装为XML格式发回微信公众平台,平台协助将数据反馈给对应用户。如此,一次交互即告完成。在此过程中,存在以下几个易错环节。
Token校验:Token校验采用GET方式请求。通过代码可见,主要涉及对signature的校验,具体逻辑可参考代码实现。
XML数据解析:针对不同消息类型,需使用不同的格式。其中格式不规范极易出错,<!CDATA[[]]>中括号内部最好避免包含空格,否则错误定位将十分困难。
服务稳定性:此处使用的Web框架为Flask,小巧精致,但对并发支持能力有限。为此,可结合uwsgi与Nginx以实现更稳定的服务。若仅用于个人测试,通过命令行启动(如python api.py)并不保险,因为用户异常输入可能导致服务崩溃。建议使用nohup方式,以在一定程度上保障服务质量。
结果演示
目前该公众号支持文字、语音、图片、图文等多种消息类型。示例如下。
总结
在将公众号从PHP重构为Python的过程中,遇到诸多问题,通过不断摸索逐步解决。事实上,只有不断发现问题,才能持续提升自我。
此处并未深入完善,重构后的微信公众号功能潜力巨大,关键在于想象力。暂且讨论至此,后续若有新思路或实现,再行更新。
以上所述是小编给大家介绍的Python微信公众号开发平台,希望对大家有所帮助,如果大家有任何疑问请给我留言,小编会及时回复大家的。在此也非常感谢大家对本站网站的支持!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









