

4个提升Python执行效率的实用技巧

本文分享了4个Python高效省时的技巧,包括使用reverse()反转列表、一行代码交换变量值、在函数内部循环以及减少函数调用次数。这些方法能显著降低执行时间,提升代码简洁性与运行效率。
今天分享4个Python中高效省时的技巧,这些方法可以帮助节省10%到20%的执行时间。
反转列表
在Python中,通常有两种方法可以反转列表:使用切片操作或调用reverse()内置函数。这两种方式都能实现列表反转,但关键区别在于:reverse()会直接修改原始列表,而切片操作会生成并返回一个新列表。
那么,哪种方式在性能上更优?让我们通过具体的性能测试来对比一下。
使用切片方式:
$ python -m timeit -n 1000000 -s 'import numpy as np' 'mylist=list(np.arange(0, 200))' 'mylist[::-1]'
1000000 loops, best of 5: 15.6 usec per loop
使用reverse()函数:
$ python -m timeit -n 1000000 -s 'import numpy as np' 'mylist=list(np.arange(0, 200))' 'mylist.reverse()'
1000000 loops, best of 5: 10.7 usec per loop
虽然两种方法都能完成列表反转,但需注意reverse()会改变原列表,而切片会创建新列表。
从测试结果来看,内置的reverse()函数比列表切片方法执行速度更快。
交换两个值
使用一行代码交换两个变量的值是更具Python风格的做法。
与其他编程语言不同,Python不需要借助临时变量来交换两个数字或值。一个简单的示例如下:
variable_1 = 100
variable_2 = 500
只需一行代码即可完成variable_1和variable_2的值交换。
variable_1, variable_2 = variable_2, variable_1
同样的技巧也适用于字典操作:
md[key_2], md[key_1] = md[key_1], md[key_2]
这种方法避免了多次迭代和复杂的数据转换,从而有效减少了执行时间。
在函数内部循环
我们常通过创建自定义函数来执行特定任务,然后利用for循环多次调用该函数以重复执行任务。
然而,在for循环外部调用函数会导致每次迭代都产生一次函数调用开销,从而增加执行时间。
相反,如果将for循环逻辑封装在函数内部,则该函数仅被调用一次,从而减少了调用开销。
为了更清晰地说明这一点,请看下面的例子。
首先,我们创建一个简单的字符串列表:
list_of_strings = ['apple','orange','banana','pineapple','grape']
接着创建两个函数,一个在外部循环调用,另一个在内部包含循环,从简单的开始。
def only_function(x):
    new_string = x.capitalize()
    out_putstring = x + " " + new_string
    print(output_string)
以及一个包含循环的函数:
def for_in_function(listofstrings):
    for x in list_of_strings:
        new_string = x.capitalize()
        output_string = x + " " + new_string
        print(output_string)
显然,这两个函数的输出结果是相同的。
接下来,让我们比较一下哪个执行速度更快。
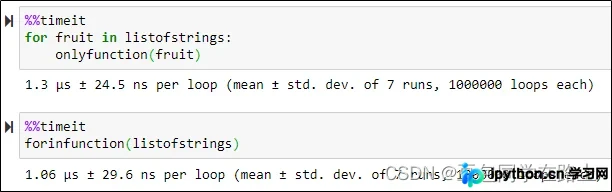
从结果可以看出,在函数内部使用for循环的执行速度稍快一些。
减少函数调用次数
在判断对象类型时,推荐使用isinstance(),其次是使用对象类型标识is,而使用type()函数效率最低。
# Check if num an int type
type(num) == type(0) # Three function calls
type(num) is type(0) # Two function calls
isinstance(num,(int)) # One function call
避免将重复操作的内容作为参数放在循环条件中,以防止重复计算。
# Each loop the len(a) will be called
while i < len(a):
    statement
# Only execute len(a) once
m = len(a)
while i < m:
    statement
若要在模块X中使用函数或对象Y,建议直接使用from X import Y,而不是先import X再使用X.Y。这样可以减少一次查找过程(解释器无需先查找X模块,再在X的字典中查找Y)。
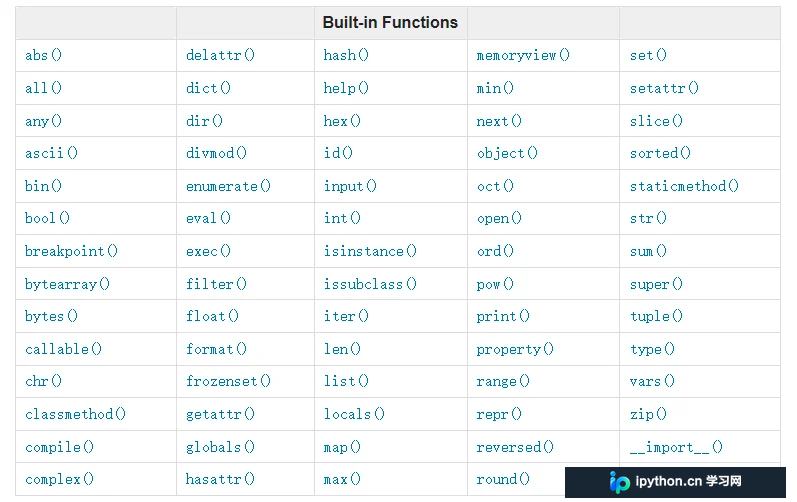
总之,可以大量使用Python的内置函数。这既能提高Python程序的速度,又能保持代码简洁易懂。
如果想进一步了解Python的内置函数,可以参考下表,或访问以下官方文档(https://docs.python.org/3/library/functions.html):
总结
以上就是关于4个Python高效省时技巧的介绍,更多相关Python高效技巧内容请搜索本站以前的文章或继续浏览下面的相关文章,希望大家以后多多支持本站!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









