

Python Keras实现GRU网络结构及参数量详解

本文详细介绍GRU(门控循环单元)的网络结构与工作原理,解析其更新门与重置门的机制,并推导GRU的参数量计算公式。通过Python Keras框架展示GRU的具体实现代码,包括单元数、输入形状等关键参数的配置方法,帮助开发者快速掌握GRU模型的构建与训练流程。
什么是GRU
GRU全称为门控循环单元(Gated Recurrent Unit),它是长短期记忆网络(LSTM)的一种改进变体。
GRU保留了LSTM中的门控机制,但将原有的三个门(输入门、遗忘门、输出门)简化为两个门:更新门(Update Gate)和重置门(Reset Gate)。
1、GRU单元的输入与输出
下图展示了单个GRU单元的内部结构。
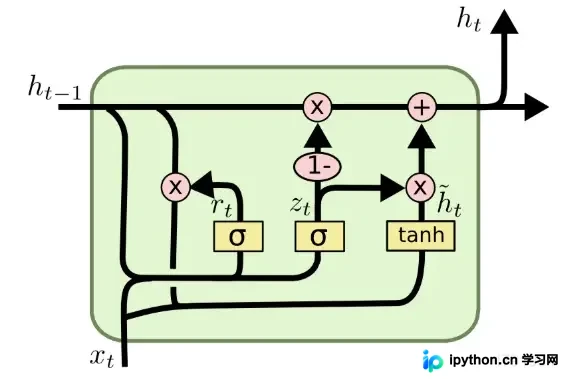
在时间步n时,每个GRU单元接收两个输入信号:
- 当前时刻的网络输入值Xt;
- 上一时刻GRU的输出值ht-1;
其输出为:
当前时刻GRU的输出值ht;
2、GRU的门结构
GRU包含两个核心门控结构,分别为:
更新门zt和重置门rt:
更新门用于调节前一时刻状态信息在当前状态中的保留程度。更新门的值越大,表示前一时刻的状态信息带入越少,而当前时刻的新状态信息带入越多。
重置门用于控制忽略前一时刻状态信息的程度。重置门的值越小,说明对前一时刻状态信息的忽略程度越高。
3、GRU的参数量计算
a、更新门
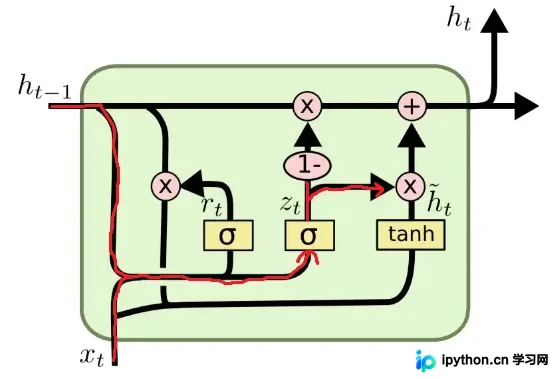
更新门在图中标记为zt,其计算需结合ht-1和Xt,以决定上一时刻输出ht-1中有多少信息被保留。更新门的值越大,意味着前一时刻的状态信息保留越少,当前时刻的状态信息保留越多。
根据相关公式可知:
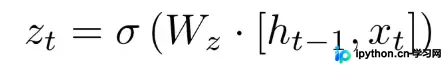
zt由ht-1和Xt共同决定。
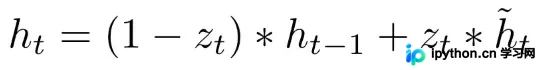
当更新门zt的值较大时,上一时刻的输出ht-1保留较少,而当前时刻的状态信息保留较多。
b、重置门
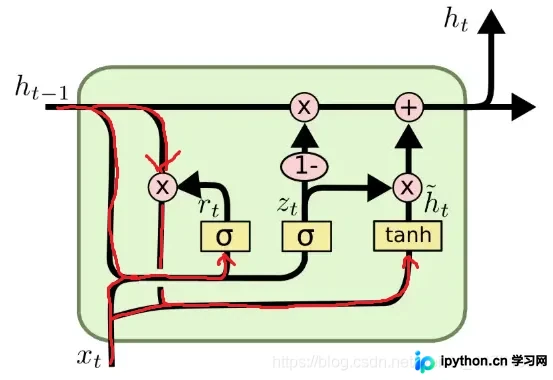
重置门在图中标记为rt,需结合ht-1和Xt来控制对前一时刻状态信息的忽略程度,重置门的值越小说明忽略得越多。
根据相关公式可知:
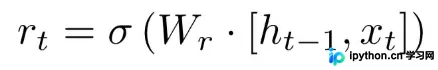
rt由ht-1和Xt共同决定。
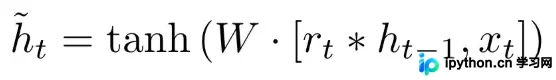
当重置门rt的值较小时,上一时刻的输出ht-1保留较少,表明忽略得越多。
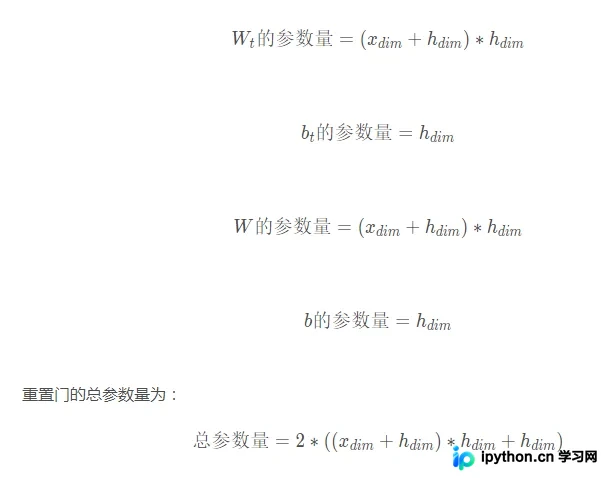
c、全部参数量
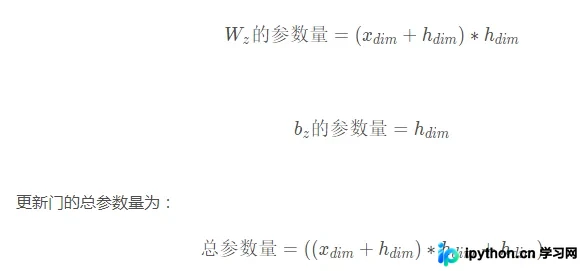
因此,所有门控结构的总参数量为:
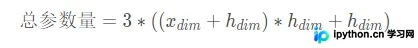
在Keras中实现GRU
GRU层通常需要输入两个主要参数。
一个是unit,另一个是input_shape。
LSTM(CELL_SIZE, input_shape = (TIME_STEPS,INPUT_SIZE))unit参数用于指定神经元的数量。
input_shape参数用于指定输入数据的形状,需分别指定TIME_STEPS(时间步长)和INPUT_SIZE(输入维度)。
实现代码
import numpy as np
from keras.models import Sequential
from keras.layers import Input,Activation,Dense
from keras.models import Model
from keras.datasets import mnist
from keras.layers.recurrent import GRU
from keras.utils import np_utils
from keras.optimizers import Adam
TIME_STEPS = 28
INPUT_SIZE = 28
BATCH_SIZE = 50
index_start = 0
OUTPUT_SIZE = 10
CELL_SIZE = 75
LR = 1e-3
(X_train,Y_train),(X_test,Y_test) = mnist.load_data()
X_train = X_train.reshape(-1,28,28)/255
X_test = X_test.reshape(-1,28,28)/255
Y_train = np_utils.to_categorical(Y_train,num_classes= 10)
Y_test = np_utils.to_categorical(Y_test,num_classes= 10)
inputs = Input(shape=[TIME_STEPS,INPUT_SIZE])
x = GRU(CELL_SIZE, input_shape = (TIME_STEPS,INPUT_SIZE))(inputs)
x = Dense(OUTPUT_SIZE)(x)
x = Activation("softmax")(x)
model = Model(inputs,x)
adam = Adam(LR)
model.summary()
model.compile(loss = 'categorical_crossentropy',optimizer = adam,metrics = ['accuracy'])
for i in range(50000):
    X_batch = X_train[index_start:index_start + BATCH_SIZE,:,:]
    Y_batch = Y_train[index_start:index_start + BATCH_SIZE,:]
    index_start += BATCH_SIZE
    cost = model.train_on_batch(X_batch,Y_batch)
    if index_start >= X_train.shape[0]:
        index_start = 0
    if i%100 == 0:
        cost,accuracy = model.evaluate(X_test,Y_test,batch_size=50)
        print("accuracy:",accuracy)
实现效果:
10000/10000 [==============================] - 2s 231us/step
accuracy: 0.16749999986961484
10000/10000 [==============================] - 2s 206us/step
accuracy: 0.6134000015258789
10000/10000 [==============================] - 2s 214us/step
accuracy: 0.7058000019192696
10000/10000 [==============================] - 2s 209us/step
accuracy: 0.797899999320507
以上就是python神经网络Keras实现GRU及其参数量的详细内容,更多关于Keras实现GRU参数量的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









