

Python CSV数据K-means聚类分析实战:2D与3D可视化

发布时间:2026-10-15| 4人浏览过
本文详解如何使用Python读取CSV文件,利用sklearn库进行K-means聚类分析。通过2D时间-高程序列与3D经纬度高程空间数据两种场景,展示不同数据量级下的聚类效果与性能表现。文中包含完整代码实现、参数调整技巧及针对百万级数据的处理建议,帮助开发者掌握空间点聚类可视化的核心方法。
1.运行环境及数据
实验基于Python 3.7版本,开发工具选用PyCharm Community Edition 2021.1.1,操作系统为Windows 10。
主要依赖的Python库包括matplotlib用于绘图、numpy进行数值计算、sklearn执行聚类算法以及pandas处理数据。
测试数据为CSV格式文件,内容涵盖时间、经纬度坐标及高程信息。
2.基于时间序列的分析2D
首先提取CSV中的时间列与高程列进行二维空间下的聚类分析:
具体实现代码如下:
from PIL import Image
import matplotlib.pyplot as plt
import numpy as np
from sklearn.cluster import KMeans, MiniBatchKMeans
import pandas as pd

if __name__ == "__main__":
    data = pd.read_csv(r"H:\CSDN_Test_Data\UseYourTestData.csv")
    x, y = data['Time (sec)'], data['Height (m HAE)']
    n = len(x)
    x = np.array(x)
    x = x.reshape(n, 1)#reshape 为一列
    y = np.array(y)
    y = y.reshape(n, 1)#reshape 为一列
    data = np.hstack((x, y)) #水平合并为两列
    k = 8  # 设置颜色聚类的类别个数(我们分别设置8,16,32,64,128进行对比)
    cluster = KMeans(n_clusters=k)  # 构造聚类器
    C = cluster.fit_predict(data)
    # C_Image = cluster.fit_predict(data)
    print("训练总耗时为:%s(s)" % (Trainingtime).seconds)
    plt.figure()
    plt.scatter(data[:, 0], data[:, 1], marker='o', s=2, c=C)
    plt.show()
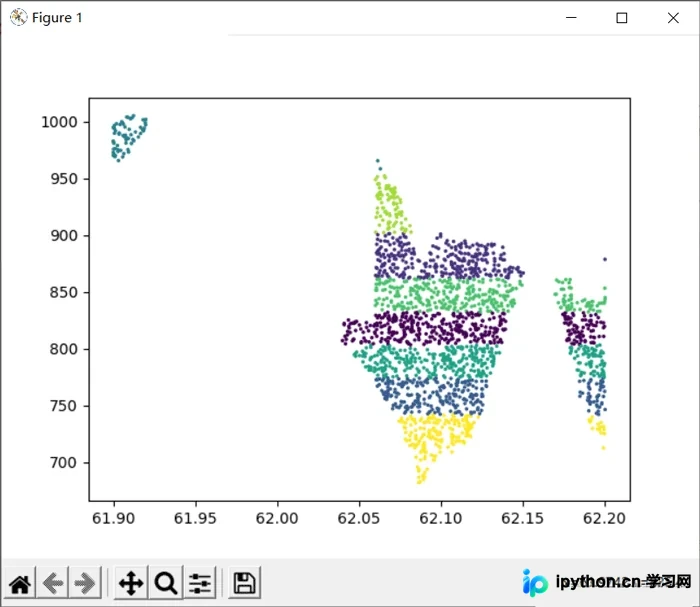
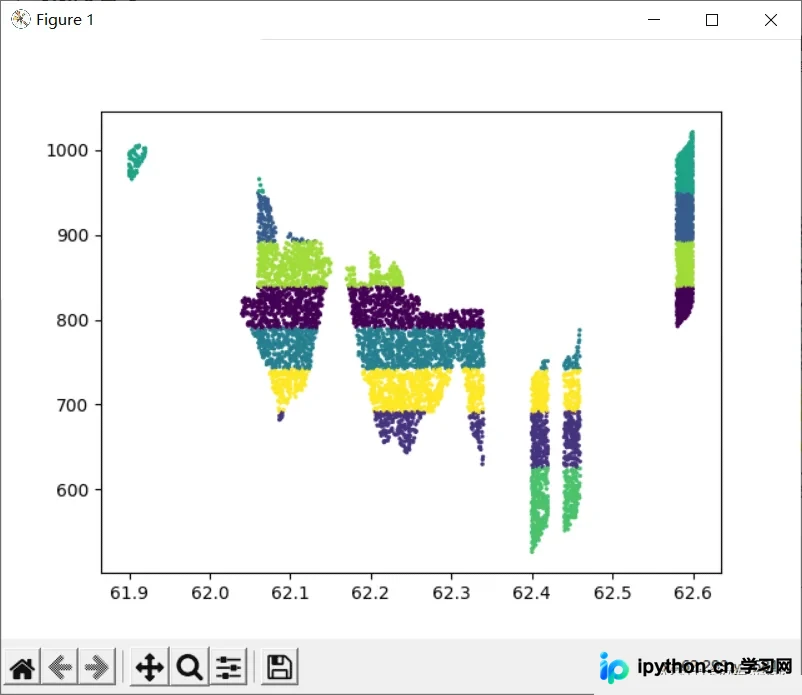
生成的可视化结果如下所示:
2.1 2000行数据结果展示
2.2 6950行数据结果展示
2.3 300M,约105万行数据结果展示
处理该量级数据时,CPU占用率迅速攀升至90%以上。整个计算过程耗时约1至2分钟,整体运行效率尚可。
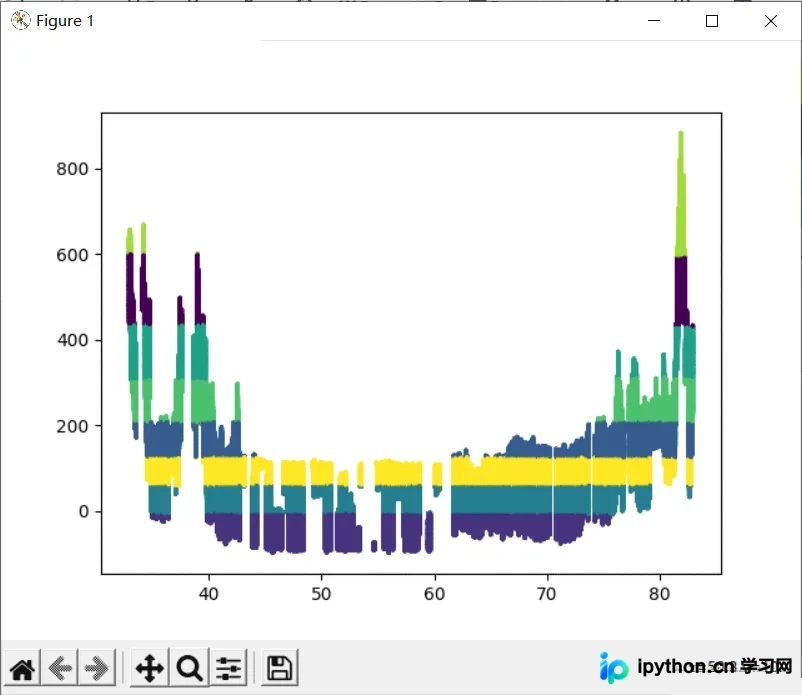
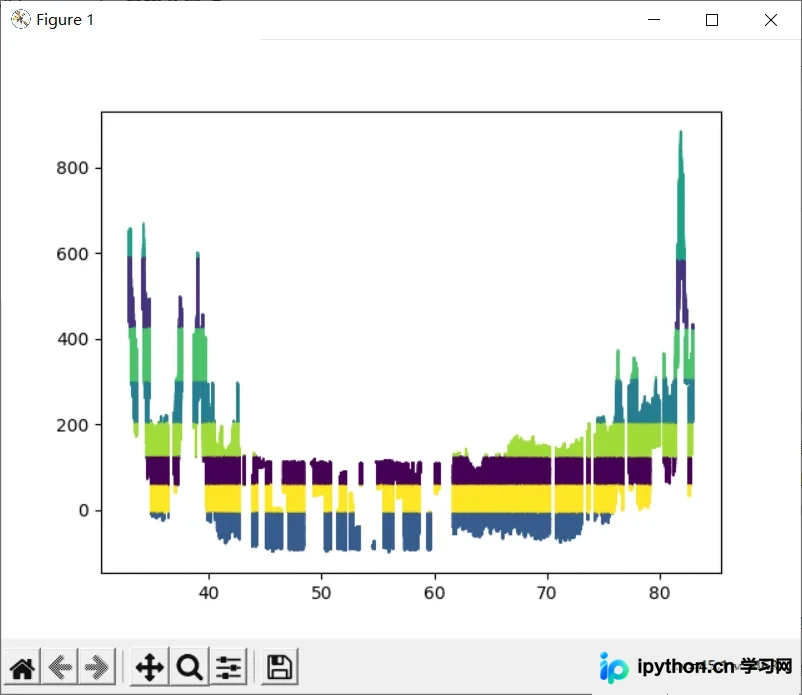
观察markersize参数发现图形过于密集,因此将markersize参数值调整为0.1以缩小显示比例,但即便调整,由于数据点过多,聚类边界仍不够清晰。
3.经纬度高程三维坐标分类显示3D-空间点聚类
修改代码逻辑,读取对应的经度、纬度和高程列,将其映射为X、Y、Z三维坐标,具体代码如下:
from PIL import Image
import matplotlib.pyplot as plt
import numpy as np
from sklearn.cluster import KMeans, MiniBatchKMeans
import pandas as pd
from mpl_toolkits.mplot3d import Axes3D

if __name__ == "__main__":
    data = pd.read_csv(r"H:\CSDN_Test_Data\UseYourTestData.csv")
    x, y,z = data['Longitude (deg)'],data['Latitude (deg)'],  data['Height (m HAE)']
    n = len(x)
    x = np.array(x)
    x = x.reshape(n, 1)#reshape 为一列
    y = np.array(y)
    y = y.reshape(n, 1)#reshape 为一列
    z = np.array(z)
    z = z.reshape(n, 1)  # reshape 为一列
    data = np.hstack((x, y, z)) #水平合并为两列
    k = 8  # 设置颜色聚类的类别个数(我们分别设置8,16,32,64,128进行对比)
    cluster = KMeans(n_clusters=k)  # 构造聚类器
    C = cluster.fit_predict(data)

    # C_Image = cluster.fit_predict(data)
    print("训练总耗时为:%s(s)" % (Trainingtime).seconds)
    fig = plt.figure()
    ax = Axes3D(fig)

    ax.scatter(data[:, 0], data[:, 1],data[:, 2], s=1, c=C)
    # 绘制图例
    ax.legend(loc='best')
    # 添加坐标轴
    ax.set_zlabel('Z Label', fontdict={'size': 15, 'color': 'red'})
    ax.set_ylabel('Y Label', fontdict={'size': 15, 'color': 'red'})
    ax.set_xlabel('X Label', fontdict={'size': 15, 'color': 'red'})
    plt.show()
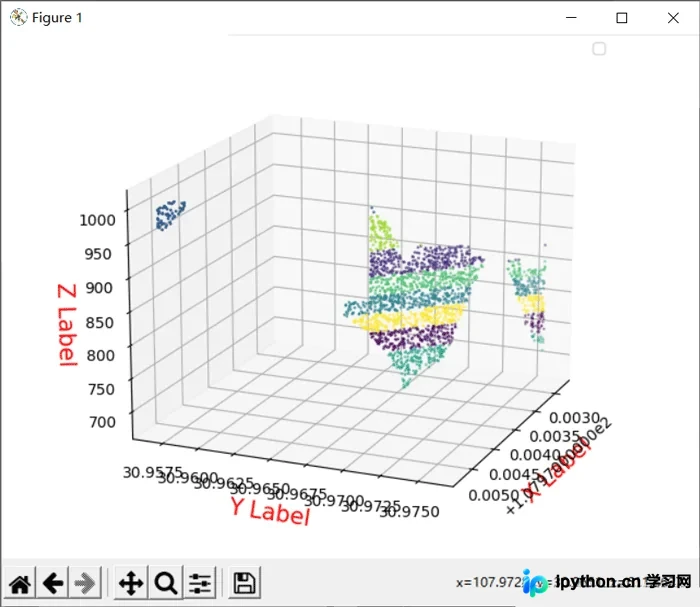
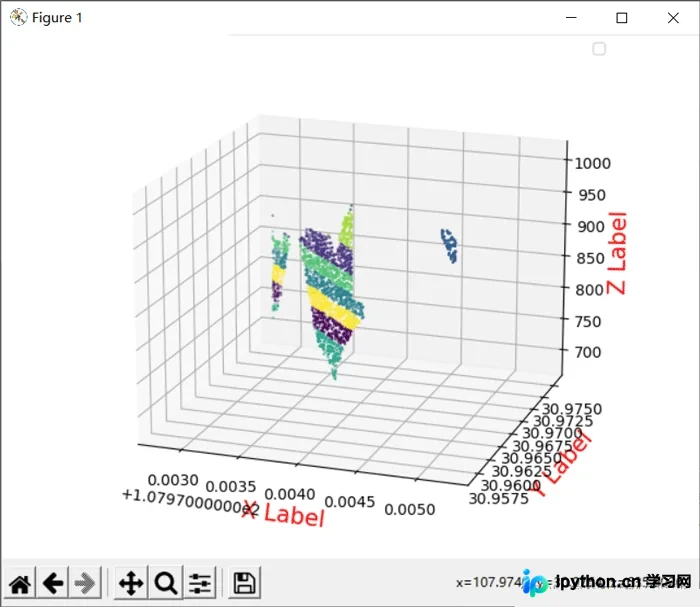
3.1 2000行数据结果显示
由于经度变化范围在纬度方向上仅约17米,导致三维立体视觉效果不佳,建议更换其他数据源进行测试以获得更佳的展示效果。
3.2 300M的CSV数据计算显示效果
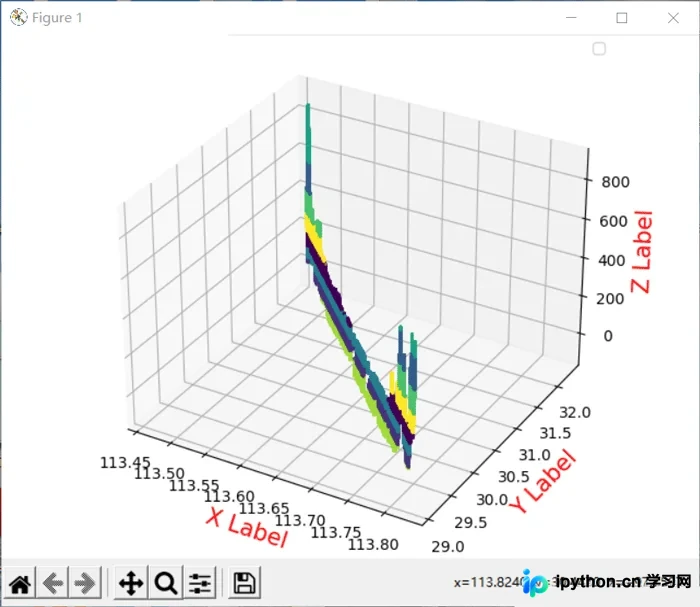
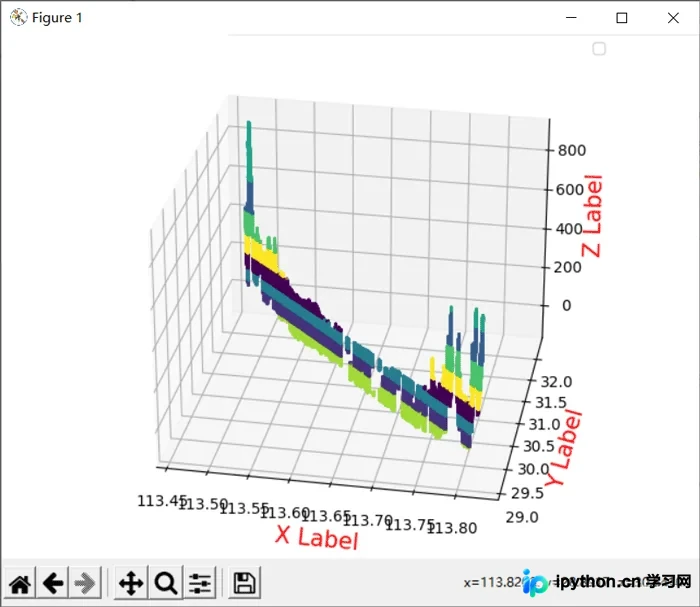
针对105万行数据的三维聚类结果显示如下:
至此,关于Python读取CSV文件进行K-means分析的详细介绍已完毕。如需了解更多Python处理CSV的相关内容,可查阅本站往期文章或继续浏览后续教程,感谢大家的支持。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









