

JS基本类型与引用类型的区别是什么

JavaScript 的数据类型分为基本类型和引用类型,二者最本质的区别在于内存存储位置和赋值时的拷贝行为。基本类型直接存储在栈内存中,赋值时进行值拷贝;引用类型在栈中存储指向堆内存的地址,赋值时仅复制地址引用。理解这一机制是避免“修改一个变量意外影响另一个变量”这类 Bug 的关键。
为什么修改副本会影响原数据
很多开发者在处理对象或数组时会遇到这样的现象:明明是将变量 A 赋值给变量 B,随后只修改了 B,结果 A 的值也变了。这并非 JavaScript 的 Bug,而是引用类型的默认行为。
当我们将一个对象赋值给新变量时,JavaScript 并没有在内存中重新创建一份相同的数据,而是将原对象在堆内存中的地址引用复制给了新变量。此时,两个变量指向的是同一个堆内存空间。
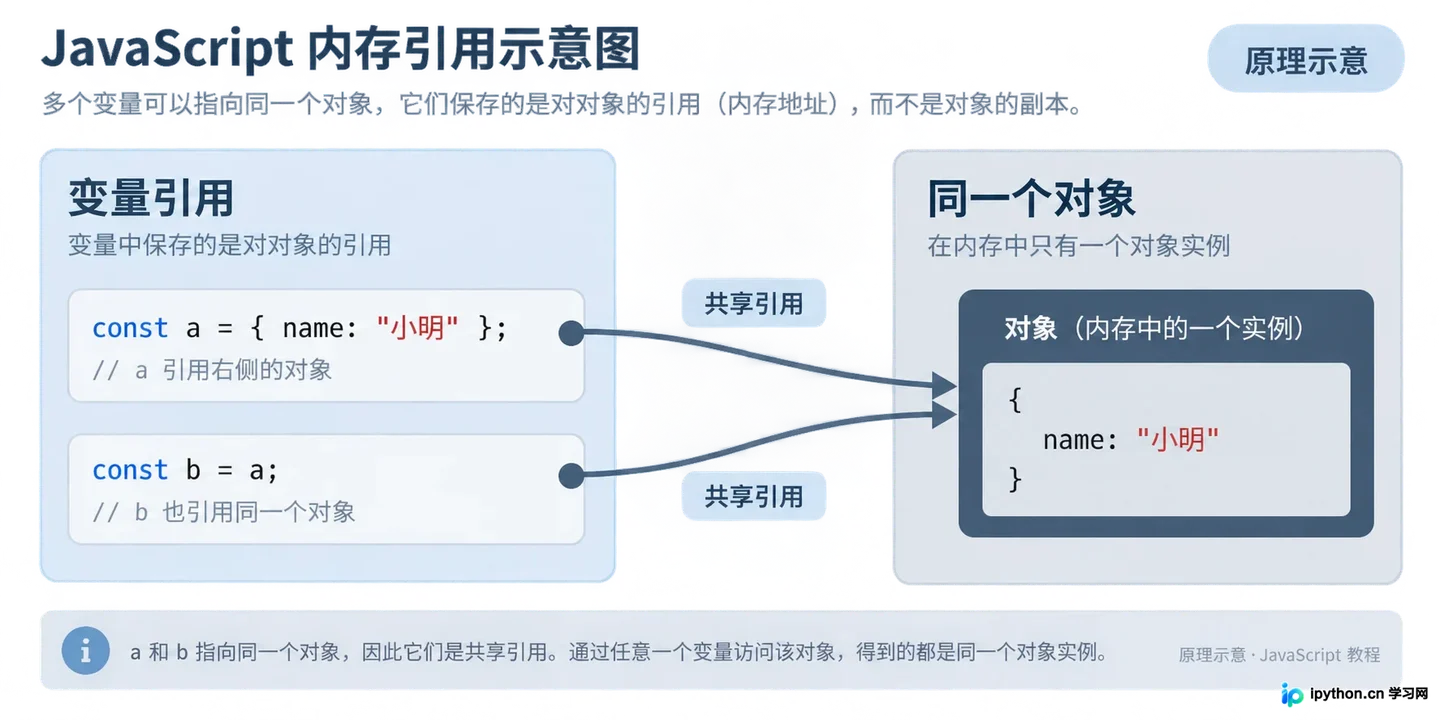
两个变量指向同一堆内存地址,修改任一变量均影响对方
看下面这段代码:
let userA = { name: 'Alice', age: 25 };
let userB = userA; // 仅复制引用地址

userB.name = 'Bob';

console.log(userA.name); // 输出: 'Bob'
console.log(userB.name); // 输出: 'Bob'
userA 和 userB 在栈内存中各自拥有一块空间,但它们存储的内容都是指向堆中同一个对象的指针。因此,通过任一变量修改堆中的数据,都会反映在另一个变量上。这种共享引用的机制在处理大型数据时能节省内存,但在需要独立副本的场景下极易引发副作用。
相比之下,基本类型(如 Number, String, Boolean, Null, Undefined, Symbol, BigInt)的行为则完全不同:
let scoreA = 100;
let scoreB = scoreA; // 复制具体的值

scoreB = 90;

console.log(scoreA); // 输出: 100
console.log(scoreB); // 输出: 90
基本类型的值直接存储在栈内存中,赋值操作会在栈中开辟一块新的内存空间并填入相同的值。此后两个变量完全独立,互不影响。
内存模型如何决定性能与行为
JavaScript 引擎通常将内存分为栈(Stack)和堆(Heap)。栈内存空间较小但存取速度快,适合存储大小固定、生命周期明确的数据;堆内存空间大但存取相对较慢,用于存储大小不固定、结构复杂的数据。
- 基本类型:占用空间小且固定,直接存放在栈中。访问时直接读取栈内的值,速度极快。
- 引用类型:对象、数组、函数等大小动态变化,存放在堆中。栈中仅保存一个指向堆地址的指针。访问时需要先读取栈中的地址,再跳转到堆中获取数据,多了一次寻址过程。
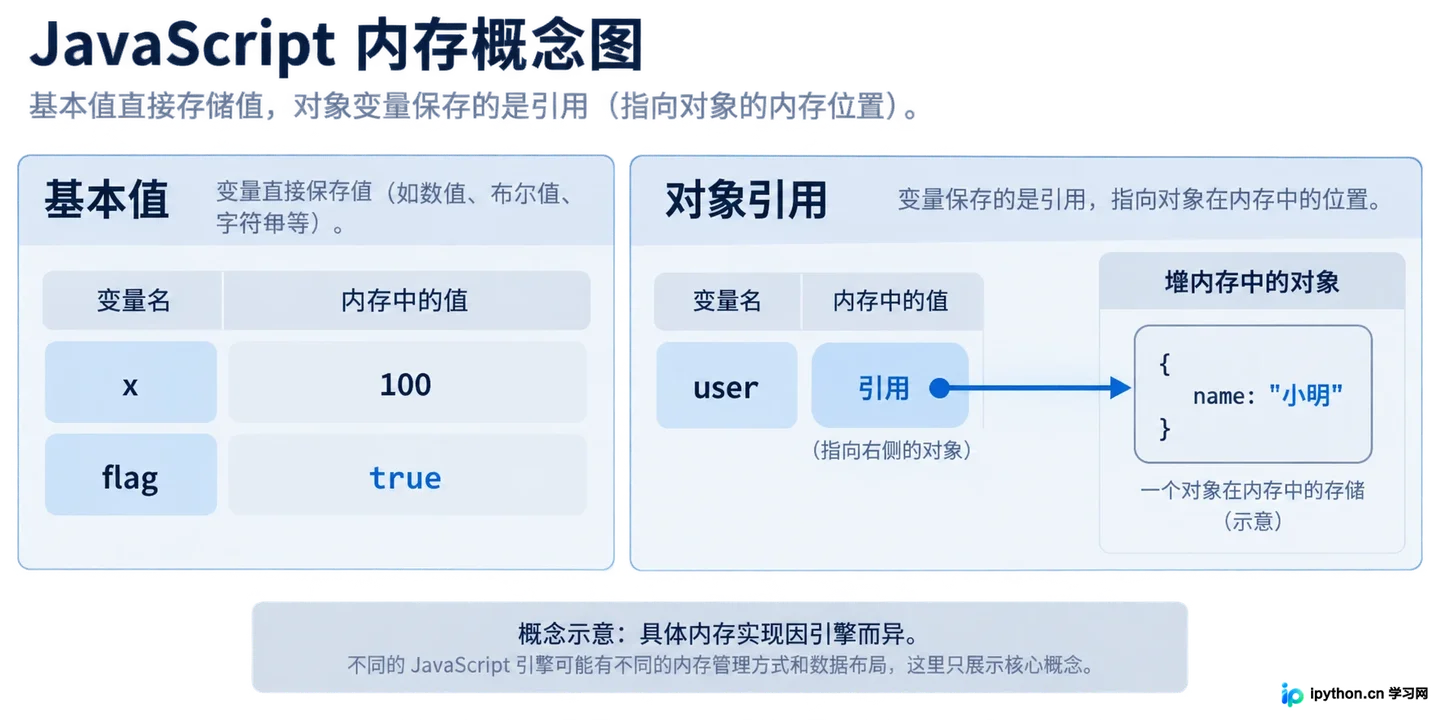
基本类型直接存于栈,引用类型地址存于栈、数据存于堆
这种差异导致了它们在比较操作中的不同表现。基本类型比较的是值本身,而引用类型比较的是内存地址。
// 基本类型比较值
console.log(10 === 10); // true

// 引用类型比较地址
let obj1 = { id: 1 };
let obj2 = { id: 1 };
let obj3 = obj1;

console.log(obj1 === obj2); // false (不同地址)
console.log(obj1 === obj3); // true (相同地址)
即使 obj1 和 obj2 的内容完全一样,由于它们是在堆中分别分配的两个独立对象,地址不同,严格相等判断结果为 false。这在编写去重逻辑或状态判断时经常成为陷阱。
如何安全地创建独立副本
既然引用赋值会导致共享修改,那么在需要独立操作数据时,就必须进行真正的拷贝。根据数据结构的复杂度,可以选择浅拷贝或深拷贝。
浅拷贝的局限
浅拷贝只复制对象的第一层属性。如果属性值是基本类型,则复制值;如果属性值是引用类型,则继续复制地址。这意味着嵌套对象依然会共享引用。
常用的浅拷贝方法包括展开运算符 ... 和 Object.assign():
let original = {
  name: 'Alice',
  settings: { theme: 'dark' }
};

// 使用展开运算符进行浅拷贝
let copy = { ...original };

copy.name = 'Bob'; // 不影响 original.name
copy.settings.theme = 'light'; // 影响 original.settings.theme

console.log(original.settings.theme); // 输出: 'light'
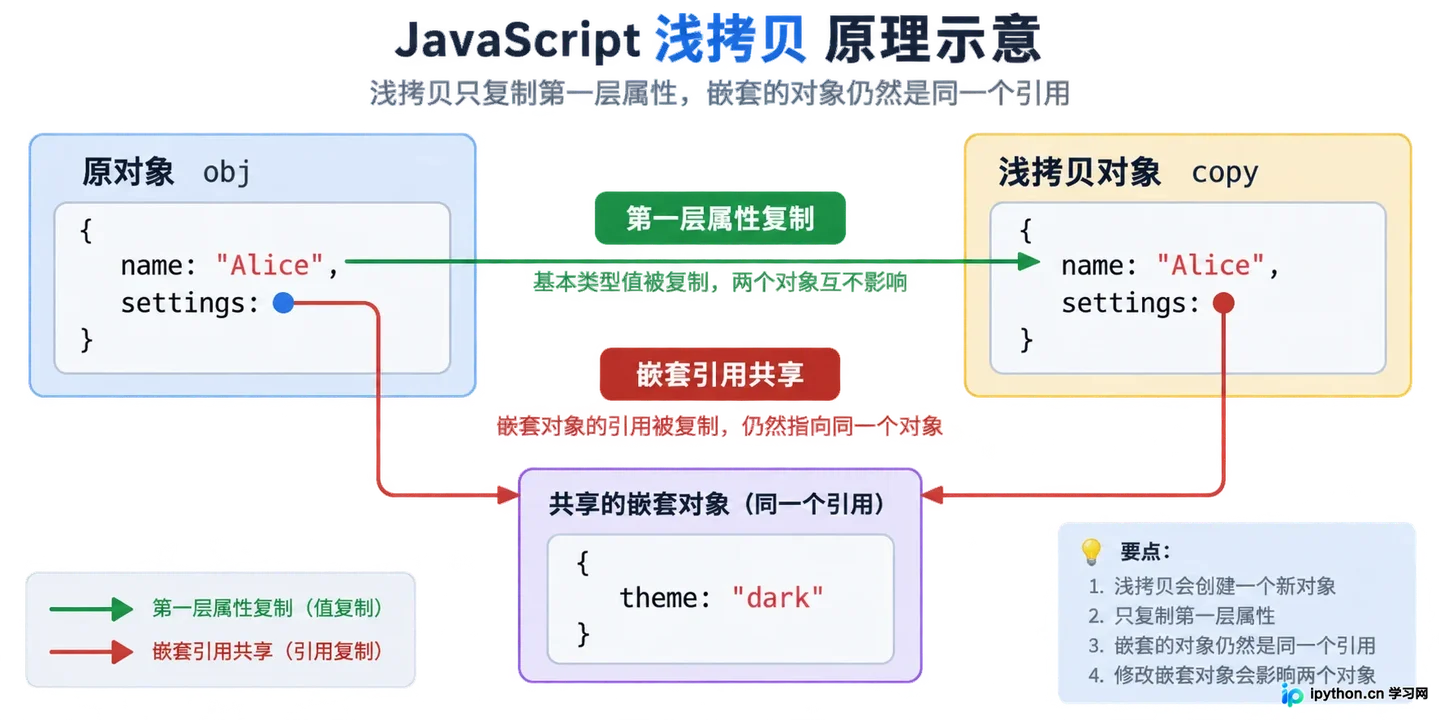
浅拷贝仅复制第一层,嵌套对象仍共享引用
可以看到,修改嵌套对象 settings 时,原数据也被改变了。这是因为 copy.settings 和 original.settings 指向的是堆中同一个对象。
深拷贝的适用场景
如果需要完全独立的副本,包括嵌套对象,就需要深拷贝。最简单的方式是使用 JSON.parse(JSON.stringify(obj)),但它有明确的边界:无法处理函数、Undefined、Symbol、Date 对象以及循环引用。
let deepOriginal = {
  name: 'Alice',
  meta: { created: new Date() },
  action: function() {}
};

let deepCopy = JSON.parse(JSON.stringify(deepOriginal));

console.log(deepCopy.meta.created); // 输出: 字符串格式的时间,而非 Date 对象
console.log(deepCopy.action); // 输出: undefined
对于更复杂的场景,建议使用结构化克隆算法 structuredClone()(现代浏览器支持)或成熟的第三方库如 Lodash 的 _.cloneDeep。
// 现代浏览器支持的深拷贝
let safeCopy = structuredClone(deepOriginal);
选择拷贝策略的原则是:如果数据层级简单且无嵌套引用,浅拷贝足够且性能更好;如果数据结构复杂且需要完全隔离,必须使用深拷贝。 不要盲目对所有对象进行深拷贝,这会带来不必要的性能开销。
理解栈与堆的分工,就能预判变量的行为。在赋值前问自己一句:我需要的是值的备份,还是引用的共享?这个简单的判断能规避大多数数据污染问题。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









