

Python机器学习:决策树算法特点、适用场景与代码实战

发布时间:2026-10-15| 5人浏览过
本文深入解析Python中决策树算法的核心特性,详细列举其高解释性与易过拟合等优缺点,并探讨其在非线性关系处理及医疗辅助等场景的应用。通过完整代码示例展示如何构建、训练及可视化决策树模型,帮助开发者快速掌握基于决策树的分类预测技术。
一、决策树的特点
1.优点
- 具备出色的可解释性,能够生成人类易于理解的分类规则。
- 能够有效识别并评估特征的重要性排序。
- 模型构建与预测的计算复杂度相对较低。
2.缺点
- 模型极易出现过拟合现象,必须借助剪枝技术进行优化处理。
- 对连续型特征的处理能力相对较弱。
- 整体预测精度有限,难以媲美其他高性能的强监督学习模型。
- 模型方差较高,数据分布的微小变动可能导致生成的树结构发生巨大改变。
二、决策树的适用场景
- 决策树模型主要适用于处理自变量与因变量之间存在非线性关系的问题。
- 梯度提升树(GBDT)、XGBoost以及LightGBM等先进的集成学习模型,均将决策树作为基础模型(如多粒度联合森林模型)。
- 在明确要求高可解释性或需提取明确分类规则的场景中,决策树应用广泛。例如在医疗辅助系统中,为便于专业人员排查错误,常利用决策树算法辅助病症检测。
三、demo
#%%demo
##  基础函数库导入
import numpy as np

## 导入画图库
import matplotlib.pyplot as plt
import seaborn as sns

## 导入决策树模型函数
from sklearn.tree import DecisionTreeClassifier
from sklearn import tree
import pydotplus
from IPython.display import Image
##Demo演示DecisionTree分类
## 构造数据集
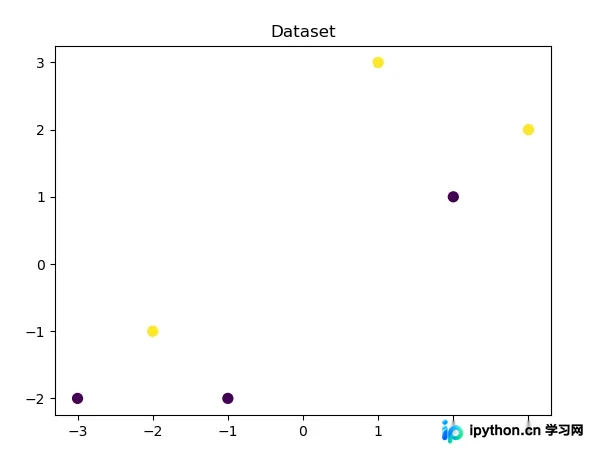
x_fearures = np.array([[-1, -2], [-2, -1], [-3, -2], [1, 3], [2, 1], [3, 2]])
y_label = np.array([0, 1, 0, 1, 0, 1])
## 调用决策树回归模型
tree_clf = DecisionTreeClassifier()
## 调用决策树模型拟合构造的数据集
tree_clf = tree_clf.fit(x_fearures, y_label)
## 可视化构造的数据样本点
plt.figure()
plt.scatter(x_fearures[:,0],x_fearures[:,1], c=y_label, s=50, cmap='viridis')
plt.title('Dataset')
plt.show()
## 可视化决策树
import graphviz
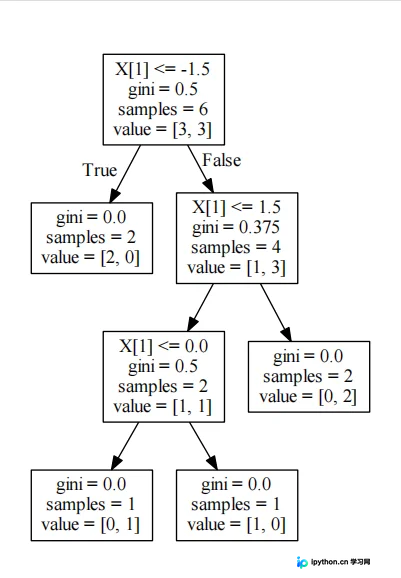
dot_data = tree.export_graphviz(tree_clf, out_file=None)
graph = pydotplus.graph_from_dot_data(dot_data)
graph.write_pdf("D:\Python\ML\DecisionTree.pdf")
# 模型预测
## 创建新样本
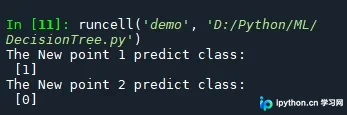
x_fearures_new1 = np.array([[0, -1]])
x_fearures_new2 = np.array([[2, 1]])

## 在训练集和测试集上分布利用训练好的模型进行预测
y_label_new1_predict = tree_clf.predict(x_fearures_new1)
y_label_new2_predict = tree_clf.predict(x_fearures_new2)

print('The New point 1 predict class:\n',y_label_new1_predict)
print('The New point 2 predict class:\n',y_label_new2_predict)
运行结果
训练集决策树
后续内容预告:明天将继续介绍决策树在真实数据集上的应用,目前先专注于课题研究。
至此,关于Python机器学习应用中基于决策树算法的分类预测篇介绍完毕。如需了解更多Python决策树算法相关内容,欢迎查阅本站往期文章或继续浏览后续文章,感谢大家的支持!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









