

Python 切片为什么不会索引越界?

本文深入解析Python切片机制,解释为何切片索引越界时不抛出异常而是自动截断。通过官方文档定义与代码示例,对比Go、Rust等语言的不同处理策略,探讨Python设计切片边界修正逻辑的原因与原理。
Python 切片基础语法与特性
切片操作主要针对序列类型对象,依据指定的索引区间提取子序列内容。
切片的标准语法格式为 [[wp:a1 : i+n : m]]。其中,i 代表起始索引,若从序列开头开始可省略;i+n 代表结束索引(不包含该位置),若截取至末尾可省略;m 为步长,默认值为 1,严禁为 0,若为负数则表示反向遍历并翻转列表。
切片的核心逻辑是:从序列的第 i 个索引位置开始,向右延伸至第 n 个元素位置结束,并按照 m 设定的步长进行元素筛选。
以下示例涵盖了切片语法的关键使用场景:
# @Python猫
li = [1, 4, 5, 6, 7, 9, 11, 14, 16]

# 以下写法都可以表示整个列表,其中 X >= len(li)
li[0:X] == li[0:] == li[:X] == li[:] == li[::] == li[-X:X] == li[-X:]

li[1:5] == [4,5,6,7] # 从1起,取5-1位元素
li[1:5:2] == [4,6] # 从1起,取5-1位元素,按2间隔过滤
li[-1:] == [16] # 取倒数第一个元素
li[-4:-2] == [9, 11] # 从倒数第四起,取-2-(-4)=2位元素
li[:-2] == li[-len(li):-2] == [1,4,5,6,7,9,11] # 从头开始,取-2-(-len(li))=7位元素

# 步长为负数时,列表先翻转,再截取
li[::-1] == [16,14,11,9,7,6,5,4,1] # 翻转整个列表
li[::-2] == [16,11,7,5,1] # 翻转整个列表,再按2间隔过滤
li[:-5:-1] == [16,14,11,9] # 翻转整个列表,取-5-(-len(li))=4位元素
li[:-5:-3] == [16,9] # 翻转整个列表,取-5-(-len(li))=4位元素,再按3间隔过滤

# 切片的步长不可以为0
li[::0]  # 报错(ValueError: slice step cannot be zero)
其他编程语言对切片的支持对比
诸如 C/C++、Java 和 JavaScript 等编程语言,虽然具备截取数组或字符串片段的“切片”功能,但在语法层面缺乏像 Python 那样统一且通用的支持机制。
据维基百科记载,Fortran 是最早引入切片语法(1966年)的语言,而 Python 则是该特性最具代表性的实现语言之一。
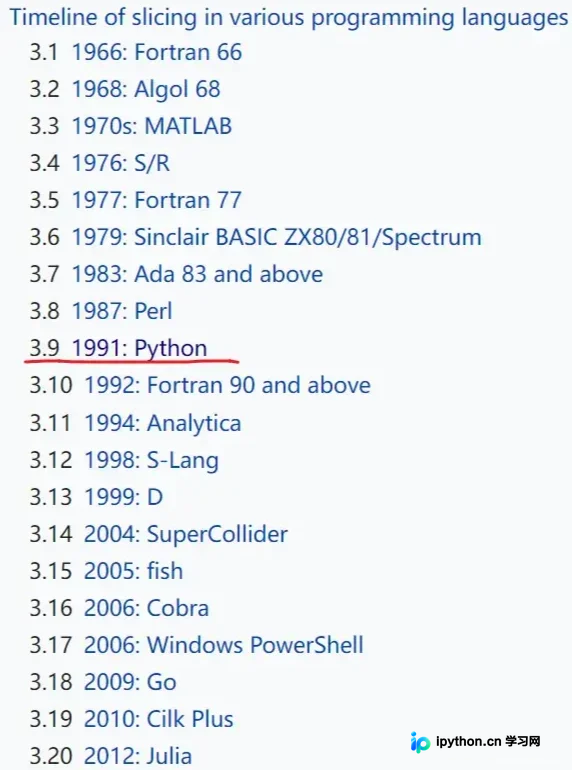
主要编程语言对切片的支持情况如下表所示:
此外,Perl、Ruby、Go 和 Rust 等语言也支持切片功能,但其灵活性和自由度均不及 Python ,后者支持步长、负数索引及缺省索引等高级特性。
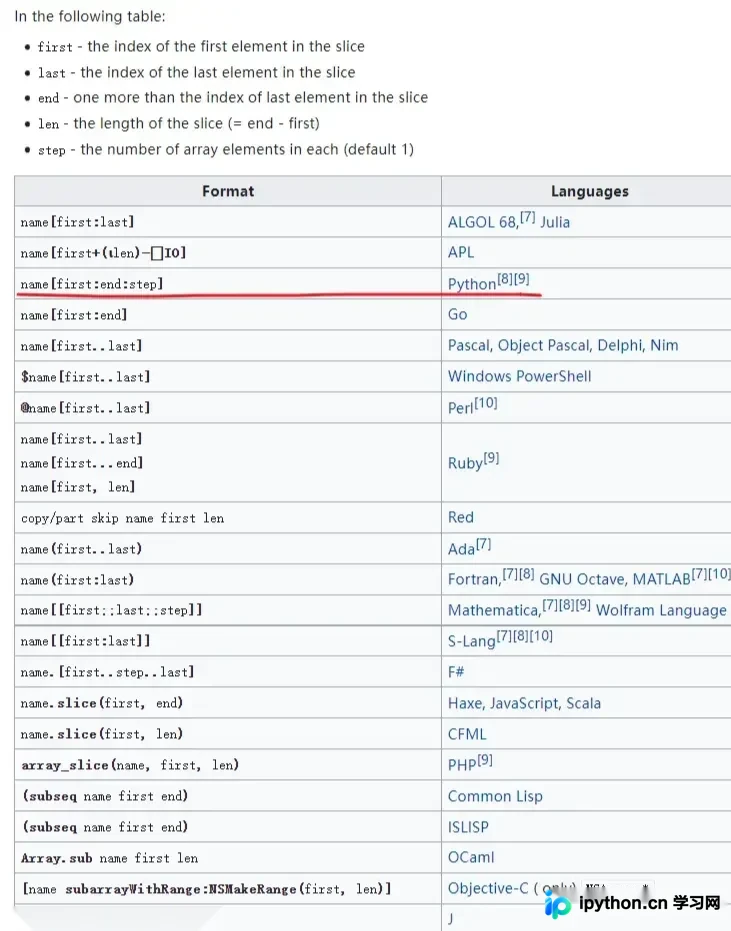
不同编程语言中切片语法的具体表现形式存在差异。
Python 切片的进阶用法
基础切片用法已能满足大多数日常需求,但 Python 切片还包含进阶技巧,例如利用切片占位符进行列表赋值、删除与拼接、为自定义对象实现切片协议、使用迭代器切片(itertools.islice())以及对文件对象进行切片等。相关深入阅读:Python全面解读高级特性切片。
关于切片基础介绍的回顾至此结束。
Python 切片索引越界机制解析
接下来探讨文章核心问题:Python 切片语法为何不会触发索引越界错误?
当通过单个索引访问元素时,若索引超出有效范围,程序会抛出报错信息 :“IndexError: list index out of range”。。
>>> li = [1, 2]
>>> li[5]
Traceback (most recent call last):
  File "<stdin>", line 1, in <module>
IndexError: list index out of range
对于长度为 length 的非空序列对象,其有效索引范围是从 0 到(length - 1)。若考虑负数索引,单个索引的有效区间为 [-length, length - 1] 闭区间。
然而,当 Python 切片操作中的索引超出上述范围时,程序并不会报错。
>>> li = [1, 2]
>>> li[1:5]  # 右索引超出
[2]
>>> li[5:6]  # 左右索引都超出
[]
针对这一现象,Python 官方文档中有明确说明:
The slice of s from i to j is defined as the sequence of items with index k such that i <= k < j. If i or j is greater than len(s), use len(s). If i is omitted or None, use 0. If j is omitted or None, use len(s). If i is greater than or equal to j, the slice is empty.
具体规则解读如下:
- 当左索引或右索引值大于序列长度时,系统自动将该索引值修正为序列长度;
- 当左索引值省略或为 None 时,默认使用 0 作为左索引;
- 当右索引值省略或为 None 时,默认使用序列长度作为右索引;
- 当左索引值大于或等于右索引值时,切片结果为空序列。
结合前述示例,可以得出以下结论:
>>> li = [1, 2]
>>> li[1:5]  # 等价于 li[1:2]
[2]
>>> li[5:6]  # 等价于 li[2:2]
[]
总结而言:Python 解释器自动屏蔽了可能导致索引越界的异常,允许用户自由书写切片表达式,但最终结果会被严格限制在合法的索引区间内。
切片设计哲学与其他语言对比
对此机制,作者感到些许疑惑:为何 Python 不直接抛出索引越界错误?为何要修正切片边界值?为何即便返回空序列也要给出结果而非报错?
当执行“li[5:6]”时,字面意图是“取出索引 5 到 6 对应的值”,类似于“取出书架上从左数第 6 和第 7 本书”。
若程序严格遵循指令逻辑,应当报错提示:书籍数量不足,无法取出指定范围的书籍。
目前尚未查到官方对此设计哲学的详细解释,本文旨在引发讨论与解答,而非科普 Python 设计的独特见解。
在 Go 语言中,遇到相同场景时,会报错“runtime error: slice bounds out of range”。”。
在 Rust 语言中,遇到相同场景时,会报错“byte index 5 is out of bounds of ......”。”。
其他支持切片语法的语言可能也有类似 Python 的设计,但具体实现尚不明确(受限于作者知识储备)。
回到标题问题“Python 的切片为什么不会索引越界”,作者主要想探讨两个子问题:
当切片语法中的索引超出边界时,为什么 Python 还能返回结果,返回结果的计算原理是什么? 为什么 Python 的切片语法要允许索引超出边界呢,为什么不设计成抛出索引错误? 对于第一个问题的回答,官方文档已经写得很明确了。
到此这篇关于Python 切片为什么不会索引越界?的文章就介绍到这了,更多相关Python 切片为什么不会索引越界?内容请搜索本站以前的文章或继续浏览下面的相关文章希望大家以后多多支持本站!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









