

Python深度学习神经网络基本原理:梯度下降与核心概念解析

本文深入解析Python深度学习中的神经网络基本原理,重点阐述梯度下降法的核心机制。内容涵盖步长、特征、假设函数及损失函数的定义与作用,通过线性回归示例说明模型拟合过程,帮助开发者理解优化算法背后的数学逻辑。
神经网络
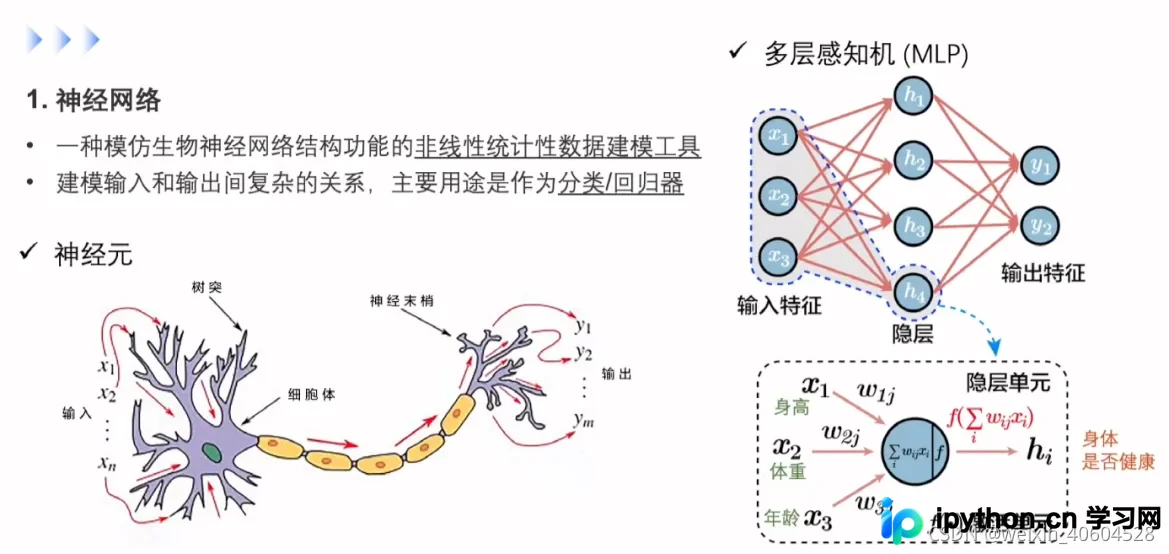
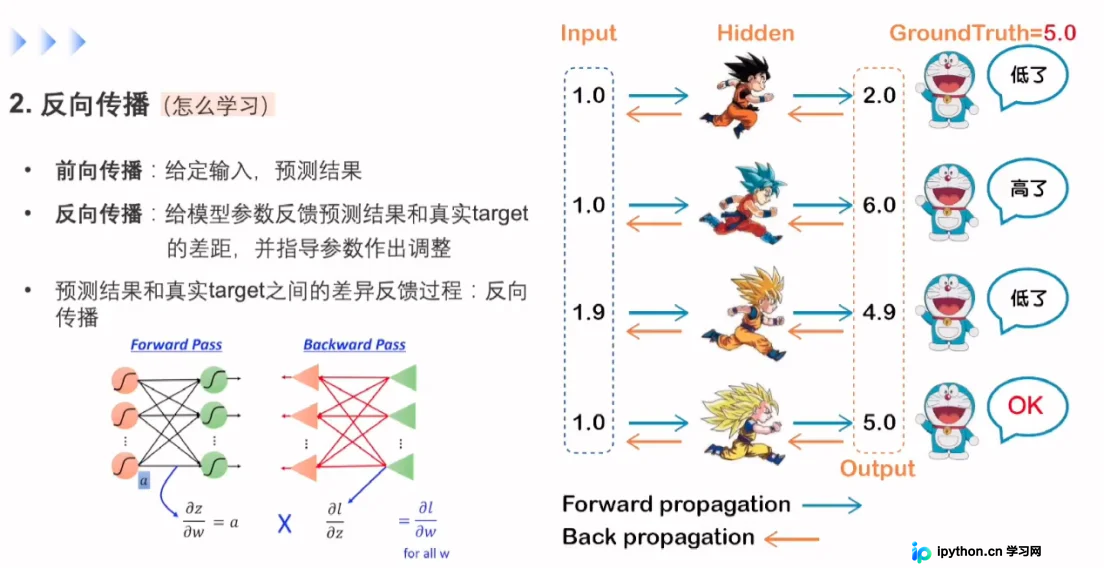
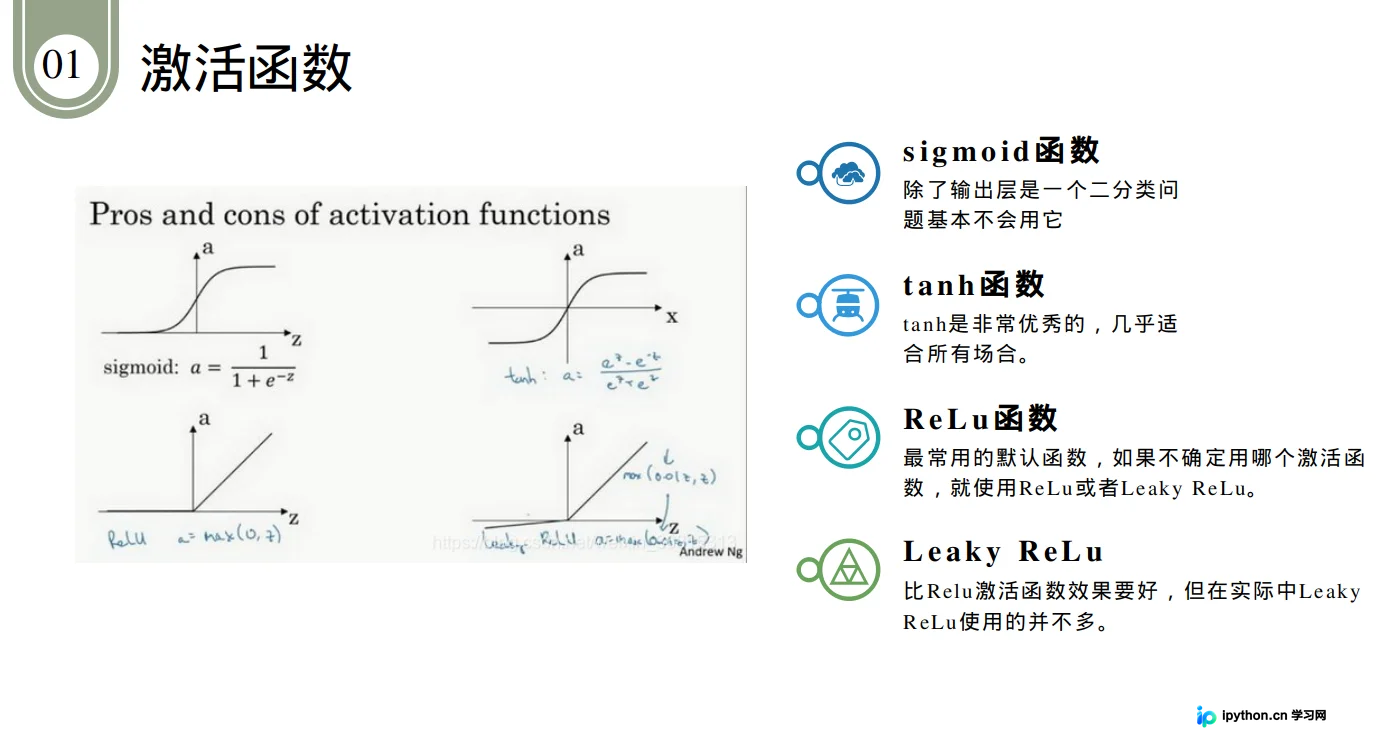
梯度下降法
在深入探讨梯度下降算法的具体实现之前,有必要先厘清几个关键的基础概念。
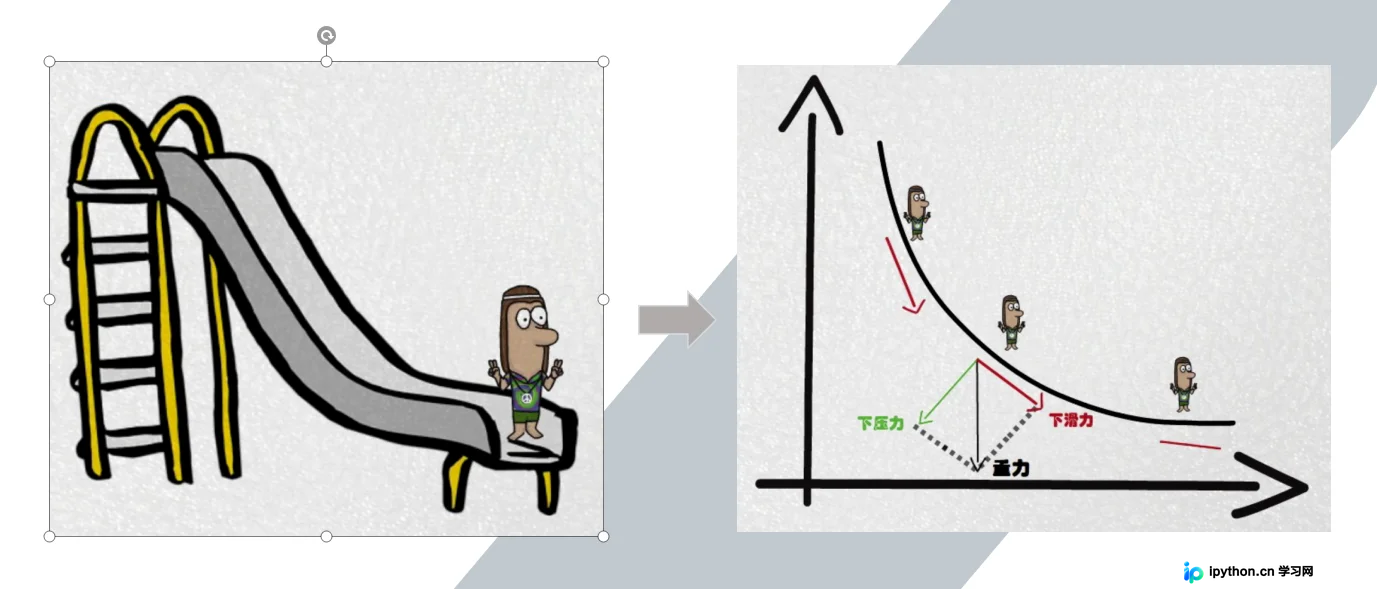
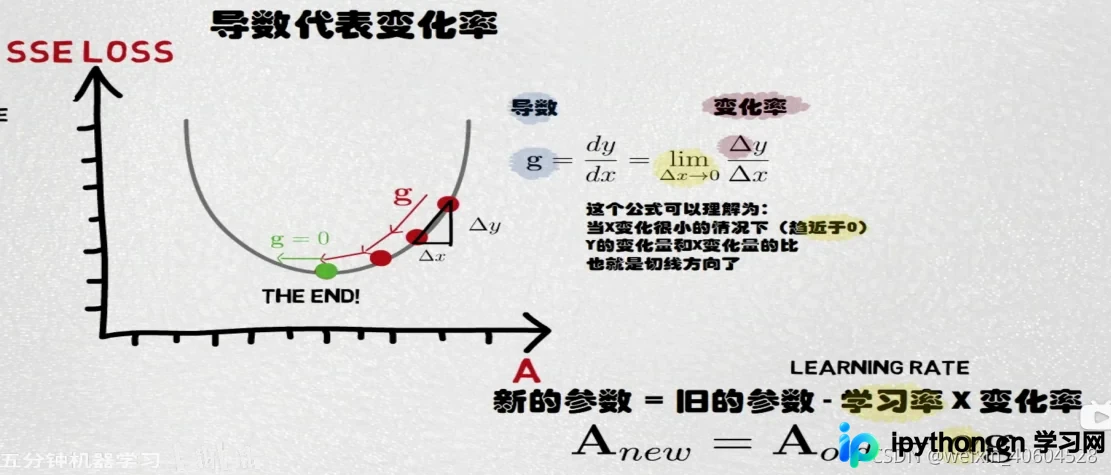
1. 步长(Learning rate):步长决定了在梯度下降迭代过程中,每一步沿梯度负方向前进的距离。以上山下山为例,步长相当于在当前所在位置,沿着最陡峭且最容易下行的方向所迈出的那一步的长度。
2. 特征(feature):指代样本中的输入部分。例如,对于两个单特征样本(x(0),y(0))和(x(1),y(1)),第一个样本的特征值为x(0),对应的输出值为y(0)。
3. 假设函数(hypothesis function):在监督学习中,为了拟合输入样本而采用的预测模型,记为hθ(x)。针对具有单个特征的m个样本(x(i),y(i))(其中i=1,2,...m),可采用如下拟合函数:hθ(x)=θ0+θ1x。
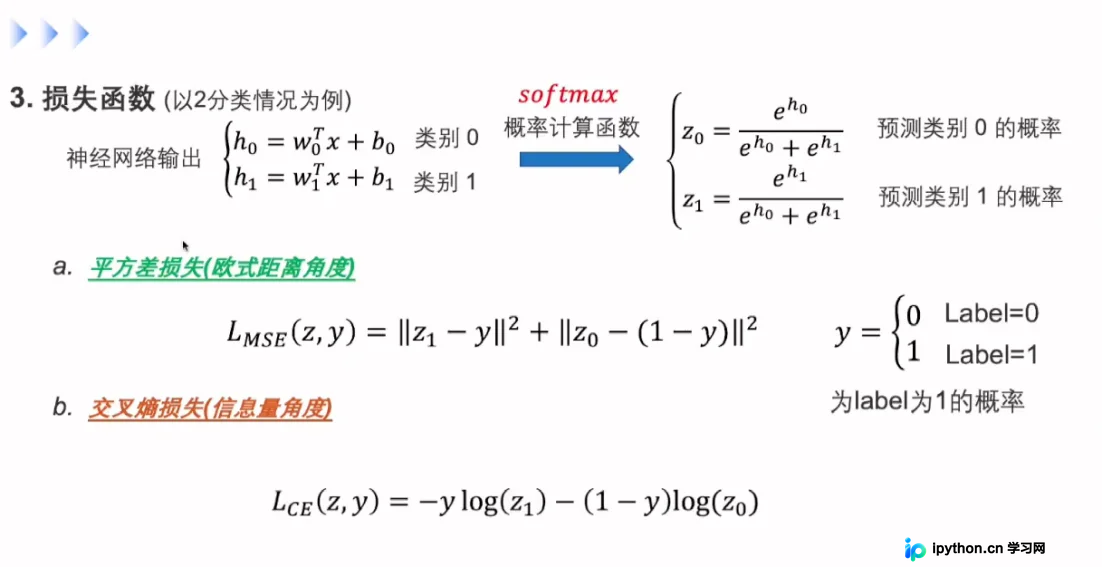
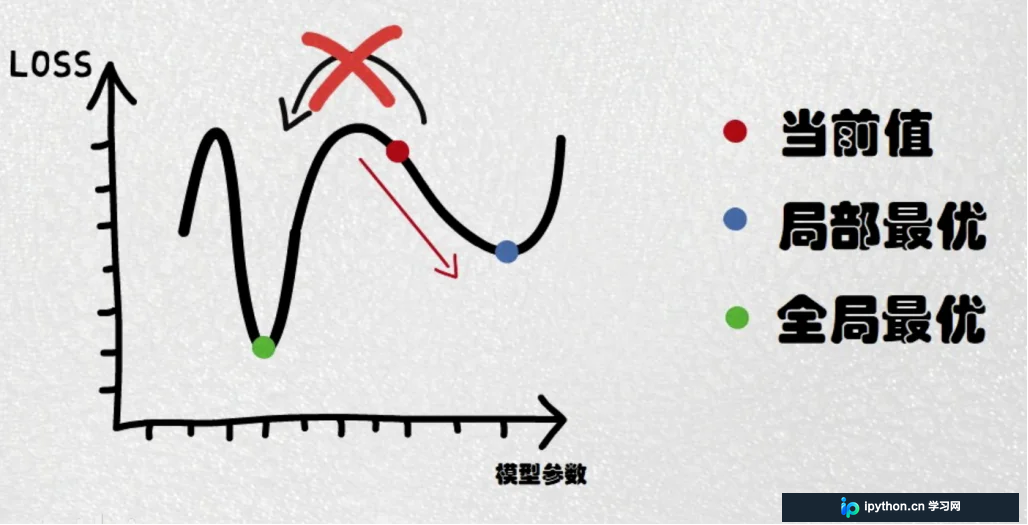
4. 损失函数(loss function):用于评估模型拟合效果,通常以损失函数来量化拟合程度。损失函数取极小值时,意味着拟合效果最佳,此时对应的模型参数即为最优参数。在线性回归场景中,损失函数通常定义为样本输出与假设函数预测值之差的平方和。例如,针对m个样本(xi,yi)(其中i=1,2,...m),采用线性回归时的损失函数表达式为:
J(θ0,θ1)=∑i=1m(hθ(xi)−yi)2
其中,xi表示第i个样本的特征值,yi表示第i个样本对应的真实输出值,hθ(xi)为假设函数的预测值。
分享人:张娇娟
到此这篇关于Python深度学习神经网络基本原理的文章就介绍到这了,更多相关Python 神经网络内容请搜索本站以前的文章或继续浏览下面的相关文章希望大家以后多多支持本站!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









