

Python使用py2neo查询Neo4j节点、关系及路径详解

本文详细介绍如何使用Python库py2neo查询Neo4j图数据库。内容涵盖从2021.1版本后的连接方式变更,到利用NodeMatcher和RelationshipMatcher进行节点与关系的匹配查询,以及通过执行Cypher语句处理复杂路径查询的方法。文中提供了具体的代码示例,展示如何将查询结果转换为pandas DataFrame或Series以便进行数据分析。
Neo4j作为一款开源图数据库,配合Py2neo库可为Python开发者提供便捷的访问接口。本文旨在阐述如何利用Py2neo中的NodeMatcher与RelationshipMatcher模块来检索图中的节点与关系,同时介绍通过直接执行Cypher语句进行查询的方法。本文所依据的Py2neo版本为2021.1及之后的版本,相关手册可参考:The Py2neo Handbook。
一、连接Neo4j数据库
本文将涉及多种数据类型,此处统一进行引用。
<import numpy as np import pandas as pd from py2neo import Node,Relationship,Graph,Path,Subgraph from py2neo import NodeMatcher,RelationshipMatcher
配置访问Neo4j数据库所需的地址、用户名及密码。
neo4j_url = '访问地址'
user = '用户名'
pwd = '密码'
在此版本更新之前,访问数据库的代码方式如下:
graph = Graph(neo4j_url, username=user, password=pwd)
在此版本更新之后,访问数据库的方式发生了改变(存在不兼容情况):
graph = Graph(neo4j_url, auth=(user, pwd))
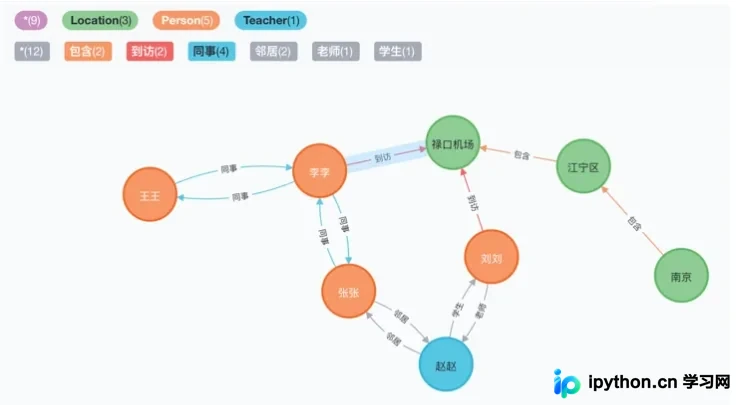
以下图为例:
- 图中包含若干Person节点,每个Person节点具备name、age及work属性;
- 其中“赵赵”节点拥有多重标签,除了Person标签外,还包含Teacher标签;
- Person节点之间存在同事、邻居、学生及老师等关系;
- 图中还包含若干Location节点,它们之间具有包含关系;
- Person节点与Location节点之间存在“到访”关系,该关系拥有date和stay_hours两个属性。
二、 通过graph.schema查询图中节点和关系有哪些类型
查看节点类型可使用graph.schema.node_labels,查看关系类型则使用graph.schema.relationship_types,两者的返回值类型均为frozenset,这是一种不可增删元素的集合类型。
>>>graph.schema.node_labels
frozenset({'Location', 'Person', 'Teacher'})
>>>graph.schema.relationship_types
frozenset({'到访', '包含', '同事', '学生', '老师', '邻居'})
三、使用NodeMatcher查询节点
首先需创建一个NodeMatcher对象,利用match指定要匹配的label类型,并通过where设定筛选条件(支持两种写法)。需要注意的是,匹配成功返回的是NodeMatcher对象,需转换为Node对象,可通过first方法获取符合条件的第一个节点,或转换为节点列表。
>>>node_matcher = NodeMatcher(graph)
>>>node = node_matcher.match("Person").where(age=20).first()
>>>node
Node('Person', age=20, name='李李', work='本站')
>>>nodes = list(node_matcher.match("Person").where(age=35))
>>>nodes
[Node('Person', age=35, name='王王', work='本站')]
where条件存在两种写法,一种是将待匹配的属性和值以key=value形式书写,例如上述的where(age=20),此种写法仅能依据值是否完全一致进行匹配,无法依据值的大小进行筛选,若写成如下形式将会报错:
node = node_matcher.match("Person").where(age>20).first() # 错误 若需依据值的大小筛选或进行字符串模糊匹配,可将条件表达式写为字符串并整体置于where语句中,在该字符串中可使用 _ 代指匹配到的节点。以下两个示例,第一个用于匹配work属性符合“月亮XX”模式的Person节点,第二个用于匹配age大于20的Person节点。
>>>node = node_matcher.match("Person").where("_.work =~ '月亮.*'").first()
>>>node
Node('Person', 'Teacher', age=45, name='赵赵', work='月亮中学')
>>>nodes = list(node_matcher.match("Person").where("_.age > 20"))
>>>nodes
[Node('Person', age=35, name='王王', work='本站'),
 Node('Person', age=30, name='张张', work='本站'),
 Node('Person', 'Teacher', age=45, name='赵赵', work='月亮中学')]
将NodeMatcher返回的结果转换为Node数据类型或Node列表后,访问其属性变得十分简便,例如上述最后一个示例的结果,访问其中第一个节点的name属性:
>>>nodes[0]['name']
'王王'
四、 使用RelationshipMatcher查询关系
RelationshipMatcher的match方法包含三个及以上参数:
- 第一个参数为节点序列或set,可为None,为None时表示任意节点均可;
- 第二个参数为关系类型,可为None,为None时表示任意类型的关系均可;
- 从第三个参数开始为待匹配的属性,需写成key=value的形式。
match方法的返回值为RelationshipMatcher类型,需通过first转换为Relationship数据结构,或转换为list。
举例说明:
例1:例如想要查询“李李”节点的所有关系。先查询出该节点,再查询其关系,其中r_type=None表示任意类型的关系均可。返回的关系包括到访、同事。
>>>node1 = node_matcher.match("Person").where(name='李李').first()
>>>relationship = list(relationship_matcher.match([node1], r_type=None))
>>>relationship
[到访(Node('Person', age=20, name='李李', work='本站'), Node('Location', name='禄口机场'), date='2021/7/16', stay_hours=1),
 同事(Node('Person', age=20, name='李李', work='本站'), Node('Person', age=30, name='张张', work='本站')),
 同事(Node('Person', age=20, name='李李', work='本站'), Node('Person', age=35, name='王王', work='本站'))]
例2:查询“李李”和“张张”的关系,两个节点的顺序表示了要匹配的关系的方向。因此在整个图中“李李”和“张张”节点之间的同事关系是双向的,但是查询结果只给出了从“张张”节点到“李李”节点的一条关系。
>>>node1 = node_matcher.match("Person").where(name='李李').first()
>>>node2 = node_matcher.match("Person").where(name='张张').first()
>>>relationship = list(relationship_matcher.match((node2,node1), r_type=None))
>>>relationship
[同事(Node('Person', age=30, name='张张', work='本站'), Node('Person', age=20, name='李李', work='本站'))]
例3:查询图中某一类关系,第一个参数为None,第二个参数r_type指定关系类型,这里查询了图中所有的同事关系。
>>>relationship = list(relationship_matcher.match(None, r_type='同事'))
>>>relationship
[同事(Node('Person', age=20, name='李李', work='本站'), Node('Person', age=30, name='张张', work='本站')),
 同事(Node('Person', age=20, name='李李', work='本站'), Node('Person', age=35, name='王王', work='本站')),
 同事(Node('Person', age=35, name='王王', work='本站'), Node('Person', age=20, name='李李', work='本站')),
 同事(Node('Person', age=30, name='张张', work='本站'), Node('Person', age=20, name='李李', work='本站'))]
例4: 在查询关系时按照属性的值筛选,可以将该属性写为key=value的形式作为match方法的第三个参数。这里,查询图中的到访关系,并且stay_hours属性为1。
>>>relationship = list(relationship_matcher.match(None, r_type='到访', stay_hours=1))
>>>relationship
[到访(Node('Person', age=20, name='李李', work='本站'), Node('Location', name='禄口机场'), date='2021/8/24', stay_hours=1)]
虽然Py2neo的手册上没有写,但其实RelationshipMatcher也可以接上where方法,按照属性的值筛选关系。上面这个例子也可以写作下面这种形式,效果是一样的。
relationship = list(relationship_matcher.match(None, r_type='到访').where(stay_hours=1)) 同样,在where方法中也可以写一个字符串表达式,实现按值大小来筛选关系。例如要筛选出所有到访关系,且stay_hours>=1的关系时,可以这样写:
>>>relationship = list(relationship_matcher.match(None, r_type='到访').where("_.stay_hours>=1"))
>>>relationship
[到访(Node('Person', age=20, name='李李', work='本站'), Node('Location', name='禄口机场'), date='2021/8/24', stay_hours=1),
 到访(Node('Person', age=20, name='刘刘', work='地球电子商务公司'), Node('Location', name='禄口机场'), date='2021/8/24', stay_hours=4)]
如何访问返回的结果中的各个属性呢,Relationship其实是包含了一对起止节点:start_node和end_node,包含了关系的类型,而关系的属性是以字典形式存在的,可以用get方法来获取属性的值。 获取关系的起止节点:
>>>print(relationship[0].start_node['name'])
>>>print(relationship[0].end_node['name'])
李李
禄口机场
获取关系的类型的文本字符串
>>>print(relationship[0])
>>>print(type(relationship[0]).__name__)
(李李)-[:到访 {date: '2021/8/24', stay_hours: 1}]->(禄口机场)
到访
获取关系中的属性和值
>>>print(relationship[0].keys())
>>>print(relationship[0].values())
>>>print(relationship[0].get('date'))
dict_keys(['date', 'stay_hours'])
dict_values(['2021/8/24', 1])
2021/8/24
五、通过执行Cypher语句查询
NodeMatcher和RelationshipMatcher能够表达的匹配条件相对简单,更加复杂的查询还是需要用Cypher语句来表达。Py2neo本身支持执行Cypher语句的执行,可以将复杂的查询写成Cypher语句,通过graph.run方法查询,返回的结果可以转化为pandas.DataFrame或者pandas.Series对象,从而和其他数据分析工具无缝衔接。
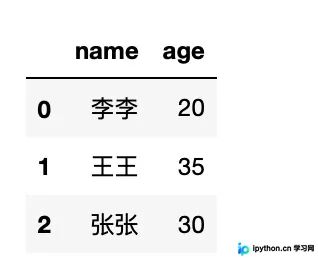
例如:要查询Person节点,并满足work属性为“本站”。Cypher语句中可以使用WHERE接条件表达式,使用AS将返回的属性改名,返回多个属性时,用xxx AS x, yyy AS y。graph.run方法之后再接to_data_frame()可以将返回的数据变成pandas的DataFrame对象,并且用AS改过的属性名即为DataFrame中的列名。
cypher_ = "MATCH (n:Person) \
WHERE n.work='本站' \
RETURN n.name AS name, n.age AS age "

df = graph.run(cypher_).to_data_frame() # pd.DataFrame
例2:查询一个已知节点和其他哪些节点有关系,有什么样的关系。Cypher语言查询关系时用 < 或者 > 表示方向,这里需要返回type(r),直接返回r的话结果里是空值。
>>>cypher_ = "MATCH (n:Person)-[r]->(m:Person) \
WHERE n.name='李李' \
RETURN type(r) AS type,m.name AS name"
>>>df = graph.run(cypher_).to_data_frame() # pd.DataFrame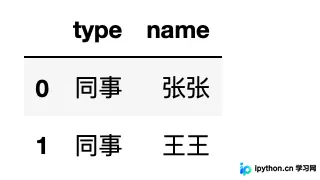
例3:Cypher语言还可以查询路径,因为不确定返回的路径数量,所以最好先将结果转化为pandas.Series,再遍历访问其中每条路径的节点和关系。 这里查询的是“赵赵”节点和“王王”节点之间的关系路径,关系指定为同事或邻居,关系不超过4层。
>>>cypher_ = "MATCH path=(m:Person)-[:同事|邻居*1..4]->(n:Person) \
WHERE m.name='赵赵' AND n.name='王王' \
RETURN path"
>>>s = graph.run(cypher_).to_series()
>>>print(len(s))
>>>s[0]

Path(Node('Person', 'Teacher', age=45, name='赵赵', work='月亮中学'),
邻居(Node('Person', 'Teacher', age=45, name='赵赵', work='月亮中学'),
Node('Person', age=30, name='张张', work='本站')),
同事(Node('Person', age=30, name='张张', work='本站'),
Node('Person', age=20, name='李李', work='本站')),
同事(Node('Person', age=20, name='李李', work='本站'),
Node('Person', age=35, name='王王', work='本站')))
这里查询到的关系路径数量仅有1条。从上图的结果中也可以看出来,Path是一个比较复杂的结构,Path中的节点和关系分别用nodes和relationships表示,并且是按照路径上节点和关系的顺序分别存放的。这里给出一段示例代码,对每一个路径都做了直接打印path数据结构和自己组织路径文本。
for path in s:
    # 直接打印path
    print(path)
    # 获取路径中的节点和关系
    nodes = path.nodes
    relationshis = path.relationships
    # 自己组织路径文本
    path_text = ""
    for n,r in zip(nodes, relationshis):
        # 每次加入一个节点和一个关系的类型
        path_text += "{} - {} - ".format(n['name'], type(r).__name__)
    # 别忘了最后一个节点
    path_text += nodes[-1]['name'] + '\n'
    print(path_text)
运行这段代码得的结果如下所示,上面一行是直接打印路径的结果,下面一行是自己组织文本得到的结果。
(赵赵)-[:邻居 {}]->(张张)-[:同事 {}]->(李李)-[:同事 {}]->(王王)
赵赵 - 邻居 - 张张 - 同事 - 李李 - 同事 - 王王
使用Py2neo查询Neo4j中的节点、关系和路径时,条件简单的查询可以通NodeMatcher和RelationshipMatcher来实现。而较为复杂的查询,可以写成Cypher语句来查询,查询结果可以转化为pandas的DataFrame或者Series数据类型,与其他数据分析工具结合
以上就是python使用py2neo查询Neo4j的节点、关系及路径的详细内容,更多关于python py2neo的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









