

Python threading库线程同步机制详解:锁、条件变量与屏障

本文深入解析Python threading库中的核心同步机制。从基础的Lock锁获取与释放,到非阻塞尝试、with语句简化用法,详细讲解RLock递归锁。进一步介绍Condition条件变量实现生产者-消费者模型,Barrier屏障同步多线程执行点,以及Semaphore信号量控制并发访问数量。最后探讨threading.local隐藏线程局部数据,确保多线程环境下的数据安全与高效协作。
控制资源访问
在前文讨论中,我们指出多线程环境下对同一资源的并发访问极易引发数据破坏或丢失。为确保资源访问的安全性,必须引入锁机制来保护共享资源对象。
具体实现示例如下:
import threading
import time

class AddThread():
    def __init__(self, start=0):
        self.lock = threading.Lock()
        self.value = start

    def increment(self):
        print("Wait Lock")
        self.lock.acquire()
        try:
            print("Acquire Lock")
            self.value += 1
            print(self.value)
        finally:
            self.lock.release()

def worker(a):
    time.sleep(1)
    a.increment()

addThread = AddThread()
for i in range(3):
    t = threading.Thread(target=worker, args=(addThread,))
    t.start()
运行上述代码后,输出效果如下:
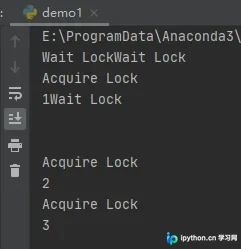
通过调用acquire()方法,锁会阻塞其他线程执行中间代码段;而release()则用于释放锁。从运行结果可见,线程在成功获取锁后才会执行后续操作,从而有效避免了多个线程同时修改资源对象导致的混乱状态。
判断是否有另一个线程请求锁
若需确定是否有其他线程正在请求锁,且不希望当前线程阻塞,可将acquire()方法的blocking参数设置为False。
示例代码如下:
import threading
import time

def worker2(lock):
    print("worker2 Wait Lock")
    while True:
        lock.acquire()
        try:
            print("Holding")
            time.sleep(0.5)
        finally:
            print("not Holding")
            lock.release()
        time.sleep(0.5)

def worker1(lock):
    print("worker1 Wait Lock")
    num_acquire = 0
    value = 0
    while num_acquire < 3:
        time.sleep(0.5)
        have_it = lock.acquire(blocking=False)
        try:
            value += 1
            print(value)
            print("Acquire Lock")
            if have_it:
                num_acquire += 1
        finally:
            print("release Lock")
            if have_it:
                lock.release()

lock = threading.Lock()
word2Thread = threading.Thread(
    target=worker2,
    name='work2',
    args=(lock,)
)
word2Thread.start()
word1Thread = threading.Thread(
    target=worker1,
    name='work1',
    args=(lock,)
)
word1Thread.start()
运行后的效果如下:
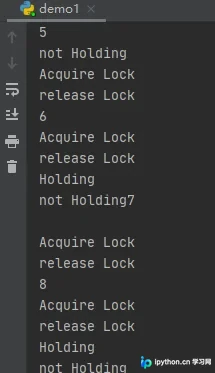
在此示例中,worker1线程需要迭代多次才能成功获取3次锁,但尝试次数达到了8次。
with lock
前文演示了通过lock.acquire()和lock.release()手动获取与释放锁的方式。实际上,Python提供了更简洁的语法,即使用with lock语句来自动处理锁的获取与释放。
示例代码如下:
import threading
import time

class AddThread():
    def __init__(self, start=0):
        self.lock = threading.Lock()
        self.value = start

    def increment(self):
        print("Wait Lock")
        with self.lock:
            print("lock acquire")
            self.value += 1
            print(self.value)
        print("lock release")

def worker(a):
    time.sleep(1)
    a.increment()

addThread = AddThread()
for i in range(3):
    t = threading.Thread(target=worker, args=(addThread,))
    t.start()
此处仅对前述示例进行了简化改写,运行效果如下:
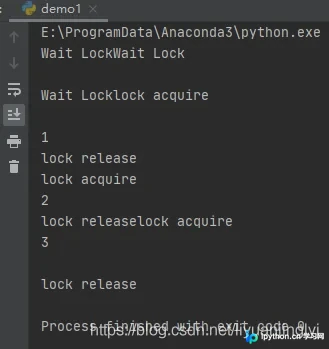
需要注意的是,标准的Lock对象不支持重入,即使由同一线程多次请求也会失败。若同一调用链中的多个函数需访问同一锁,可能引发意外行为。若期望同一线程在不同代码段中重新获得锁,应使用RLock(可重入锁)。
同步线程
Condition
在实际操作中,还可利用Condition对象实现线程同步。由于Condition内部封装了一个Lock,它可以绑定到共享资源,允许多个线程等待资源更新。
示例代码如下:
import threading
import time

def consumer(cond):
    print("waitCon")
    with cond:
        cond.wait()
        print('获取更新的资源')

def producer(cond):
    print("worker")
    with cond:
        print('更新资源')
        cond.notifyAll()

cond = threading.Condition()
t1 = threading.Thread(name='t1', target=consumer, args=(cond,))
t2 = threading.Thread(name='t2', target=consumer, args=(cond,))
t3 = threading.Thread(name='t3', target=producer, args=(cond,))
t1.start()
time.sleep(0.2)
t2.start()
time.sleep(0.2)
t3.start()
运行后的效果如下:
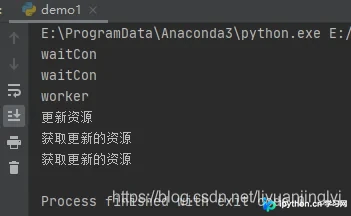
在此场景中,producer线程处理完成后调用notifyAll(),使得等待的consumer线程得以继续执行,这类似于观察者模式。当一个线程完成资源使用后,会自动通知所有依赖该资源的线程。
屏障(barrier)
屏障是另一种线程同步机制。barrier会建立一个控制点,所有参与的线程在此处阻塞,直到所有参与方均到达该点。通过这种方式,线程可以单独启动并暂停,直至所有线程准备就绪后继续执行。
示例代码如下:
import threading
import time

def worker(barrier):
    print(threading.current_thread().getName(), "worker")
    worker_id = barrier.wait()
    print(threading.current_thread().getName(), worker_id)

threads = []
barrier = threading.Barrier(3)
for i in range(3):
    threads.append(
        threading.Thread(
            name="t" + str(i),
            target=worker,
            args=(barrier,)
        )
    )
for t in threads:
    print(t.name, 'starting')
    t.start()
    time.sleep(0.1)

for t in threads:
    t.join()
运行后的效果如下:
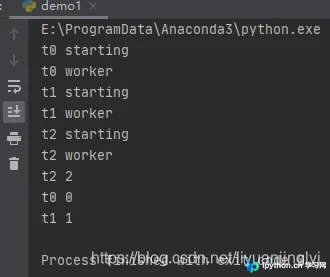
从控制台输出可见,barrier.wait()会阻塞线程,直到所有线程创建完毕后,才同时释放并越过该控制点继续执行。wait()的返回值指示了释放的参与线程数,可用于限制部分线程执行资源清理等操作。
此外,Barrier还提供abort()方法,该方法可使所有等待线程接收BrokenBarrierError异常。若线程在wait()上被阻塞而停止处理,将产生此异常,可通过except块完成清理工作。
有限资源的并发访问
除了多线程可能访问同一资源外,有时为了性能考虑,需限制同时访问同一资源的线程数量。例如,线程池支持同时连接,但数据可能是固定的,或者一个网络APP提供的并发下载数支持固定数目。这些连接可以使用Semaphore进行管理。
示例代码如下:
import threading
import time

class WorkerThread(threading.Thread):
    def __init__(self):
        super(WorkerThread, self).__init__()
        self.lock = threading.Lock()
        self.value = 0

    def increment(self):
        with self.lock:
            self.value += 1
            print(self.value)

def worker(s, pool):
    with s:
        print(threading.current_thread().getName())
        pool.increment()
        time.sleep(1)
        pool.increment()

pool = WorkerThread()
s = threading.Semaphore(2)
for i in range(5):
    t = threading.Thread(
        name="t" + str(i),
        target=worker,
        args=(s, pool,)
    )
    t.start()
运行后的效果如下:
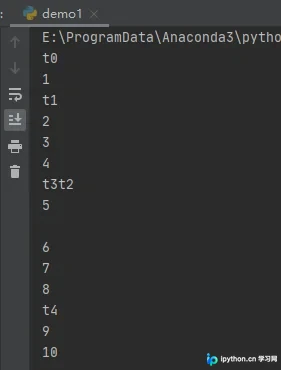
虽然从图片中能看到所有输出,但无法直观看到停顿的时间点。读者自行运行会发现,每次最多只有两个线程在工作,这是因为我们设置了threading.Semaphore(2)。
隐藏资源
在实际项目中,有些资源需要锁定以便多个线程使用,而另一些资源则需要保护,使其对非所有者线程隐藏。
local()函数会创建一个对象,它能够隐藏值,使其在不同的线程中无法被看到。示例代码如下:
import threading
import random

def show_data(data):
    try:
        result = data.value
    except AttributeError:
        print(threading.current_thread().getName(), "No value")
    else:
        print(threading.current_thread().getName(), "value=", result)

def worker(data):
    show_data(data)
    data.value = random.randint(1, 100)
    show_data(data)

local_data = threading.local()
show_data(local_data)
local_data.value = 1000
show_data(local_data)

for i in range(2):
    t = threading.Thread(
        name="t" + str(i),
        target=worker,
        args=(local_data,)
    )
    t.start()
运行后的效果如下:
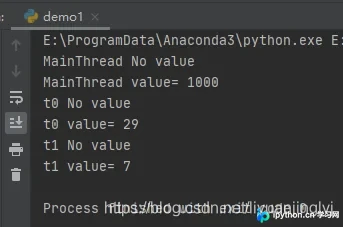
此处local_data.value对所有线程都不可见,除非在某个线程中设置了这个属性,该线程才能看到它。
到此这篇关于Python中threading库实现线程锁与释放锁的文章就介绍到这了,更多相关Python 线程锁与释放锁内容请搜索本站以前的文章或继续浏览下面的相关文章希望大家以后多多支持本站!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









