

Python3中os.popen()处理中文文件名报错的解决方案

发布时间:2026-10-14| 6人浏览过
本文分析Python3中使用os.popen()执行shell命令时,因返回结果包含中文字符而触发UnicodeDecodeError的问题。通过对比os.listdir()与os.popen()的输出差异,指出默认编码处理机制的不同,并推荐使用subprocess模块作为更稳健的替代方案来解决该编码报错。
在编写程序时,遇到错误是常态。从大量代码中定位问题既考验技术能力,也考验耐心。当精心编写的代码无法运行或结果不符预期时,产生焦虑情绪是可以理解的。针对Python3环境下使用os.popen()出现的异常,本文将通过复现错误操作来解析原因,并寻找正确的解决路径。
环境复现与问题现象
假设当前desktop目录下存在以下文件列表:
desktop $ls
client.py  server.py  中文测试
arcpy.txt  codetest.py  test.py
如上图所示,目录中包含一个名为“中文测试”的文件。
# -*- coding:utf-8 -*-
# python3.5.1
import os,sys
print (sys.getdefaultencoding()) #系统默认编码
dir_list = os.listdir()
for li in dir_list:
print (li)
执行相关命令后的输出结果如下:
utf-8
arcpy.txt
client.py
codetest.py
server.py
test.py
中文测试
从输出可见,系统默认编码为utf-8,此时使用os.listdir()命令能够正常列出并显示中文字符。
然而,当尝试使用os.popen()执行相同操作时:
# -*- coding:utf-8 -*-
# python3.5.1
import os,sys
print (sys.getdefaultencoding()) #系统默认编码
dir_list = os.popen('ls','r').read()
for li in dir_list:
print (li)
程序抛出如下错误信息:
utf-8

Traceback (most recent call last):

File "Desktop/codetest.py", line 8, in <module>

dir_list = os.popen('ls','r').read()

File "/Library/Frameworks/Python.framework/Versions/3.5/lib/python3.5/encodings/ascii.py", line 26, in decode

return codecs.ascii_decode(input, self.errors)[0]

UnicodeDecodeError: 'ascii' codec can't decode byte 0xe4 in position 76: ordinal not in range(128)
解决方案与建议
解决方法如下:
直接在命令行中执行该命令并无问题,此报错主要源于编辑器或Python3内部对os.popen()返回值的解码机制。建议改用subprocess模块来执行外部命令,以避免此类编码冲突。
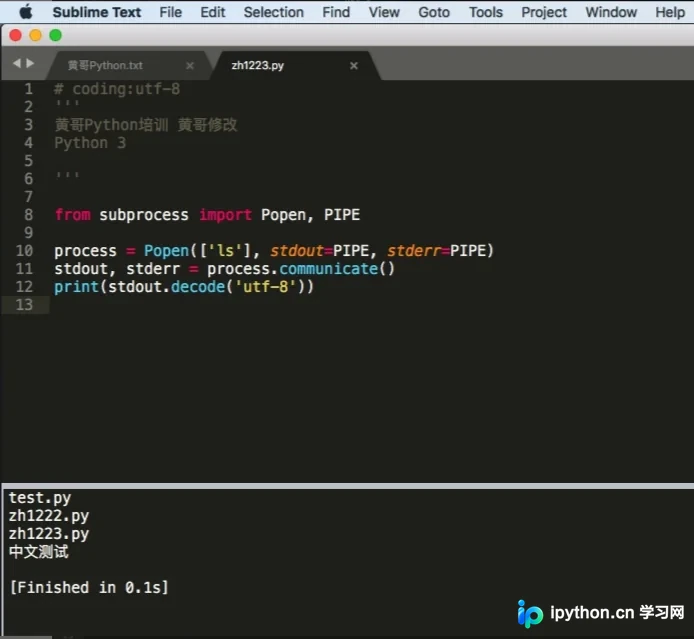
至此,关于Python3中os.popen()处理中文内容报错的问题已介绍完毕。如需了解更多Python3相关使用技巧,可查阅本站历史文章或继续浏览后续内容,感谢支持!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









