

Python实现七大基础排序与查找算法详解

本文详细解析Python中七大基础算法的实现原理与代码。涵盖顺序查找与二分查找的逻辑差异,以及冒泡、选择、插入、希尔、快速和归并排序的核心机制。通过具体代码示例,展示各算法的操作步骤、参数处理及时间复杂度特性,帮助开发者深入理解数据结构与算法基础。
顺序查找与二分查找实现
1. 顺序查找
当数据以列表等集合形式存储时,元素之间呈现线性或顺序关系,每个元素的位置由索引决定。基于这种有序索引,我们可以按顺序逐个访问元素,这种搜索方式即为顺序查找。
顺序查找的执行过程是从列表首元素开始,依次向后移动并比对,直至找到目标元素或遍历完整个列表。若遍历结束仍未找到,则判定该元素不存在。
代码实现方面,该函数接收列表和目标元素作为参数,返回布尔值表示是否存在。初始化标志变量 found 为 False,一旦在列表中找到匹配元素,将其设为 True 并返回。
def search(alist,item):
 find = False
 cur = 0
 while cur < len(alist):
 if alist[cur] == item:
  find = True
  break
 else:
  cur += 1
 return find
2. 二分查找
有序列表能显著提升搜索效率。在顺序查找中,若首元素不匹配,剩余需比较的元素最多为 n-1 个。
二分查找从列表中间元素入手。若中间元素即为目标,则查找结束;若非目标,利用列表的有序性,可排除另一半元素。
若目标值大于中间元素,则排除中间元素及其左侧较小的一半,目标必存在于右侧较大的一半中。随后在右侧子序列中重复此过程,继续选取中间元素进行比对,直至找到目标或子序列为空。
def search(alist,item):
 left = 0
 right = len(alist) - 1
 find = False

 while left <= right:
 mid_index = (left + right)//2
 if item == alist[mid_index]:
  find = True
  break
 else:
  if item > alist[mid_index]:
  left = mid_index + 1
  else:
  right = mid_index -1

 return find
冒泡排序与选择排序逻辑
3. 冒泡排序
原理:
比较相邻的两个元素,若前者大于后者则交换位置。对每一对相邻元素重复此操作,从第一对直到最后一对,此时末尾元素应为最大值。对所有元素(除最后一个外)重复上述步骤,每次处理的元素范围逐渐缩小,直到无需再比较为止。
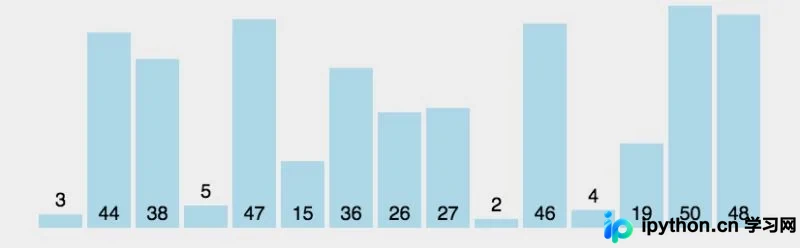
def sort(alist):
 length = len(alist)
 for i in range(0,length-1):
  for j in range(0,length-1-i):
  if alist[i] > alist[i+1]:
   alist[i],alist[i+1] = alist[i+1],alist[i]
4. 选择排序
工作原理:从未排序序列中选出最小(或最大)元素,放置到已排序序列的起始位置。接着从剩余未排序元素中继续寻找最小(大)元素,放到已排序序列末尾。重复此过程,直至所有元素排序完毕。选择排序属于不稳定排序算法。
def sort(alist):
 length = len(alist)
 for j in range(length-1,0,-1):
 max_index = 0
 for i in range(1,j+1):
  if alist[max_index] < alist[i]:
  max_index = i
 alist[max_index],alist[j] = alist[j],alist[max_index]
插入排序与希尔排序解析
5. 插入排序
原理:
基本思想是将待排序记录按其关键码值插入到前面已排序文件的适当位置,直到全部插入完成。关键码是数据元素中用于标识元素的某个数据项的值。
def sort(alist):
 length = len(alist)
 for j in range(1,length):
 i = j
 while i > 0:
  if alist[i] < alist[i-1]:
  alist[i],alist[i-1] = alist[i-1],alist[i]
  i -= 1
  else:
  break
希尔排序(Shell's Sort)又称“缩小增量排序”(Diminishing Increment Sort),是直接插入排序的高效改进版,属于非稳定排序算法。
该方法先将待排序列分割为若干子序列(由相隔特定“增量 gap”的元素组成),分别进行直接插入排序;随后逐步缩减增量并再次排序。当整个序列元素基本有序(增量足够小)时,再对全体元素进行一次直接插入排序。由于直接插入排序在元素基本有序时效率极高,因此希尔排序的时间效率优于直接插入排序。
def sort(alist):
 gap = len(alist)//2
 while gap >= 1:
 for j in range(gap,len(alist)):
  i = j
  while i > 0:
  if alist[i] < alist[i-gap]:
   alist[i],alist[i-gap] = alist[i-gap],alist[i]
   i -= gap
  else:
   break
 gap = gap // 2
快速排序与归并排序代码
6. 快速排序
基本思想:通过一趟排序将待排数据分割为独立的两部分,其中一部分的所有数据均小于另一部分的所有数据。随后对这两部分数据分别递归执行快速排序,从而使整个数据序列变为有序。
def sort(alist,start,end):
 low = start
 high = end
 if low >= high:
 return
 mid = alist[low]
 while low < high:
 while low < high:
  if alist[high] >= mid:
  high -= 1
  else:
  alist[low] = alist[high]
  break
 while low < high:
  if alist[low] < mid:
  low += 1
  else:
  alist[high] = alist[low]
  break
 alist[low] = mid
 sort(alist,start,low-1)
 sort(alist,high+1,end)
7. 归并排序
归并排序(MERGE-SORT)是一种基于归并操作的有效排序算法,典型应用了分治法(Divide and Conquer)。其核心是将已有序的子序列合并,生成完全有序的序列;即先使每个子序列有序,再使子序列段间有序。
def merge_sort(alist):
 n = len(alist)
 #结束递归的条件
 if n <= 1:
 return alist
 #中间索引
 mid = n//2

 left_li = merge_sort(alist[:mid])
 right_li = merge_sort(alist[mid:])

 #指向左右表中第一个元素的指针
 left_pointer,right_pointer = 0,0
 #合并数据对应的列表:该表中存储的为排序后的数据
 result = []
 while left_pointer < len(left_li) and right_pointer < len(right_li):
 #比较最小集合中的元素,将最小元素添加到result列表中
 if left_li[left_pointer] < right_li[right_pointer]:
  result.append(left_li[left_pointer])
  left_pointer += 1
 else:
  result.append(right_li[right_pointer])
  right_pointer += 1
 #当左右表的某一个表的指针偏移到末尾的时候,比较大小结束,将另一张表中的数据(有序)添加到result中
 result += left_li[left_pointer:]
 result += right_li[right_pointer:]

 return result

alist = [3,8,5,7,6]
print(merge_sort(alist))
算法时间复杂度总结
8. 各个算法的时间复杂度
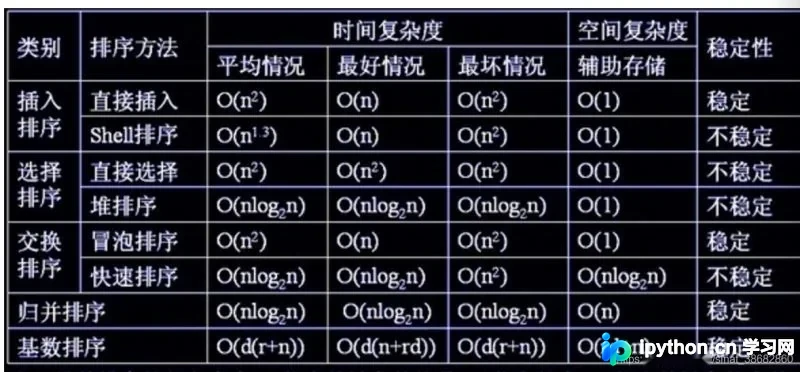
至此,关于Python实现七个基本算法的实例代码介绍完毕。如需了解更多Python基本算法内容,请搜索本站往期文章或继续浏览相关文章,感谢支持!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









