

Python中map与for循环性能对比:何时该用哪种?

本文通过实验对比Python中map、for循环和列表解析的性能。结果显示:若无需返回值,标准for循环最快;若需返回结果,列表解析优于map和for。map在大数据量下优势不明显,甚至可能更慢。建议根据是否需返回值选择合适方式,避免盲目使用map。
实验结论与核心建议
实验结论
- 若循环结束后需要获取处理结果,推荐优先使用列表解析;
- 若无需获取结果,直接使用标准for循环即可,列表解析可作为备选方案;
- 除非为了代码简洁或遵循特定编码规范,否则不建议使用map函数;
无需返回结果时的性能对比
当不需要返回处理结果时
本实验设置了三个处理过程(process),每个过程通过增加内部循环次数来提升时间复杂度;
	def process1(val, type=None):
	 chr(val % 123)

	def process2(val, type):
	 if type == "list":
	  [process1(_) for _ in range(val)]
	 elif type == "for":
	  for _ in range(val):
	   process1(_)
	 elif type == "map":
	  list(map(lambda _: process1(_), range(val)))

	def process3(val, type):
	 if type == "list":
	  [process2(_, type) for _ in range(val)]
	 elif type == "for":
	  for _ in range(val):
	   process2(_, type)
	 elif type == "map":
	  list(map(lambda _: process2(_, type), range(val)))
随后分别使用三种迭代方式依次执行上述三个处理任务;
	def list_comp():
	 [process1(i, "list") for i in range(length)]
	 # [process2(i, "list") for i in range(length)]
	 # [process3(i, "list") for i in range(length)]

	def for_loop():
	 for i in range(length):
	  process1(i, "for")
	  # process2(i, "for")
	  # process3(i, "for")

	def map_exp():
	 list(map(lambda v: process1(v, "map"), range(length)))
	 # list(map(lambda v: process2(v, "map"), range(length)))
	 # list(map(lambda v: process3(v, "map"), range(length)))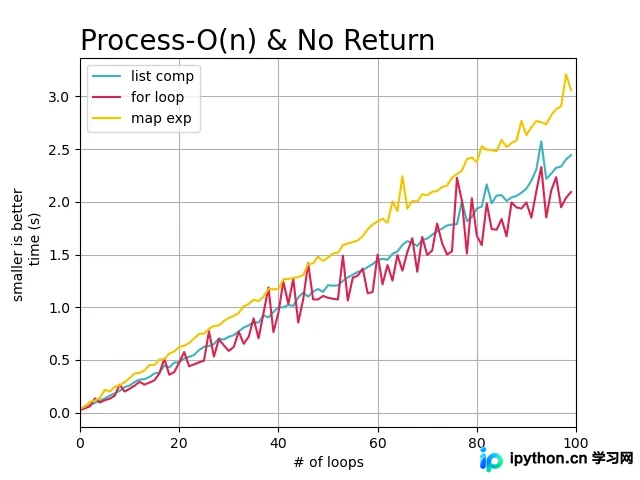
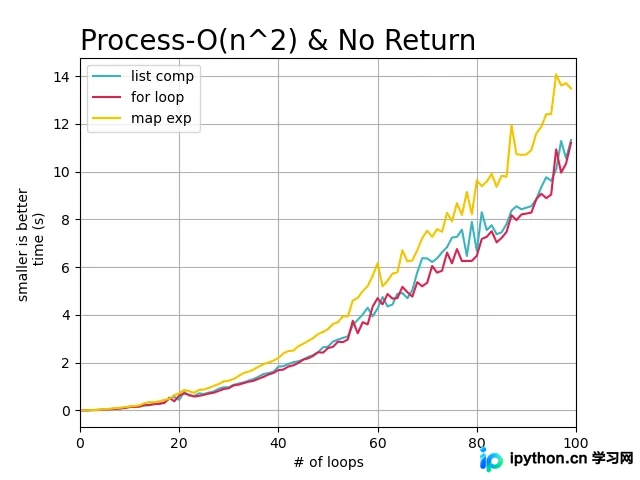
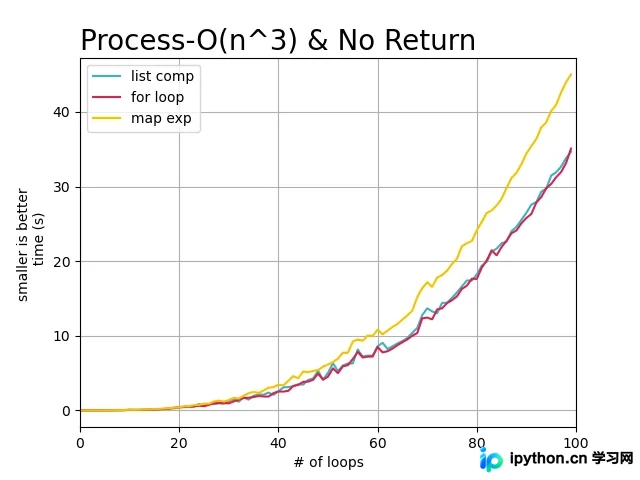
从上述图像中可以直观看出,随着任务复杂度的提升以及数据量的增加,每种循环方式完成所需的时间均呈上升趋势。然而,map方式所耗费的时间明显高于其他两种实现方式。因此,在无需返回处理结果的前提下,选择标准for循环或列表解析均可接受。
在任务复杂度逐步递增的情况下,标准for循环与列表解析的执行时间基本保持一致,无明显差异。
需要返回结果时的性能对比
当需要返回处理结果时
本实验设置了三个任务(task),每个任务通过增加内部循环次数来提升时间复杂度;
	def task1(val, type=None):
	 return chr(val % 123)

	def task2(val, type):
	 if type == "list":
	  return [task1(_) for _ in range(val)]
	 elif type == "for":
	  res = list()
	  for _ in range(val):
	   res.append(task1(_))
	  return res
	 elif type == "map":
	  return list(map(lambda _: task1(_), range(val)))

	def task3(val, type):
	 if type == "list":
	  return [task2(_, type) for _ in range(val)]
	 elif type == "for":
	  res = list()
	  for _ in range(val):
	   res.append(task2(_, type))
	  return res
	 elif type == "map":
	  return list(map(lambda _: task2(_, type), range(val)))
随后分别使用三种迭代方式依次执行上述三个任务;
	def list_comp():
	 # return [task1(i, "list") for i in range(length)]
	 return [task2(i, "list") for i in range(length)]
	 # return [task3(i, "list") for i in range(length)]

	def for_loop():
	 res = list()
	 for i in range(length):
	  # res.append(task1(i, "for"))
	  res.append(task2(i, "for"))
	  # res.append(task3(i, "for"))
	 return res

	def map_exp():
	 # return list(map(lambda v: task1(v, "map"), range(length)))
	 return list(map(lambda v: task2(v, "map"), range(length)))
	 # return list(map(lambda v: task3(v, "map"), range(length)))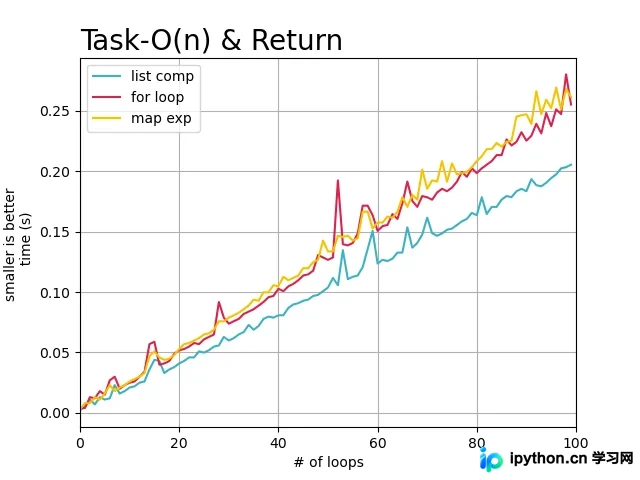
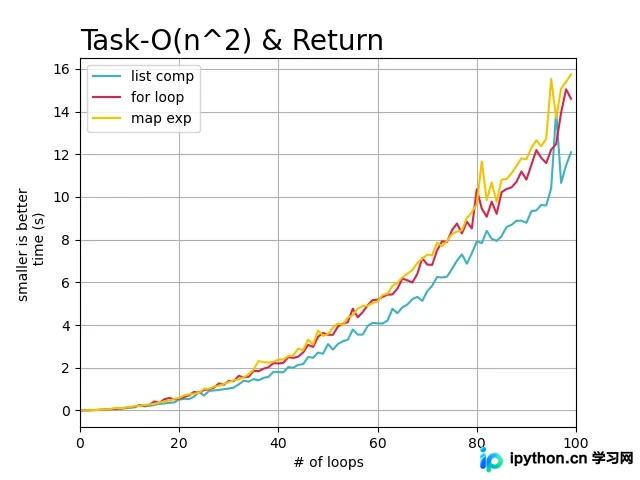
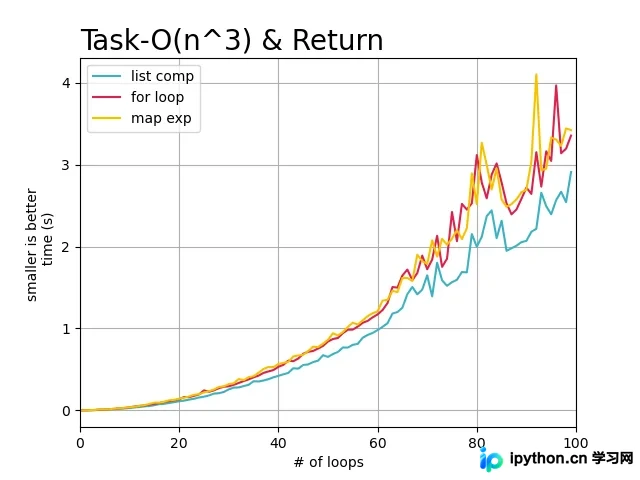
从上述图像中可以直观看出,随着任务复杂度的提升以及数据量的增加,每种循环方式完成所需的时间均呈上升趋势。但明显可见,使用列表解析(list_comp)在每次需要返回处理结果的任务中表现优异,其速度基本快于其他两种迭代方式。
在任务复杂度逐步递增的情况下,标准for循环与map方式的执行时间基本保持一致,无明显差异。
map性能优势的常见误解
为何普遍认为map比for循环更快?
这可能与测试所用数据量有关。在多数场景中,使用者仅测试了较小规模的数据(例如100万以下,如本文所涉案例,因数据量较小导致速度差异不显著)。在少量数据集下,确实观察到map方式比for循环更快,有时甚至略快于列表解析。然而,当数据量扩大至原来的100倍时,差距便凸显出来。
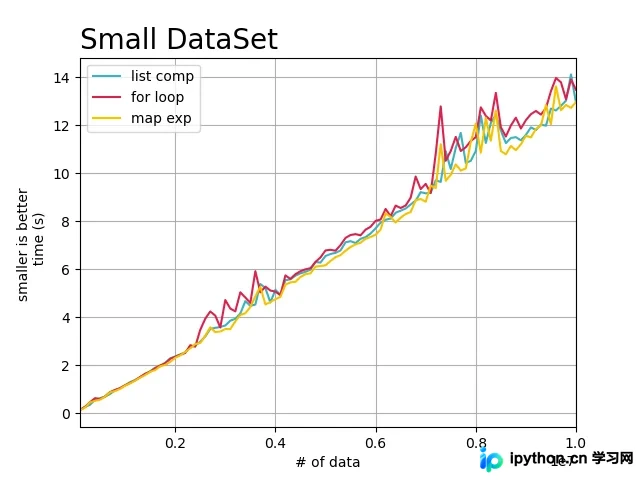
如上图所示,在较小数据集范围(100万至1000万之间),三者耗时大致相当,但使用map方式进行遍历和处理仍具备一定加速优势。具体实验代码可通过GitHub获取。
以上为Python中map与for循环性能对比的详细内容,更多关于Python中map和for循环的资料,敬请关注本站其他相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









