

Python实现K-means客户分群:从数据可视化到手肘法确定最佳K值

本文详细介绍使用Python进行超市客户分群的完整流程。通过数据清洗与可视化(平行坐标、分布图、箱线图)探索特征,利用手肘法确定最佳聚类数K。分别基于年龄与消费分、年收入与消费分、以及三者组合进行K-means聚类,最终将客户划分为高价值、普通、高消费、节俭及谨慎等群体,为精准营销提供数据支持。
项目背景与数据描述
一、背景
1.项目描述
- 假设你经营着一家大型商场(Supermarket Mall)。借助会员卡系统,你掌握了一系列客户的基本信息,包括客户ID、年龄、性别、年收入以及消费分数。
- 其中,消费分数是依据客户的过往行为和购买记录等数据计算得出的一个参数。
- 核心问题:作为商场管理者,你需要识别出哪些客户群体具有相似特征,从而能够被有效聚集。这一目标旨在为营销团队提供灵感,以便制定并执行相应的营销策略。
2.数据描述
| 字段名 | 描述 |
|---|---|
| CustomerID | 客户编号 |
| Gender | 性别 |
| Age | 年龄 |
| Annual Income (k$) | 年收入,单位为千美元 |
| Spending Score (1-100) | 消费分数,范围在1~100 |
二、相关模块
import numpy as np
import pandas as pd
from pandas import plotting
import matplotlib.pyplot as plt
import seaborn as sns
import plotly.graph_objs as go
import plotly.offline as py
from sklearn.cluster import KMeans
import warnings
warnings.filterwarnings('ignore')
数据可视化分析
三、数据可视化
1.数据读取
io = '.../Mall_Customers.csv'
df = pd.DataFrame(pd.read_csv(io))
# 修改列名
df.rename(columns={'Annual Income (k$)': 'Annual Income', 'Spending Score (1-100)': 'Spending Score'}, inplace=True)
print(df.head())
print(df.describe())
print(df.shape)
print(df.count())
print(df.dtypes)
运行代码后,输出结果如下所示。
CustomerID Gender Age Annual Income Spending Score 0 1 Male 19 15 39 1 2 Male 21 15 81 2 3 Female 20 16 6 3 4 Female 23 16 77 4 5 Female 31 17 40 ----------------------------------------------------------------- CustomerID Age Annual Income Spending Score count 200.000000 200.000000 200.000000 200.000000 mean 100.500000 38.850000 60.560000 50.200000 std 57.879185 13.969007 26.264721 25.823522 min 1.000000 18.000000 15.000000 1.000000 25% 50.750000 28.750000 41.500000 34.750000 50% 100.500000 36.000000 61.500000 50.000000 75% 150.250000 49.000000 78.000000 73.000000 max 200.000000 70.000000 137.000000 99.000000 ----------------------------------------------------------------- (200, 5) CustomerID 200 Gender 200 Age 200 Annual Income 200 Spending Score 200 dtype: int64 ----------------------------------------------------------------- CustomerID int64 Gender object Age int64 Annual Income int64 Spending Score int64 dtype: object
2.数据可视化
2.1 平行坐标图
- 平行坐标图(Parallel coordinates plot)是一种用于高维数据可视化的工具。它将各个属性(变量)表示为一系列相互平行的坐标轴,纵轴代表属性值,横轴代表属性类别。
- 如果在某个属性上,相同颜色的折线聚集度较高且不同颜色之间有明显的间距,这表明该属性对预标签类别的判定具有较大价值。
- 反之,如果某个属性上的线条混乱且颜色混杂,则该属性可能对标签类别的判定没有显著价值。
plotting.parallel_coordinates(df.drop('CustomerID', axis=1), 'Gender')
plt.title('平行坐标图', fontsize=12)
plt.grid(linestyle='-.')
plt.show()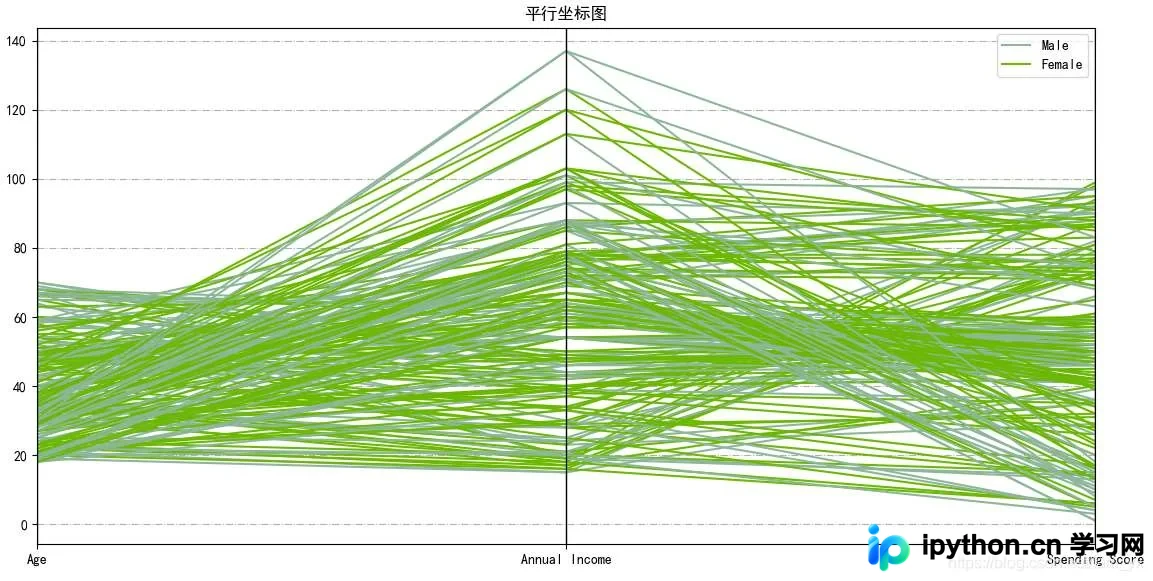
2.2 年龄/年收入/消费分数的分布
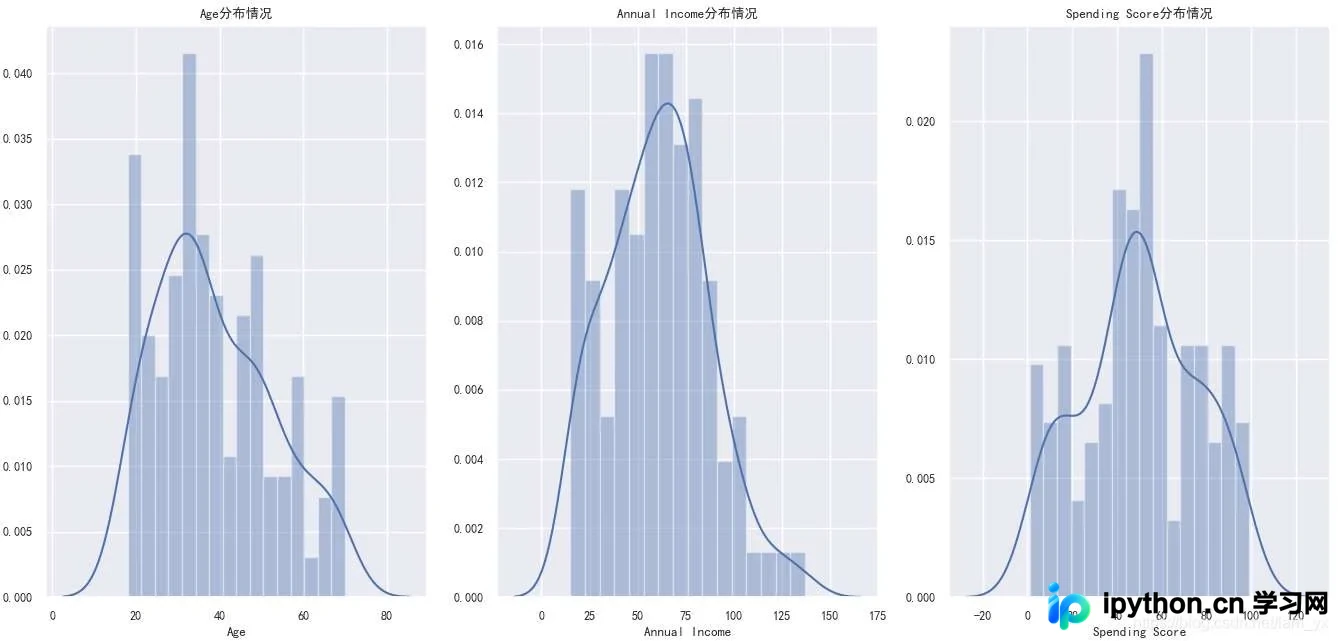
此处采用了直方图结合核密度图进行展示。(注:观察核密度图时,应关注(x<X)下方的面积,而非曲线的高度)。
sns.set(palette="muted", color_codes=True)  # seaborn样式
# 配置
plt.rcParams['axes.unicode_minus'] = False  # 解决无法显示符号的问题
sns.set(font='SimHei', font_scale=0.8)    # 解决Seaborn中文显示问题
# 绘图
plt.figure(1, figsize=(13, 6))
n = 0
for x in ['Age', 'Annual Income', 'Spending Score']:
  n += 1
  plt.subplot(1, 3, n)
  plt.subplots_adjust(hspace=0.5, wspace=0.5)
  sns.distplot(df[x], bins=16, kde=True)  # kde 密度曲线
  plt.title('{}分布情况'.format(x))
  plt.tight_layout()
plt.show()
如下图所示,从左至右依次展示了年龄、年收入和消费分数的分布情况。观察发现:
- 在年龄分布上:[30,36]年龄段的客户数量最多;[20,21]年龄段也有一定规模;而60岁以上的老年客户消费频率最低。
- 在年收入分布上:大部分客户的收入集中在[53,83]区间内,收入低于15或高于105的客户较少。
- 在消费分数分布上:分数在[40,55]区间的客户占大多数,[70,80]区间的客户次之。
2.3年龄/年收入/消费分数的柱状图
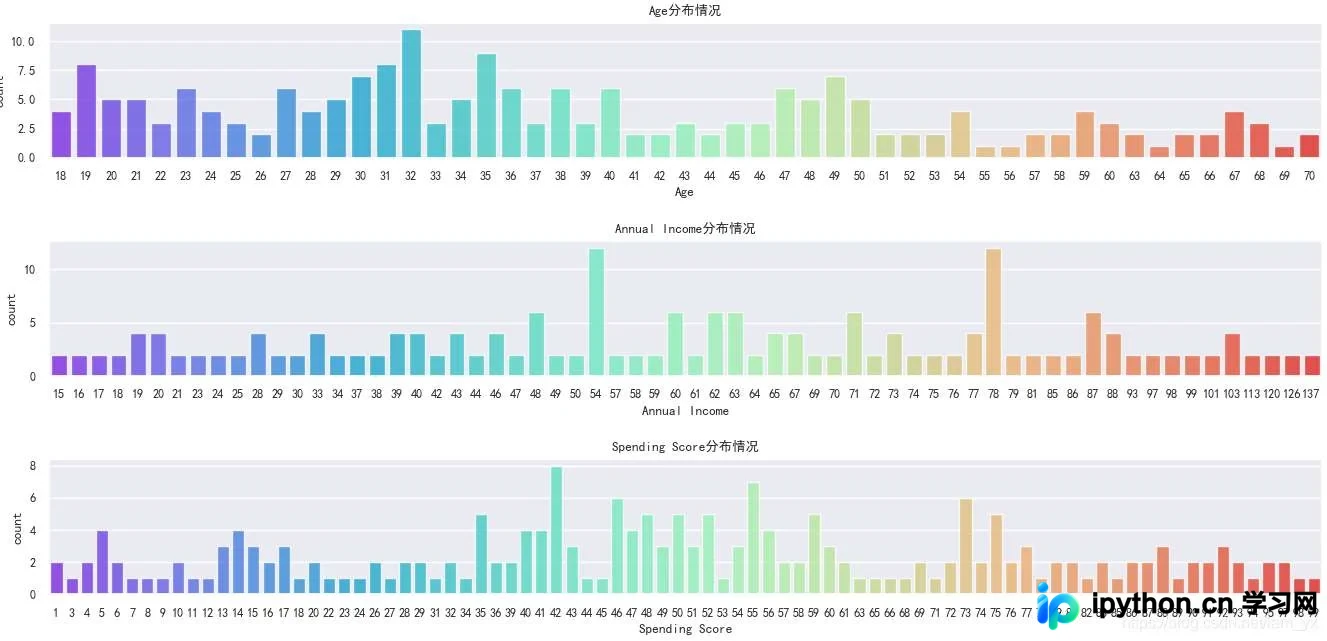
此处使用柱状图进行展示。与直方图不同,柱状图横轴(xxx轴)上的每个刻度对应的是一个离散的具体数值点,而非一个连续区间。
plt.figure(1, figsize=(13, 6))
k = 0
for x in ['Age', 'Annual Income', 'Spending Score']:
  k += 1
  plt.subplot(3, 1, k)
  plt.subplots_adjust(hspace=0.5, wspace=0.5)
  sns.countplot(df[x], palette='rainbow', alpha=0.8)
  plt.title('{}分布情况'.format(x))
  plt.tight_layout()
plt.show()
如下图所示,从上至下分别展示了年龄、年收入和消费分数的柱状图。观察发现:
- 在年龄方面:[27,40]年龄段的客户较为集中。其中,32岁的客户是商场的常客;而55、56、64、69岁的用户相对较少。总体而言,年轻群体较多,年长群体较少。
- 在年收入方面:年收入为54和78的客户频数最高。其他收入区间的客户频数差异不大。
- 在消费分数方面:消费分数为42的客户数量最多,56分次之。部分客户分数高达99,也有分数为1的客户,但未发现分数为0的情况。
2.4不同性别用户占比
df_gender_c = df['Gender'].value_counts()
p_lables = ['Female', 'Male']
p_color = ['lightcoral', 'lightskyblue']
p_explode = [0, 0.05]
# 绘图
plt.pie(df_gender_c, labels=p_lables, colors=p_color, explode=p_explode, shadow=True, autopct='%.2f%%')
plt.axis('off')
plt.legend()
plt.show()
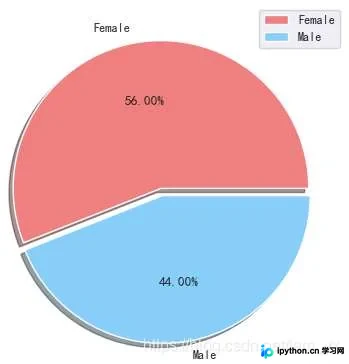
如下饼图所示,女性客户占比56%,处于领先地位;男性客户占比44%。当男性人口比例相对较高时,这一性别差距较为显著。
2.5 两两特征之间的关系
# df_a_a_s = df.drop(['CustomerID'], axis=1)
sns.pairplot(df, vars=['Age', 'Annual Income', 'Spending Score'], hue='Gender', aspect=1.5, kind='reg')
plt.show()
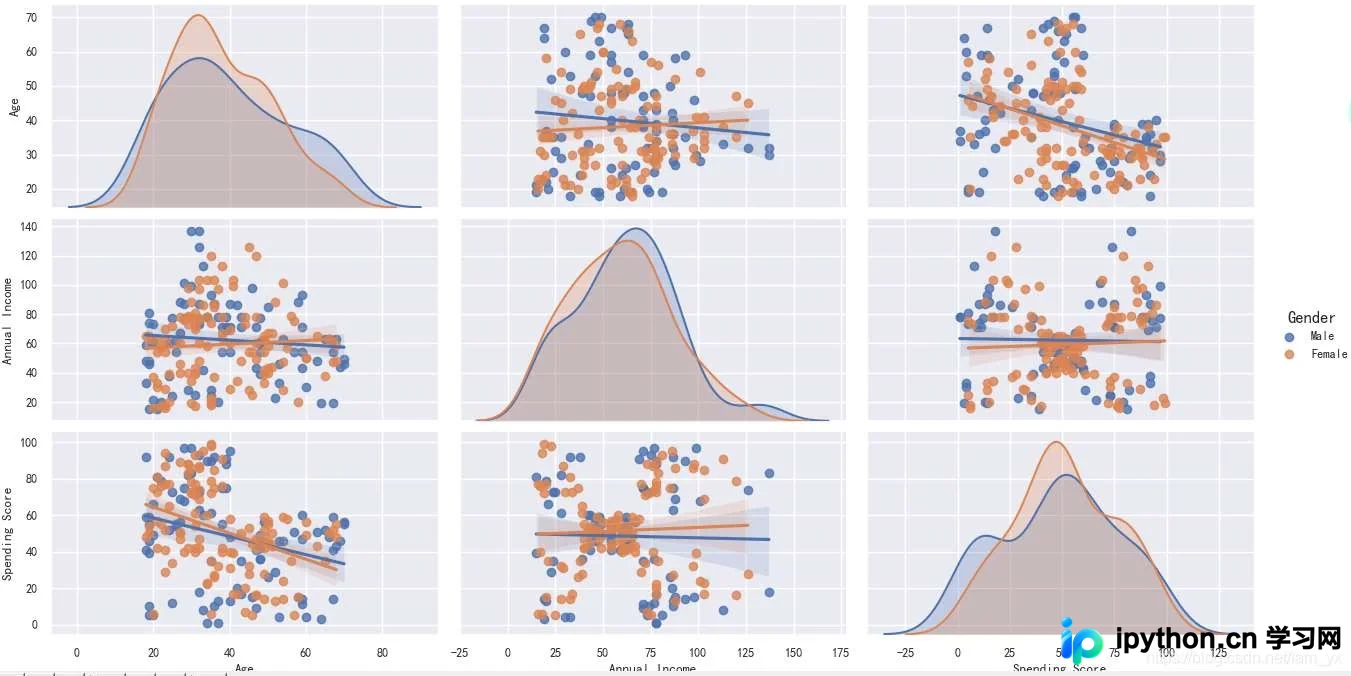
pairplot主要用于展示属性(变量)两两之间的关系(包括线性或非线性关系,以及是否存在明显的相关性)。注意,我对男、女性的数据点进行了区分(尽管数据在性别上的差异似乎不大)。如下组图所示:
- 对角线上的图表展示了各个属性的核密度分布情况。
- 非对角线上的图表展示了两个不同属性之间的相关性。可以看出,年收入与消费能力之间存在较为明显的相关关系。
- 将
kind参数设置为reg后,系统会为非对角线上的散点图拟合出一条回归直线,从而更直观地显示变量之间的关系。
2.6 两两特征之间的分布
# 根据分类变量分组绘制一个纵向的增强箱型图
plt.rcParams['axes.unicode_minus'] = False  # 解决无法显示符号的问题
sns.set(font='SimHei', font_scale=0.8)    # 解决Seaborn中文显示问题
sns.boxenplot(df['Gender'], df['Spending Score'], palette='Blues')
# x:设置分组统计字段,y:数据分布统计字段
sns.swarmplot(x=df['Gender'], y=df['Spending Score'], data=df, palette='dark', alpha=0.5, size=6)
plt.title('男女性的消费能力比较', fontsize=12)
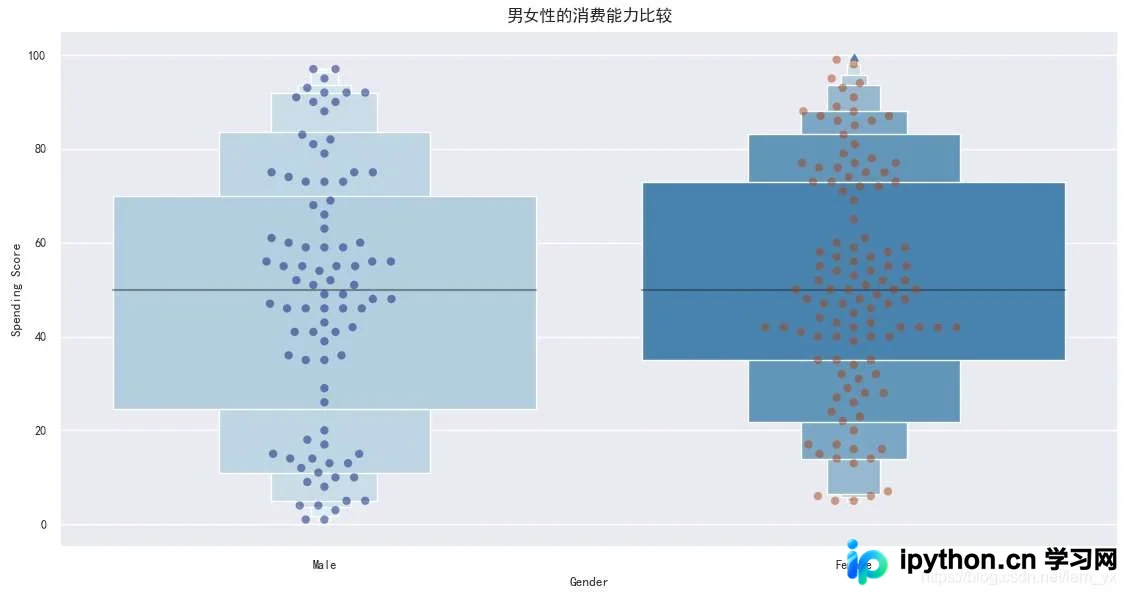
plt.show()- 如下图中使用了增强箱图(boxenplot),通过绘制更多的分位数来提供数据分布信息,这种方法适用于大数据集。
- 数据显示,男性的消费得分主要集中在[25,70]区间,而女性的消费得分主要集中在[35,75]区间。这在一定程度上表明,女性在购物方面的表现优于男性。
# 根据分类变量分组绘制一个纵向的增强箱型图
plt.rcParams['axes.unicode_minus'] = False  # 解决无法显示符号的问题
sns.set(font='SimHei', font_scale=0.8)    # 解决Seaborn中文显示问题
sns.boxenplot(df['Gender'], df['Spending Score'], palette='Blues')
# x:设置分组统计字段,y:数据分布统计字段
sns.swarmplot(x=df['Gender'], y=df['Spending Score'], data=df, palette='dark', alpha=0.5, size=6)
plt.title('男女性的消费能力比较', fontsize=12)
plt.show()
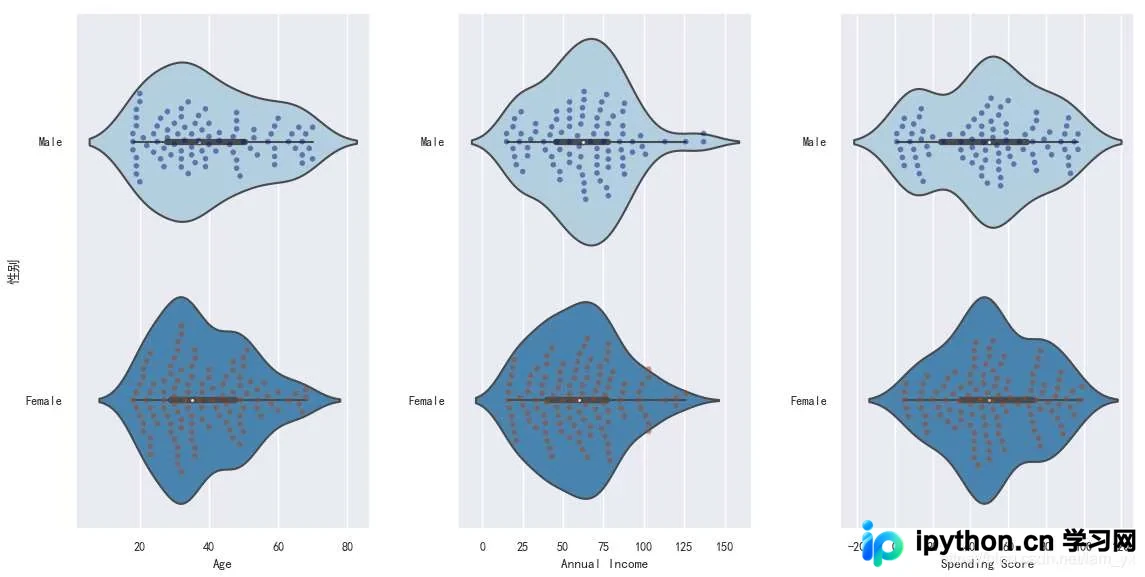
其实,下面这一部分也包含了上面的信息。
- 在年龄方面:男性分布较为均匀,20多岁的客户较多;女性的年龄大部分集中在20+~30+这个范围,整体看来较为年轻。
- 在收入方面:男性略胜一筹。
K-means聚类分析与结果
四、K-means聚类分析
0.手肘法简介
核心指标
误差平方和(sum of the squared errors,SSE)是所有样本的聚类误差,它反映了聚类效果的好坏,公式如下:
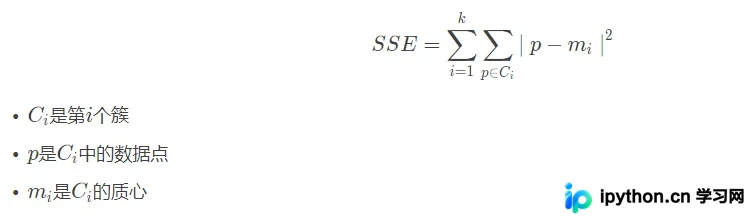
核心思想
- 随着聚类数k的增大,样本划分会更加精细,每个簇的聚合程度会逐渐提高,因此SSE会逐渐变小。
- 当k小于真实聚类数时,由于k的增加会大幅提升每个簇的聚合程度,故SSE的下降幅度会很大。
- 当k到达真实聚类数时,再增加k所得到的聚合程度回报会迅速变小,因此SSE的下降幅度会骤减。随后随着k值的继续增大,SSE趋于平缓。也就是说,SSE和k的关系图呈现出手肘的形状,而这个肘部对应的k值即为数据的真实聚类数。
1.基于年龄和消费分数的聚类
所需的数据字段为‘Age'和‘Spending Score'。
df_a_sc = df[['Age', 'Spending Score']].values
# 存放每次聚类结果的误差平方和
inertia1 = []
使用手肘法来确定最合适的k值。
for n in range(1, 11):
  # 构造聚类器
  km1 = (KMeans(n_clusters=n,    # 要分成的簇数,int类型,默认值为8
         init='k-means++',  # 初始化质心,k-means++是一种生成初始质心的算法
         n_init=10,      # 设置选择质心种子次数,默认为10次。返回质心最好的一次结果(好是指计算时长短)
         max_iter=300,    # 每次迭代的最大次数
         tol=0.0001,     # 容忍的最小误差,当误差小于tol就会退出迭代
         random_state=111,  # 随机生成器的种子 ,和初始化中心有关
         algorithm='elkan')) # 'full'是传统的K-Means算法,'elkan'是采用elkan K-Means算法
  # 用训练数据拟合聚类器模型
  km1.fit(df_a_sc)
  # 获取聚类标签
  inertia1.append(km1.inertia_)
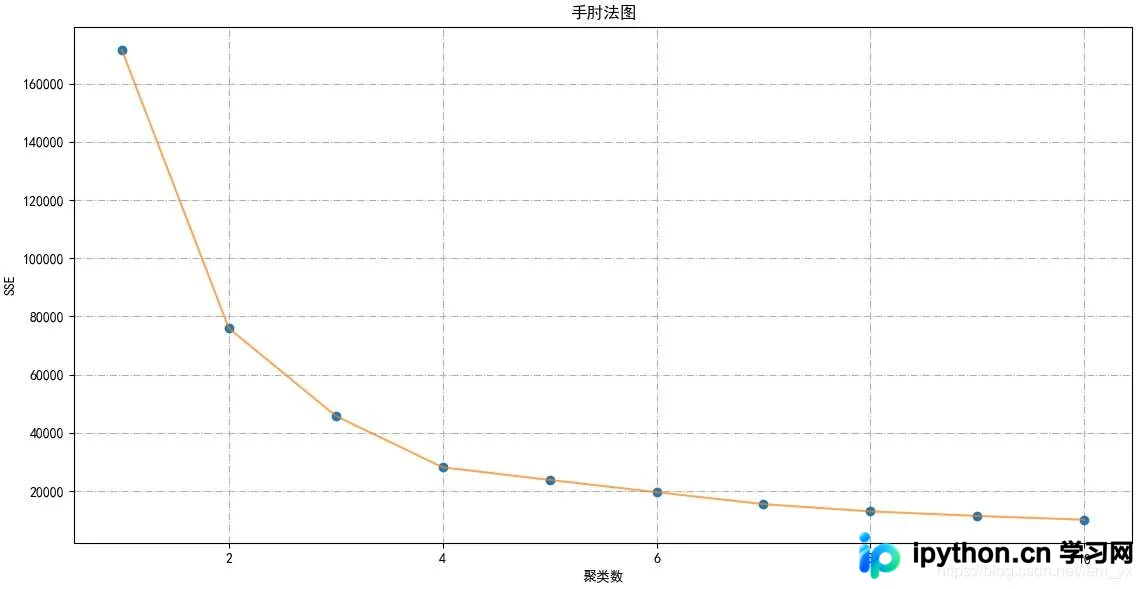
通过绘图确定k值,此处将k确定为4。
plt.figure(1, figsize=(15, 6))
plt.plot(np.arange(1, 11), inertia1, 'o')
plt.plot(np.arange(1, 11), inertia1, '-', alpha=0.7)
plt.title('手肘法图', fontsize=12)
plt.xlabel('聚类数'), plt.ylabel('SSE')
plt.grid(linestyle='-.')
plt.show()
通过如下图,确定k=4。
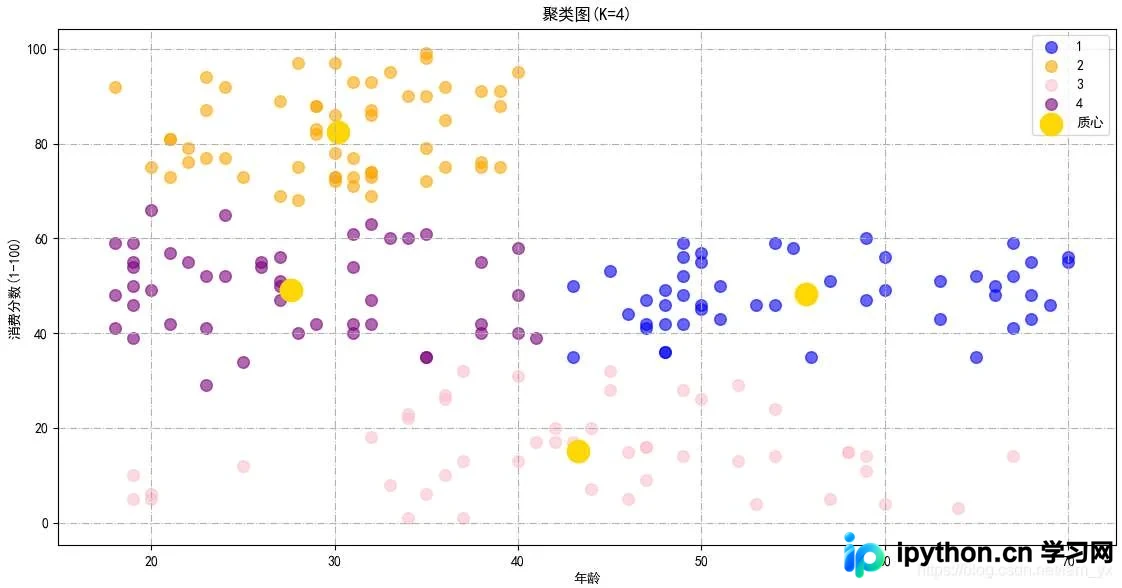
确定k=4后,重新构建k=4的K-means模型,并绘制聚类图。
km1_result = (KMeans(n_clusters=4, init='k-means++', n_init=10, max_iter=300,
           tol=0.0001, random_state=111, algorithm='elkan'))
# 先fit()再predict(),一次性得到聚类预测之后的标签
y1_means = km1_result.fit_predict(df_a_sc)
# 绘制结果图
plt.scatter(df_a_sc[y1_means == 0][:, 0], df_a_sc[y1_means == 0][:, 1], s=70, c='blue', label='1', alpha=0.6)
plt.scatter(df_a_sc[y1_means == 1][:, 0], df_a_sc[y1_means == 1][:, 1], s=70, c='orange', label='2', alpha=0.6)
plt.scatter(df_a_sc[y1_means == 2][:, 0], df_a_sc[y1_means == 2][:, 1], s=70, c='pink', label='3', alpha=0.6)
plt.scatter(df_a_sc[y1_means == 3][:, 0], df_a_sc[y1_means == 3][:, 1], s=70, c='purple', label='4', alpha=0.6)
plt.scatter(km1_result.cluster_centers_[:, 0], km1_result.cluster_centers_[:, 1], s=260, c='gold', label='质心')
plt.title('聚类图(K=4)', fontsize=12)
plt.xlabel('年收入(k$)')
plt.ylabel('消费分数(1-100)')
plt.legend()
plt.grid(linestyle='-.')
plt.show()
效果如下,基于年龄和消费能力这两个参数,可以将用户划分成4类。
2.基于年收入和消费分数的聚类
所需的数据
df_ai_sc = df[['Annual Income', 'Spending Score']].values
# 存放每次聚类结果的误差平方和
inertia2 = []
同理,使用手肘法确定合适的k值。
for n in range(1, 11):
  # 构造聚类器
  km2 = (KMeans(n_clusters=n, init='k-means++', n_init=10, max_iter=300, tol=0.0001, random_state=111, algorithm='elkan'))
  # 用训练数据拟合聚类器模型
  km2.fit(df_ai_sc)
  # 获取聚类标签
  inertia2.append(km2.inertia_)
# 绘制手肘图确定K值
plt.figure(1, figsize=(15, 6))
plt.plot(np.arange(1, 11), inertia1, 'o')
plt.plot(np.arange(1, 11), inertia1, '-', alpha=0.7)
plt.title('手肘法图', fontsize=12)
plt.xlabel('聚类数'), plt.ylabel('SSE')
plt.grid(linestyle='-.')
plt.show()
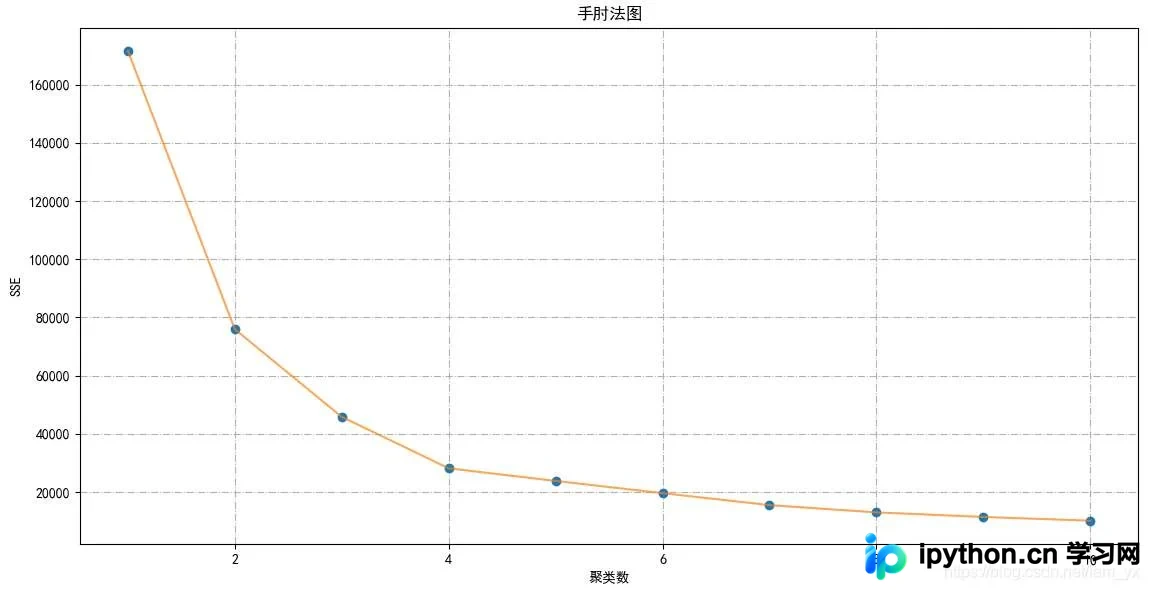
通过如下图,确定k=5。
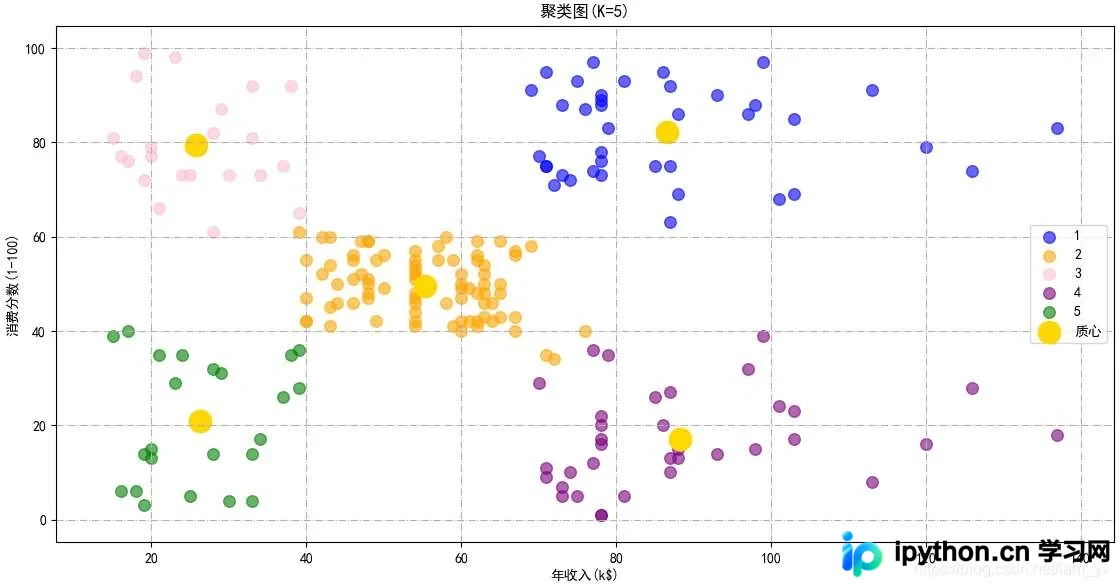
确定k=5后,重新构建k=5的K-means模型,并绘制聚类图。
km2_result = (KMeans(n_clusters=5, init='k-means++', n_init=10, max_iter=300,
           tol=0.0001, random_state=111, algorithm='elkan'))
# 先fit()再predict(),一次性得到聚类预测之后的标签
y2_means = km2_result.fit_predict(df_ai_sc)
# 绘制结果图
plt.scatter(df_ai_sc[y2_means == 0][:, 0], df_ai_sc[y2_means == 0][:, 1], s=70, c='blue', label='1', alpha=0.6)
plt.scatter(df_ai_sc[y2_means == 1][:, 0], df_ai_sc[y2_means == 1][:, 1], s=70, c='orange', label='2', alpha=0.6)
plt.scatter(df_ai_sc[y2_means == 2][:, 0], df_ai_sc[y2_means == 2][:, 1], s=70, c='pink', label='3', alpha=0.6)
plt.scatter(df_ai_sc[y2_means == 3][:, 0], df_ai_sc[y2_means == 3][:, 1], s=70, c='purple', label='4', alpha=0.6)
plt.scatter(df_ai_sc[y2_means == 4][:, 0], df_ai_sc[y2_means == 4][:, 1], s=70, c='green', label='5', alpha=0.6)
plt.scatter(km2_result.cluster_centers_[:, 0], km2_result.cluster_centers_[:, 1], s=260, c='gold', label='质心')
plt.title('聚类图(K=5)', fontsize=12)
plt.xlabel('年收入(k$)')
plt.ylabel('消费分数(1-100)')
plt.legend()
plt.grid(linestyle='-.')
plt.show()
效果如下,基于年收入和消费能力这两个参数,可以将用户划分成如下5类:
- 群体1 ⇒\Rightarrow⇒目标用户:这类客户年收入高,而且高消费。
- 群体2 ⇒\Rightarrow⇒普通用户:年收入与消费得分处于中等水平。
- 群体3 ⇒\Rightarrow⇒高消费用户:年收入水平较低,但是却有较强烈的消费意愿,舍得花钱。
- 群体4 ⇒\Rightarrow⇒节俭用户:年收入高但是消费意愿不强烈。群体5 ⇒\Rightarrow⇒谨慎用户:年收入和消费意愿都较低。
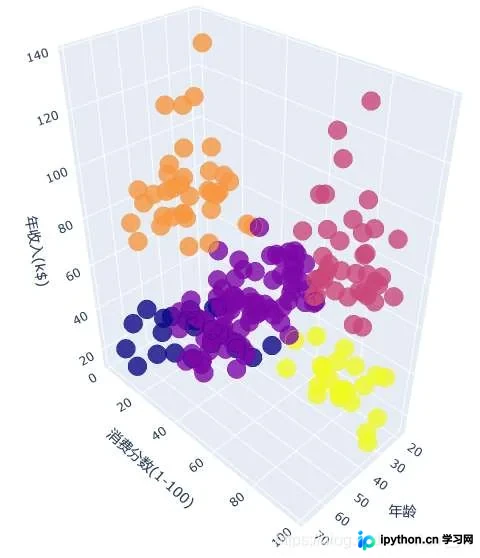
3.基于年龄、收入和消费分数的聚类所需要的数据
df_a_ai_sc = df[['Age', 'Annual Income', 'Spending Score']].values
进行聚类,设定k=5。
km3 = KMeans(n_clusters=5, init='k-means++', max_iter=300, n_init=10, random_state=0)
km3.fit(df_a_ai_sc)
绘制图形。
df['labels'] = km3.labels_
# 绘制3D图
trace1 = go.Scatter3d(
  x=df['Age'],
  y=df['Spending Score'],
  z=df['Annual Income'],
  mode='markers',
   marker=dict(
    color=df['labels'],
    size=10,
    line=dict(
      color=df['labels'],
      width=12
    ),
    opacity=0.8
   )
)
df_3dfid = [trace1]

layout = go.Layout(
  margin=dict(
    l=0,
    r=0,
    b=0,
    t=0
  ),
  scene=dict(
      xaxis=dict(title='年龄'),
      yaxis=dict(title='消费分数(1-100)'),
      zaxis=dict(title='年收入(k$)')
    )
)

fig = go.Figure(data=df_3dfid, layout=layout)
py.offline.plot(fig)
效果如下。
总结与展望
五、小结
- 本文主要记录K-means的学习过程,此前我也参与了一个使用K-means算法的项目。
- 如何进行特征选择是需要考虑的问题,我尝试了三种不同的方案。此外,确定k值也是另一个重要问题,此处使用了“手肘法”,但也可以配合“轮廓系数”进行综合判断。
- 文中还有许多地方不够详细。另外,如果有考虑不严谨的地方,欢迎批评指正!
到此这篇关于Python用K-means聚类算法进行客户分群的实现的文章就介绍到这了,更多相关Python K-means客户分群内容请搜索本站以前的文章或继续浏览下面的相关文章希望大家以后多多支持本站!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









