

Python实现B站热门视频数据抓取与Excel导出

发布时间:2026-10-14| 3人浏览过
本文介绍使用Python编写爬虫程序,通过requests获取B站热门视频页面HTML,利用lxml解析提取排名、标题、播放量及评论数等关键信息,最终将结构化数据写入Excel文件。
Python爬取B站热门视频并导出Excel的实现代码
具体实现代码如下
#encoding:utf-8
import requests
from lxml import etree
import xlwt
import os

# 爬取b站热门视频信息
def spider():
  video_list = []
  url = "https://www.bilibili.com/ranking?spm_id_from=333.851.b_7072696d61727950616765546162.3"
  html = requests.get(url, headers={"User-Agent": "Mozilla/5.0 (Windows NT 10.0; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/75.0.3770.100 Safari/537.36"}).text
  html = etree.HTML(html)
  infolist = html.xpath("//li[@class='rank-item']")
  for item in infolist:
    rank = "".join(item.xpath("./div[@class='num']/text()"))
    video_link = "".join(item.xpath(".//div[@class='info']/a/@href"))
    title = "".join(item.xpath(".//div[@class='info']/a/text()"))
    payinfo = "".join(item.xpath(".//div[@class='detail']/span/text()")).split("万")
    play = payinfo[0] + "万"
    comment = payinfo[1]
    if comment.isdigit() == False:
      comment += "万"
    upname = "".join(item.xpath(".//div[@class='detail']/a/span/text()"))
    uplink = "http://" + "".join(item.xpath(".//div[@class='detail']/a/@href"))
    hot = "".join(item.xpath(".//div[@class='pts']/div/text()"))
    video_list.append({
      'rank': rank,
      'videolink': video_link,
      'title': title,
      'play': play,
      'comment': comment,
      'upname': upname,
      'uplink': uplink,
      'hot': hot
    })
  return video_list


def write_Excel():
  # 将爬取的信息添加到Excel
  video_list = spider()
  workbook = xlwt.Workbook() # 定义表格
  sheet = workbook.add_sheet("b站热门视频")  # 添加sheet的name
  xstyle = xlwt.XFStyle()  # 实例化表格样式对象
  xstyle.alignment.horz = 0x02 # 字体居中
  xstyle.alignment.vert = 0x01
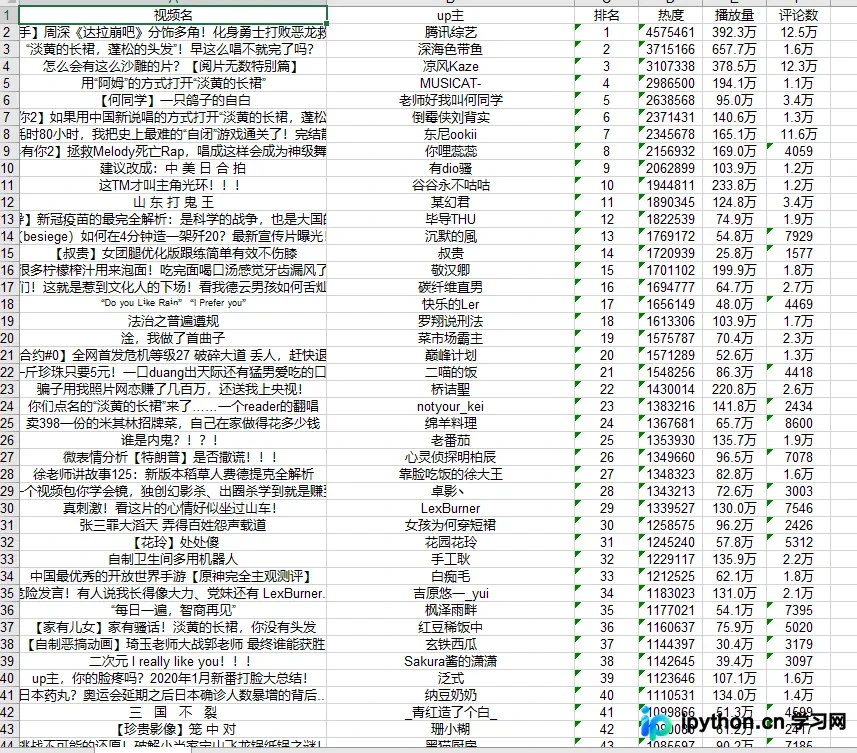
  head = ['视频名', 'up主','排名', '热度','播放量','评论数']
  for h in range(len(head)):
    sheet.write(0, h, head[h], xstyle)
  i = 1
  for item in video_list:
    # 向单元格(视频名)添加该视频的超链接
    if '"' in item["title"]:
      item["title"] = item["title"].split('"')[1]
    title_data = 'HYPERLINK("'+item["videolink"]+'";"'+item["title"]+'")'  # 设置超链接
    sheet.col(0).width = int(256 * len(title_data) * 3/5)  # 设置列宽
    sheet.write(i, 0, xlwt.Formula(title_data), xstyle)
    name_data = 'HYPERLINK("'+item["uplink"]+'";"'+item["upname"]+'")'
    sheet.col(1).width = int(256 * len(name_data) * 3/5)
    sheet.write(i, 1, xlwt.Formula(name_data), xstyle)
    sheet.write(i, 2, item["rank"], xstyle)
    sheet.write(i, 3, item["hot"], xstyle)
    sheet.write(i, 4, item["play"], xstyle)
    sheet.write(i, 5, item["comment"], xstyle)
    i += 1
  # 如果文件存在,则将其删除
  file = "b站热门视频信息.xls"
  if os.path.exists(file):
    os.remove(file)
  workbook.save(file)

if __name__ == '__main__':
  write_Excel()
运行程序后的结果展示如下
以上内容即为本次教程的全部介绍,希望能为读者的学习提供便利,同时也期待大家持续关注本站以获取更多信息。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









