

Django后台从富文本提取纯文本及React前端显示方案

本文介绍在Django后台如何从富文本内容中提取纯文本,提供正则表达式与Django内置striptags两种方法。同时补充React前端处理HTML字符串显示的问题,推荐使用dangerouslySetInnerHTML属性解决标签原样显示异常。
前言:
在实际开发中,富文本编辑器被广泛应用于版权声明、博客文章编辑等场景。然而,当我们需要实现基于关键字的搜索功能时,直接解析富文本中的HTML标签会导致匹配困难。由于Django框架本身未提供直接提取纯文本的专用函数,开发者通常需要借助正则表达式或前端提供的striptags过滤器来实现这一需求。
开始:
Django后台提取纯文本的方法
一、使用正则表达式提取
import re
content = ''.join(re.findall(">(.*?)<", content, re.S))
注意,re.S标志用于将换行符纳入匹配范围,通常情况下建议加上此标志以确保提取的完整性。
二、使用Django内置的striptags过滤器
from django.template.defaultfilters import striptags
content = striptags(content)
React前端显示富文本HTML字符串
补充知识:React前端显示富文本HTML字符串
从数据库提取出的富文本通常以HTML字符串形式存储。如果在React页面中直接渲染,浏览器可能会将HTML标签作为纯文本原样显示,而非解析为格式化的内容。为解决这一问题,可以使用dangerouslySetInnerHTML属性来渲染HTML字符串。
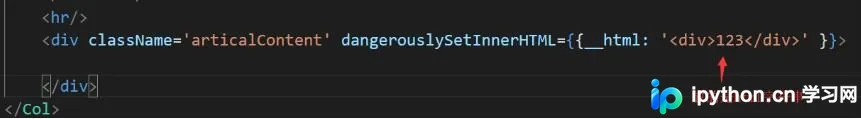
使用dangerouslySetInnerHTML时,务必确保其格式正确,通常接收一个包含__html键的对象。
以上介绍了Django后台提取纯文本的方法以及React前端正确显示富文本内容的技巧,希望能为相关开发者提供参考。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









