

Python多线程Buffer缓存器实现方案

发布时间:2026-10-14| 6人浏览过
针对人脸识别中GPU利用率低及数据传输与处理速度不匹配的问题,本文介绍使用Python多线程构建Buffer缓存器的实现思路。通过定义Buffer类,利用list作为存储空间,并结合线程锁与Condition变量实现读写同步,有效衔接数据传输与GPU处理速度。
问题背景与优化目标
在进行人脸识别技术的学习过程中,尽管程序运行正常,但发现了一个潜在的性能瓶颈问题。
具体表现为在图片数据传输阶段,GPU的利用率始终为0。
这表明当前的图片传输速率与GPU的处理速率之间缺乏良好的协同机制,导致资源闲置。
为了解决这一衔接问题,计划采用多线程技术来开发一个Buffer缓存模块。
Buffer缓存器实现思路
具体的实现逻辑如下所述。
首先定义一个Buffer类,并在其构造函数中初始化一个buffer空间,建议优先使用list类型来存储数据。
此外,还需要定义线程锁LOCK,以便在数据传输和提取过程中进行同步控制。
由于系统涉及数据写入(读数据)和数据读取(取数据)两种操作,因此需要分别定义两个锁来确保并发安全。
具体的实现代码展示如下。
核心代码实现
#-*-coding:utf-8-*-
import threading

class Buffer:

  def __init__(self,size):
    self.size = size
    self.buffer = []
    self.lock = threading.Lock()
    self.has_data = threading.Condition(self.lock) # small sock depand on big sock
    self.has_pos = threading.Condition(self.lock)
  def get_size(self):
    return self.size
  def get(self):
    with self.has_data:
      while len(self.buffer) == 0:
        print("I can't go out has_data")
        self.has_data.wait()
        print("I can go out has_data")
      result = self.buffer[0]
      del self.buffer[0]
      self.has_pos.notify_all()
    return result
  def put(self, data):
    with self.has_pos:
      #print(self.count)
      while len(self.buffer)>=self.size:
        print("I can't go out has_pos")
        self.has_pos.wait()
        print("I can go out has_pos")
      # If the length of data bigger than buffer's will wait
      self.buffer.append(data)
      # some thread is wait data ,so data need release
      self.has_data.notify_all()

if __name__ == "__main__":
	buffer = Buffer(3)
	def get():
	  for _ in range(10000):
	    print(buffer.get())

	def put():
	  a = [[1,2,3,4,5,6,7,8,9],[1,2,3,4,5,6,7,8,9],[1,2,3,4,5,6,7,8,9]]
	  for _ in range(10000):
	    buffer.put(a)
  th1 = threading.Thread(target=put)
  th2 = threading.Thread(target=get)
  th1.start()
  th2.start()
  th1.join()
  th2.join()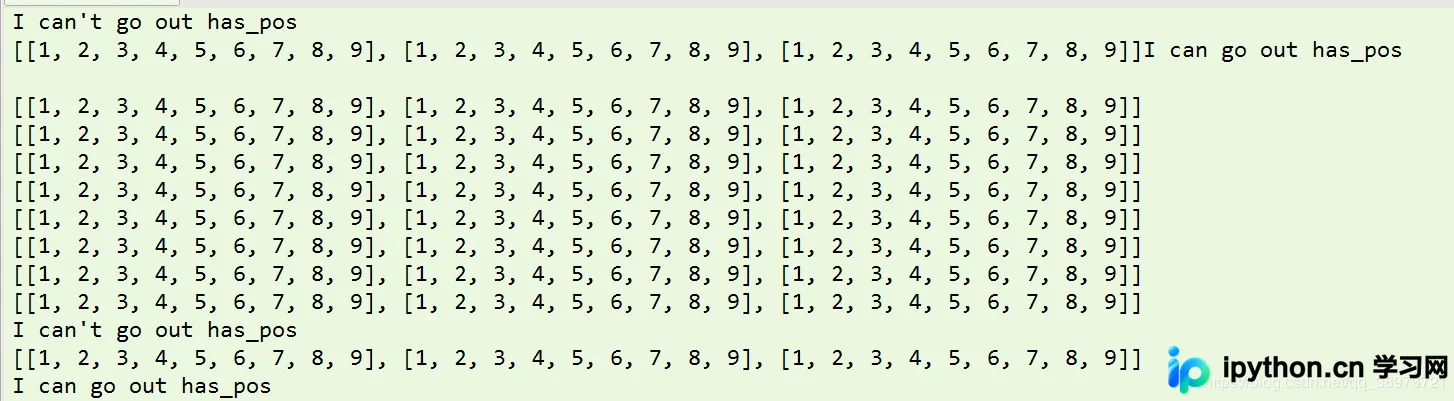
总结
综上所述,本文介绍了基于Python多线程的Buffer缓存器设计。更多关于Python多线程及Buffer缓存器的相关内容,欢迎查阅本站过往文章或继续浏览后续教程,感谢大家的支持。
到此这篇关于python 使用多线程创建一个Buffer缓存器的文章就介绍到这了,更多相关python 多线程Buffer缓存器内容请搜索本站以前的文章或继续浏览下面的相关文章希望大家以后多多支持本站!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









