

Python实现二分类与多分类ROC曲线绘制详解

本文详细介绍如何使用Python绘制二分类和多分类问题的ROC曲线。涵盖Precision、Recall、F-measure等核心指标定义,并通过完整代码示例展示如何利用sklearn和matplotlib实现ROC曲线及AUC计算,帮助开发者理解分类器性能评估方法。
核心评估指标定义
基本概念
Precision(精确率):指在所有被预测为正类的样本中,实际为正类的比例。该值越高越好,理想状态为1。
Recall(召回率):指在所有实际为正类的样本中,被正确预测为正类的比例。该值越高越好,理想状态为1。
F-measure(F度量):是对精确率和召回率的综合权衡指标。该值越高越好,理想状态为1,此时精确率和召回率均为1。
Accuracy(准确率):指所有正确预测的样本(包括将正类预测为正类,以及将负类预测为负类)占总样本的比例。该值越高越好,理想状态为1。
FPR(假阳性率):指所有实际为负类的样本中,被错误预测为正类的比例。该值越低越好,理想状态为0。
TPR(真阳性率):指所有实际为正类的样本中,被正确预测为正类的比例。该值越高越好,理想状态为1。
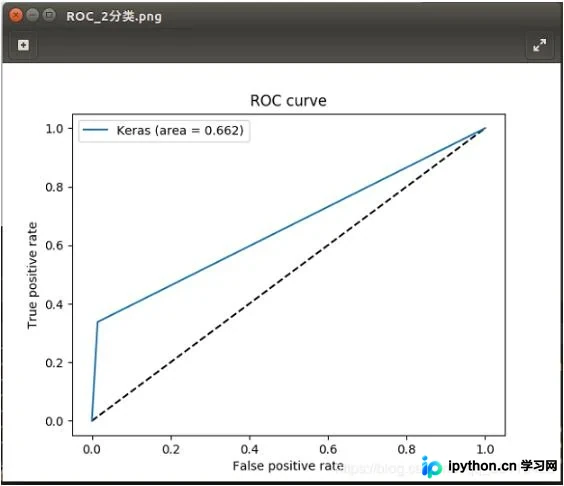
ROC曲线通常以Y轴表示真阳性率(TPR),X轴表示假阳性率(FPR)。这意味着图的左上角代表“理想”点,即误报率为零且真阳性率为1。虽然这种情况不太现实,但曲线下面积(AUC)越大通常意味着分类器性能越好。
二分类ROC曲线实现
二分类问题:ROC曲线
from __future__ import absolute_import
from __future__ import division
from __future__ import print_function
import time
start_time = time.time()
import matplotlib.pyplot as plt
from sklearn.metrics import roc_curve
from sklearn.metrics import auc
import numpy as np
from sklearn.model_selection import train_test_split
from sklearn.metrics import recall_score,accuracy_score
from sklearn.metrics import precision_score,f1_score
from keras.optimizers import Adam,SGD,sgd
from keras.models import load_model

print('读取数据')
X_train = np.load('x_train-rotate_2.npy')
Y_train = np.load('y_train-rotate_2.npy')
print(X_train.shape)
print(Y_train.shape)

print('获取测试数据和验证数据')
X_train, X_valid, Y_train, Y_valid = train_test_split(X_train, Y_train, test_size=0.1, random_state=666)

Y_train = np.asarray(Y_train,np.uint8)
Y_valid = np.asarray(Y_valid,np.uint8)
X_valid = np.array(X_valid, np.float32) / 255.

print('获取模型')
model = load_model('./model/InceptionV3_model.h5')
opt = Adam(lr=1e-4)
model.compile(optimizer=opt, loss='binary_crossentropy')

print("Predicting")
Y_pred = model.predict(X_valid)
Y_pred = [np.argmax(y) for y in Y_pred] # 取出y中元素最大值所对应的索引
Y_valid = [np.argmax(y) for y in Y_valid]

# micro:多分类
# weighted:不均衡数量的类来说,计算二分类metrics的平均
# macro:计算二分类metrics的均值,为每个类给出相同权重的分值。
precision = precision_score(Y_valid, Y_pred, average='weighted')
recall = recall_score(Y_valid, Y_pred, average='weighted')
f1_score = f1_score(Y_valid, Y_pred, average='weighted')
accuracy_score = accuracy_score(Y_valid, Y_pred)
print("Precision_score:",precision)
print("Recall_score:",recall)
print("F1_score:",f1_score)
print("Accuracy_score:",accuracy_score)

# 二分类 ROC曲线
# roc_curve:真正率(True Positive Rate , TPR)或灵敏度(sensitivity)
# 横坐标:假正率(False Positive Rate , FPR)
fpr, tpr, thresholds_keras = roc_curve(Y_valid, Y_pred)
auc = auc(fpr, tpr)
print("AUC : ", auc)
plt.figure()
plt.plot([0, 1], [0, 1], 'k--')
plt.plot(fpr, tpr, label='Keras (area = {:.3f})'.format(auc))
plt.xlabel('False positive rate')
plt.ylabel('True positive rate')
plt.title('ROC curve')
plt.legend(loc='best')
plt.savefig("../images/ROC/ROC_2分类.png")
plt.show()

print("--- %s seconds ---" % (time.time() - start_time))
ROC图如下所示:
多分类ROC曲线扩展
多分类问题:ROC曲线
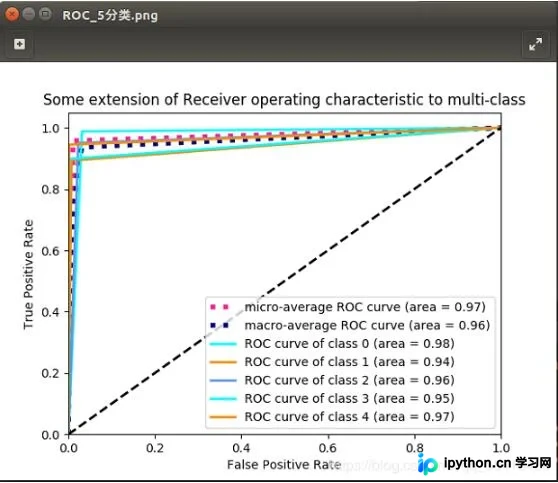
ROC曲线通常用于二分类以研究分类器的输出。为了将ROC曲线和ROC区域扩展到多类或多标签分类,有必要对输出进行二值化。⑴可以每个标签绘制一条ROC曲线。⑵也可以通过将标签指示符矩阵的每个元素视为二元预测(微平均)来绘制ROC曲线。⑶另一种用于多类别分类的评估方法是宏观平均,它对每个标签的分类给予相同的权重。
from __future__ import absolute_import
from __future__ import division
from __future__ import print_function
import time
start_time = time.time()
import matplotlib.pyplot as plt
from sklearn.metrics import roc_curve
from sklearn.metrics import auc
import numpy as np
from sklearn.model_selection import train_test_split
from sklearn.metrics import recall_score,accuracy_score
from sklearn.metrics import precision_score,f1_score
from keras.optimizers import Adam,SGD,sgd
from keras.models import load_model
from itertools import cycle
from scipy import interp
from sklearn.preprocessing import label_binarize

nb_classes = 5
print('读取数据')
X_train = np.load('x_train-resized_5.npy')
Y_train = np.load('y_train-resized_5.npy')
print(X_train.shape)
print(Y_train.shape)

print('获取测试数据和验证数据')
X_train, X_valid, Y_train, Y_valid = train_test_split(X_train, Y_train, test_size=0.1, random_state=666)

Y_train = np.asarray(Y_train,np.uint8)
Y_valid = np.asarray(Y_valid,np.uint8)
X_valid = np.asarray(X_valid, np.float32) / 255.

print('获取模型')
model = load_model('./model/SE-InceptionV3_model.h5')
opt = Adam(lr=1e-4)
model.compile(optimizer=opt, loss='categorical_crossentropy')

print("Predicting")
Y_pred = model.predict(X_valid)
Y_pred = [np.argmax(y) for y in Y_pred] # 取出y中元素最大值所对应的索引
Y_valid = [np.argmax(y) for y in Y_valid]

# Binarize the output
Y_valid = label_binarize(Y_valid, classes=[i for i in range(nb_classes)])
Y_pred = label_binarize(Y_pred, classes=[i for i in range(nb_classes)])

# micro:多分类
# weighted:不均衡数量的类来说,计算二分类metrics的平均
# macro:计算二分类metrics的均值,为每个类给出相同权重的分值。
precision = precision_score(Y_valid, Y_pred, average='micro')
recall = recall_score(Y_valid, Y_pred, average='micro')
f1_score = f1_score(Y_valid, Y_pred, average='micro')
accuracy_score = accuracy_score(Y_valid, Y_pred)
print("Precision_score:",precision)
print("Recall_score:",recall)
print("F1_score:",f1_score)
print("Accuracy_score:",accuracy_score)

# roc_curve:真正率(True Positive Rate , TPR)或灵敏度(sensitivity)
# 横坐标:假正率(False Positive Rate , FPR)

# Compute ROC curve and ROC area for each class
fpr = dict()
tpr = dict()
roc_auc = dict()
for i in range(nb_classes):
 fpr[i], tpr[i], _ = roc_curve(Y_valid[:, i], Y_pred[:, i])
 roc_auc[i] = auc(fpr[i], tpr[i])

# Compute micro-average ROC curve and ROC area
fpr["micro"], tpr["micro"], _ = roc_curve(Y_valid.ravel(), Y_pred.ravel())
roc_auc["micro"] = auc(fpr["micro"], tpr["micro"])

# Compute macro-average ROC curve and ROC area

# First aggregate all false positive rates
all_fpr = np.unique(np.concatenate([fpr[i] for i in range(nb_classes)]))

# Then interpolate all ROC curves at this points
mean_tpr = np.zeros_like(all_fpr)
for i in range(nb_classes):
 mean_tpr += interp(all_fpr, fpr[i], tpr[i])

# Finally average it and compute AUC
mean_tpr /= nb_classes

fpr["macro"] = all_fpr
tpr["macro"] = mean_tpr
roc_auc["macro"] = auc(fpr["macro"], tpr["macro"])

# Plot all ROC curves
lw = 2
plt.figure()
plt.plot(fpr["micro"], tpr["micro"],
  label='micro-average ROC curve (area = {0:0.2f})'
  ''.format(roc_auc["micro"]),
  color='deeppink', linestyle=':', linewidth=4)

plt.plot(fpr["macro"], tpr["macro"],
  label='macro-average ROC curve (area = {0:0.2f})'
  ''.format(roc_auc["macro"]),
  color='navy', linestyle=':', linewidth=4)

colors = cycle(['aqua', 'darkorange', 'cornflowerblue'])
for i, color in zip(range(nb_classes), colors):
 plt.plot(fpr[i], tpr[i], color=color, lw=lw,
  label='ROC curve of class {0} (area = {1:0.2f})'
  ''.format(i, roc_auc[i]))

plt.plot([0, 1], [0, 1], 'k--', lw=lw)
plt.xlim([0.0, 1.0])
plt.ylim([0.0, 1.05])
plt.xlabel('False Positive Rate')
plt.ylabel('True Positive Rate')
plt.title('Some extension of Receiver operating characteristic to multi-class')
plt.legend(loc="lower right")
plt.savefig("../images/ROC/ROC_5分类.png")
plt.show()

print("--- %s seconds ---" % (time.time() - start_time))
ROC图如下所示:
以上这篇python实现二分类和多分类的ROC曲线教程就是小编分享给大家的全部内容了,希望能给大家一个参考,也希望大家多多支持本站。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









