

Python实现Softmax与交叉熵函数及损失函数对比分析

发布时间:2026-10-14| 6人浏览过
本文提供Python实现的Softmax函数与交叉熵损失函数代码示例,并深入解析分类任务中为何优先使用交叉熵而非均方误差(MSE)。通过对比分析指出,交叉熵仅关注正确分类结果,而MSE会受错误分类影响,导致训练效率差异。
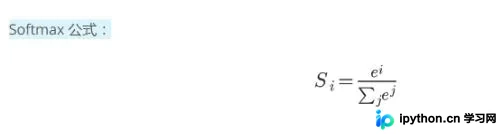
Python实现Softmax与交叉熵函数
以下是使用Python编写的Softmax函数代码示例:
import numpy as np

# Write a function that takes as input a list of numbers, and returns
# the list of values given by the softmax function.
def softmax(L):
 pass
 expL = np.exp(L)
 sumExpL = sum(expL)
 result = []
 for i in expL:
  result.append(i*1.0/sumExpL)
 return result
接下来展示Python中交叉熵公式的具体实现代码:
import numpy as np

def cross_entropy(Y, P):
 Y = np.float_(Y)
 P = np.float_(P)
 return -np.sum(Y * np.log(P) + (1 - Y) * np.log(1 - P))
分类任务中损失函数的选择:交叉熵与MSE对比
补充说明:在分类任务中,通常不采用均方误差(MSE),而是选择交叉熵作为损失函数,其原因如下。
MSE(均方误差)会对所有输出结果赋予同等重视,而交叉熵则主要关注正确分类的预测结果。
举例说明:假设在一个三分类模型中,模型的预测输出为(a, b, c),而真实标签为(1, 0, 0)。此时,MSE与交叉熵对应的损失函数计算值分别如下:
MSE的计算结果:
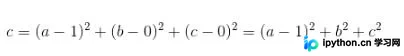
交叉熵的计算结果:
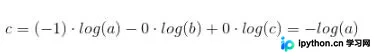
从上述公式可以看出,交叉熵损失函数仅与正确分类的预测结果相关,而MSE损失函数则同时受到错误分类结果的影响。MSE在促使正确分类概率增大的同时,还会试图让错误分类的概率趋于平均,但在实际分类问题中,这种对错误分类的“平均化”调整并无必要。
然而,对于回归问题而言,这种对所有输出结果的均衡考量则显得至关重要。因此,在回归任务中使用交叉熵并不合适。
以上关于Python编写Softmax函数与交叉熵函数的实例分享完毕,希望能为读者提供参考。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









