

Python实现密度聚类:从手写模板到sklearn应用

发布时间:2026-10-13| 2人浏览过
本文详细介绍如何使用Python实现密度聚类算法。通过手写DBSCAN模板代码深入理解核心逻辑,包括距离计算、邻域获取及聚类过程,并对比调用sklearn库的标准实现方式。文章提供完整代码示例与可视化结果,帮助开发者掌握密度聚类的原理与实践。
密度聚类实现思路与模板代码
本文不赘述密度聚类的理论背景,重点展示密度聚类的自定义模板代码以及调用sklearn库进行密度聚类的方法。许多读者可能会问,既然已有高效的sklearn库,为何还要手动实现?虽然库函数运行效率更高且更便捷,但手动编写代码能加深对算法内部机制的理解,从而提升对算法的掌握程度。
#调用科学计算包与绘图包
import numpy as np
import random
import matplotlib.pyplot as plt
# 获取数据
def loadDataSet(filename):
  dataSet=np.loadtxt(filename,dtype=np.float32,delimiter=',')
  return dataSet
#计算两个向量之间的欧式距离
def calDist(X1 , X2 ):
  sum = 0
  for x1 , x2 in zip(X1 , X2):
    sum += (x1 - x2) ** 2
  return sum ** 0.5
#获取一个点的ε-邻域(记录的是索引)
def getNeibor(data , dataSet , e):
  res = []
  for i in range(dataSet.shape[0]):
    if calDist(data , dataSet[i])<e:
      res.append(i)
  return res
#密度聚类算法
def DBSCAN(dataSet , e , minPts):
  coreObjs = {}#初始化核心对象集合
  C = {}
  n = dataSet.shape[0]
  #找出所有核心对象,key是核心对象的index,value是ε-邻域中对象的index
  for i in range(n):
    neibor = getNeibor(dataSet[i] , dataSet , e)
    if len(neibor)>=minPts:
      coreObjs[i] = neibor
  oldCoreObjs = coreObjs.copy()
  k = 0#初始化聚类簇数
  notAccess = list(range(n))#初始化未访问样本集合(索引)
  while len(coreObjs)>0:
    OldNotAccess = []
    OldNotAccess.extend(notAccess)
    cores = coreObjs.keys()
    #随机选取一个核心对象
    randNum = random.randint(0,len(cores)-1)
    cores=list(cores)
    core = cores[randNum]
    queue = []
    queue.append(core)
    notAccess.remove(core)
    while len(queue)>0:
      q = queue[0]
      del queue[0]
      if q in oldCoreObjs.keys() :
        delte = [val for val in oldCoreObjs[q] if val in notAccess]#Δ = N(q)∩Γ
        queue.extend(delte)#将Δ中的样本加入队列Q
        notAccess = [val for val in notAccess if val not in delte]#Γ = Γ\Δ
    k += 1
    C[k] = [val for val in OldNotAccess if val not in notAccess]
    for x in C[k]:
      if x in coreObjs.keys():
        del coreObjs[x]
  return C
sklearn库密度聚类调用示例
# 代码入口
dataSet = loadDataSet(r"E:\jupyter\sklearn学习\sklearn聚类\DataSet.txt")
print(dataSet)
print(dataSet.shape)
C = DBSCAN(dataSet, 0.11, 5)
draw(C, dataSet)
聚类结果可视化展示:
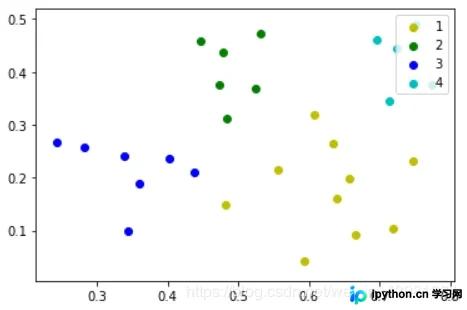
接下来是使用sklearn库调用密度聚类算法的代码实现:
db = skc.DBSCAN(eps=1.5, min_samples=3).fit(dataSet) #DBSCAN聚类方法 还有参数,matric = ""距离计算方法
labels = db.labels_ #和X同一个维度,labels对应索引序号的值 为她所在簇的序号。若簇编号为-1,表示为噪声
print('每个样本的簇标号:')
print(labels)
raito = len(labels[labels[:] == -1]) / len(labels) #计算噪声点个数占总数的比例
print('噪声比:', format(raito, '.2%'))
n_clusters_ = len(set(labels)) - (1 if -1 in labels else 0) # 获取分簇的数目
print('分簇的数目: %d' % n_clusters_)
print("轮廓系数: %0.3f" % metrics.silhouette_score(X, labels)) #轮廓系数评价聚类的好坏
for i in range(n_clusters_):
  print('簇 ', i, '的所有样本:')
  one_cluster = X[labels == i]
  print(one_cluster)
  plt.plot(one_cluster[:,0],one_cluster[:,1],'o')
plt.show()
至此,关于Python实现密度聚类(包含模板代码与sklearn代码)的介绍完毕。如需了解更多Python密度聚类相关内容,建议查阅本站过往文章或继续阅读后续相关教程。感谢大家的支持!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









