

Python ORM:SQLAlchemy会话与事务管理

理解SQLAlchemy Session与事务边界
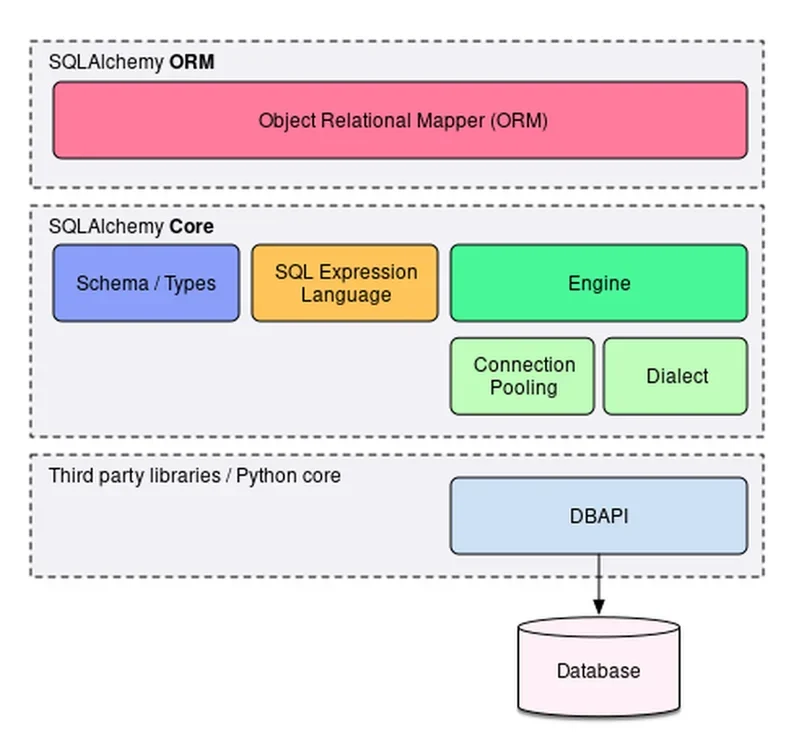
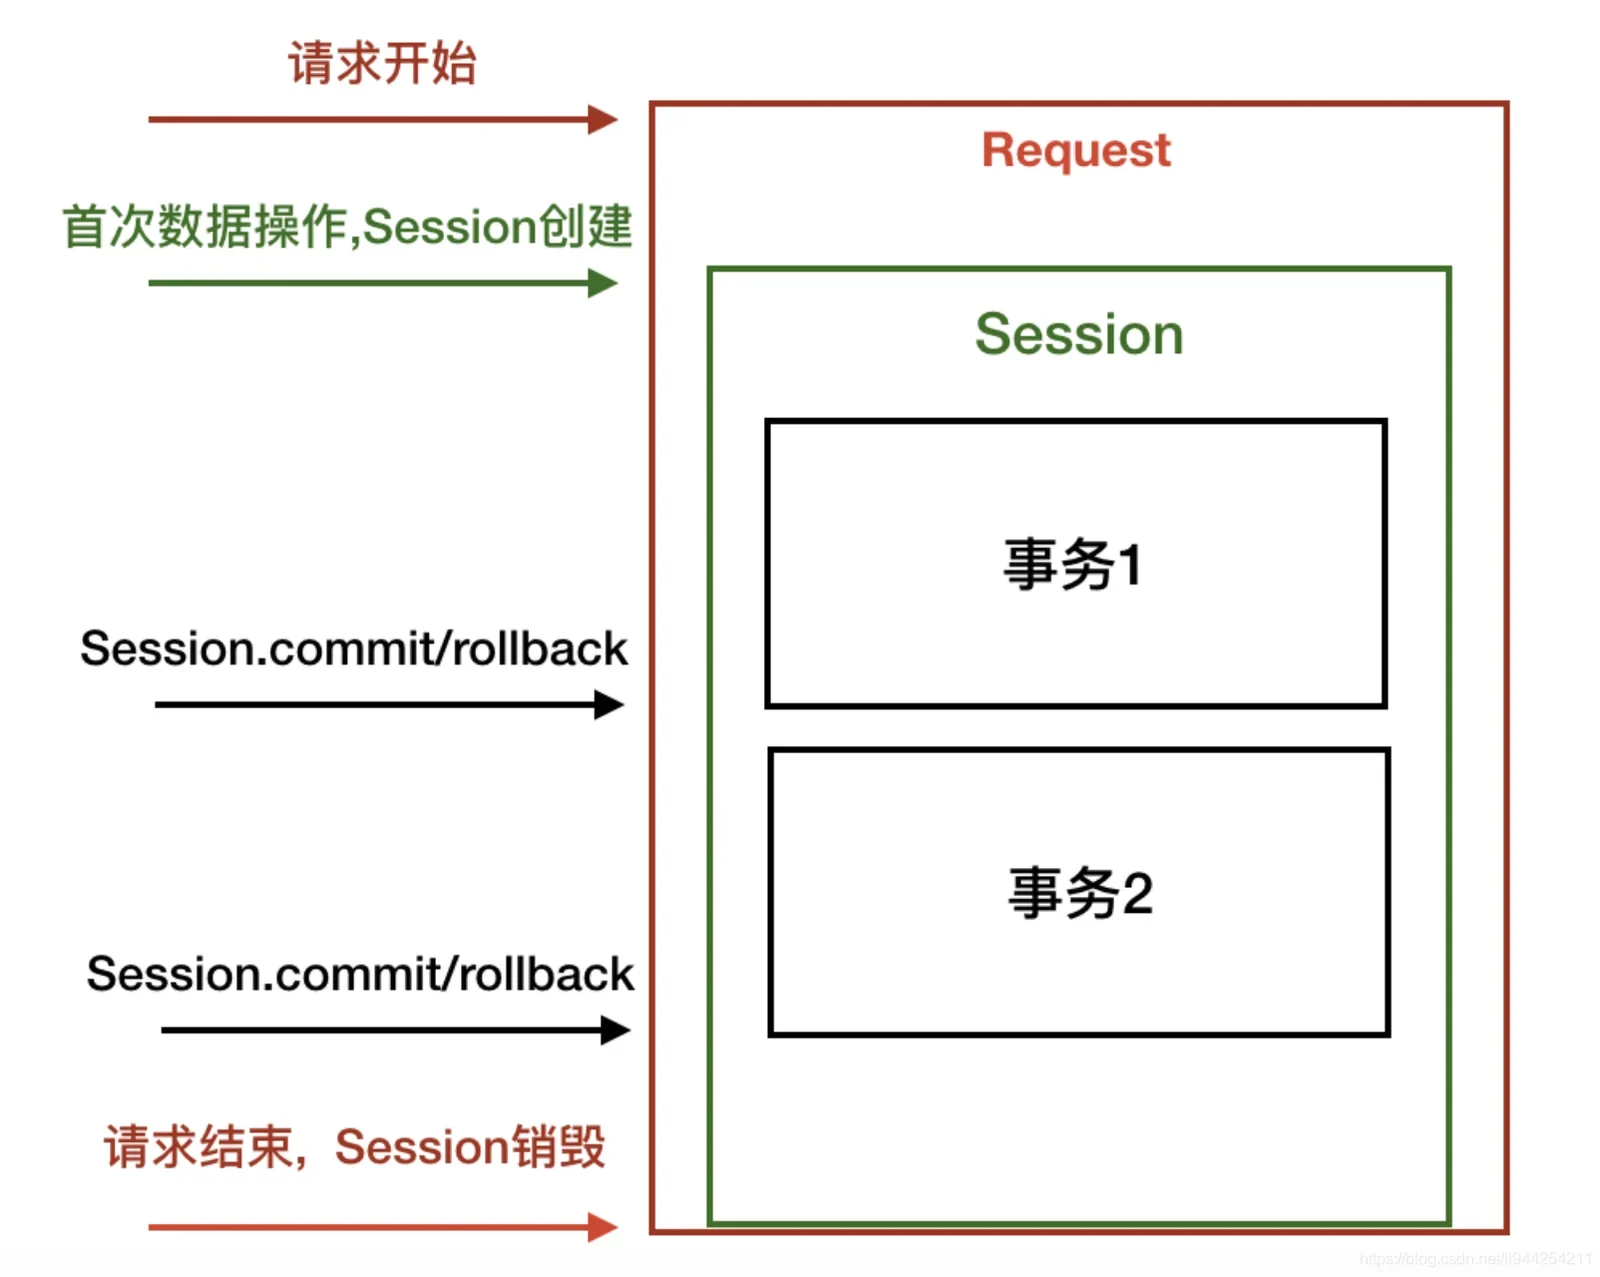
SQLAlchemy的Session是ORM层的核心工作单元,负责跟踪对象状态、生成SQL语句并维护数据库事务。Session本身不直接连接数据库,而是通过Engine获取连接池中的Connection来执行操作。当调用sessionmaker()创建Session工厂后,实例化Session即开启一个工作单元。默认情况下,Session在首次执行数据库操作(如查询或添加对象)时会自动隐式开启事务(BEGIN)。生命周期应遵循短生命周期原则:在需要执行一组相关操作时创建,操作完成后立即提交或回滚并关闭(session.close())。切勿在应用全局复用同一个Session实例,否则会导致状态混乱和内存泄漏。正确的做法是在函数或请求作用域内通过上下文管理器创建,确保每个工作单元独立且边界清晰。
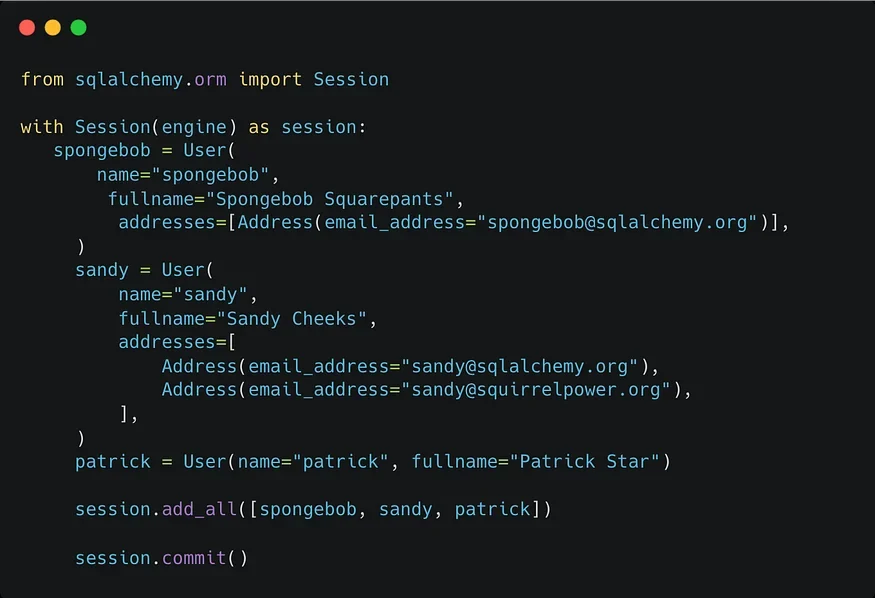
实现提交、回滚与事务上下文管理
在事务管理中,明确各方法的区别至关重要。session.add()仅将对象标记为待插入,不触发SQL;session.flush()将待处理状态同步至数据库,生成INSERT或UPDATE语句但事务未提交,主键可提前获取;session.commit()正式提交事务并释放数据库锁;session.rollback()则撤销所有未提交的更改并重置Session状态。推荐使用session.begin()上下文管理器实现原子操作。例如使用with session.begin():包裹业务逻辑,该结构会在代码块正常结束时自动调用commit,若抛出异常则自动执行rollback,避免手动管理遗漏。结合try-except可进一步细化错误处理,确保业务逻辑失败时数据一致性不受破坏,同时避免残留的脏数据影响后续操作。
处理并发会话与常见事务陷阱
Session并非线程安全,严禁在多线程或不同HTTP请求间共享同一实例,否则将引发竞态条件与数据错乱。在Web框架中,应采用请求级Session模式,即每个请求初始化独立Session,响应结束后统一清理。常见陷阱包括:事务嵌套导致隐式保存点行为不符合预期,可通过配置savepoint=True或改用独立Session隔离;长事务占用数据库连接池资源,应拆分大事务或优化查询逻辑;异常发生后继续复用Session会触发InvalidRequestError,因为Session已进入失效状态。规避方法是捕获异常后立即调用session.rollback()重置状态,或依赖上下文管理器自动清理。始终遵循一次请求一个事务或明确边界的小事务原则,可大幅提升系统稳定性。
验证事务结果并排查会话问题
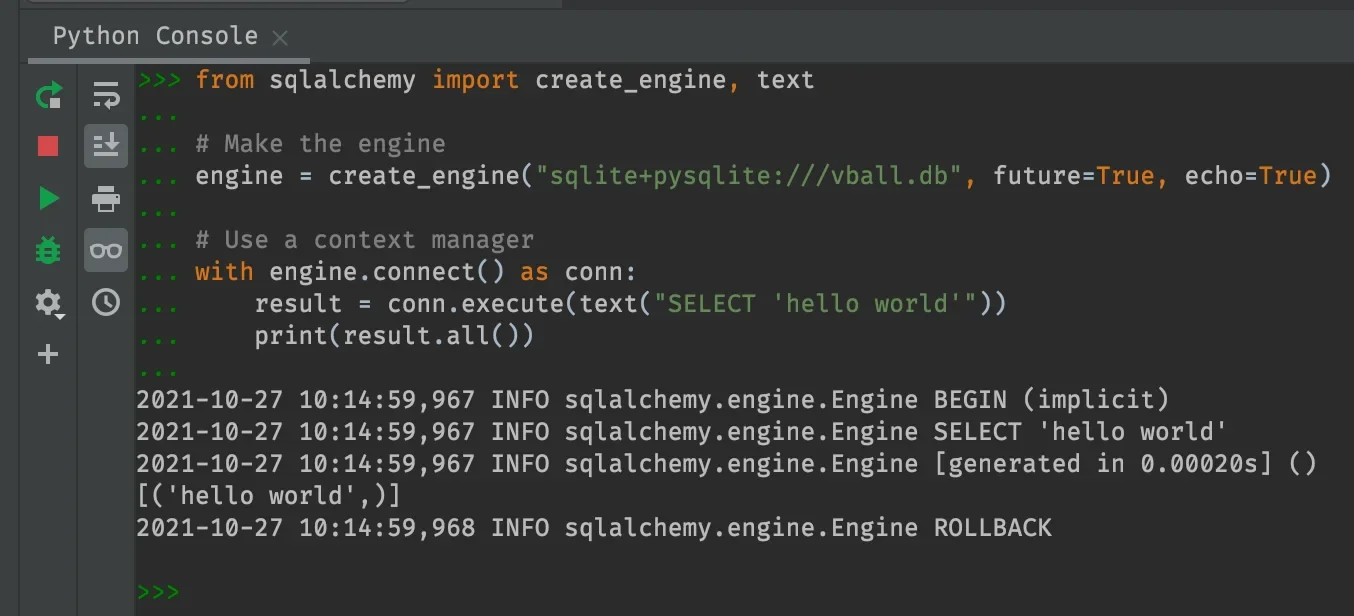
验证事务是否生效需结合代码查询、日志输出与数据库直连检查。开启echo=True可在控制台打印完整SQL流,观察BEGIN、COMMIT或ROLLBACK标记是否按预期出现。若提交后查询不到数据,通常因未调用commit()或事务被静默回滚。排查时需注意:调用session.close()后对象变为分离状态,再次访问延迟加载属性会报错,应使用session.expunge()或提前加载关联数据。未提交数据仅存在于Session缓存中,可通过session.dirty与session.new属性检查待同步对象。若遇到事务状态异常,可调用session.in_transaction()确认当前状态,并检查是否因连接池耗尽或死锁导致隐式回滚。结合数据库事务隔离级别与ORM日志交叉比对,能快速定位会话管理缺陷。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









