

数据库表结构设计:范式规范与反范式化权衡

理解数据库范式与规范化设计原则
数据库范式是关系型数据库设计的理论基石,旨在通过消除数据冗余和更新异常来保障数据一致性。第一范式(1NF)要求表中的每个字段都是原子性的,不可再分,例如将“联系方式”拆分为“手机号”和“邮箱”。第二范式(2NF)在1NF基础上要求消除非主属性对主键的部分函数依赖,即所有非主键字段必须完全依赖于复合主键的全部列,这通常通过将多对多关系拆分为独立实体表来实现。第三范式(3NF)进一步要求消除传递函数依赖,确保非主键字段直接依赖于主键,而非依赖于其他非主键字段。例如,订单表中不应直接存储“客户地址”,而应通过“客户ID”关联查询。理解主键与函数依赖的关系,能帮助设计者快速识别表结构中的典型问题:若发现同一数据在多处重复存储或修改一处需同步多处,往往意味着未满足3NF要求。规范化设计的核心在于用空间换一致性,为后续业务扩展奠定可靠基础。
从业务场景设计符合范式的表结构
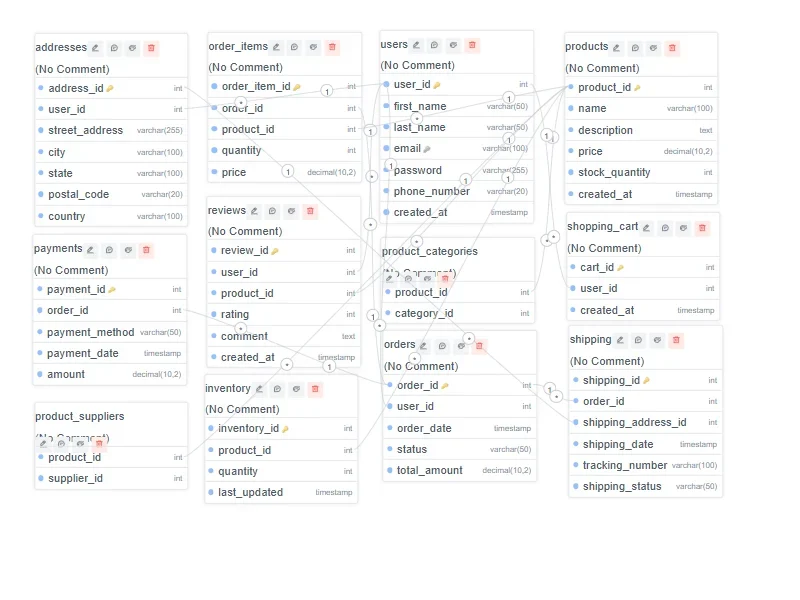
以电商订单系统为例,规范化设计需从业务实体拆解开始。首先识别核心实体:用户(User)、商品(Product)和订单(Order)。用户表以user_id为主键,存储基础信息;商品表以product_id为主键,记录名称、单价和库存。订单表以order_id为主键,记录下单时间、总金额及user_id作为外键关联用户。由于订单与商品是多对多关系,需建立订单明细表(Order_Item),采用order_id与product_id组成复合主键,并记录购买数量与成交单价。设计完成后需逐项验证:检查各表字段是否满足原子性(1NF);确认订单明细中的数量与单价完全依赖于复合主键,而非仅依赖单一订单或商品(2NF);核实订单总金额是否由明细计算得出,而非直接存储导致传递依赖(3NF)。通过外键约束与合理的索引设计,该结构能有效避免数据冗余,确保增删改操作的一致性,为复杂业务逻辑提供清晰的数据模型支撑。
识别规范化带来的性能与查询成本
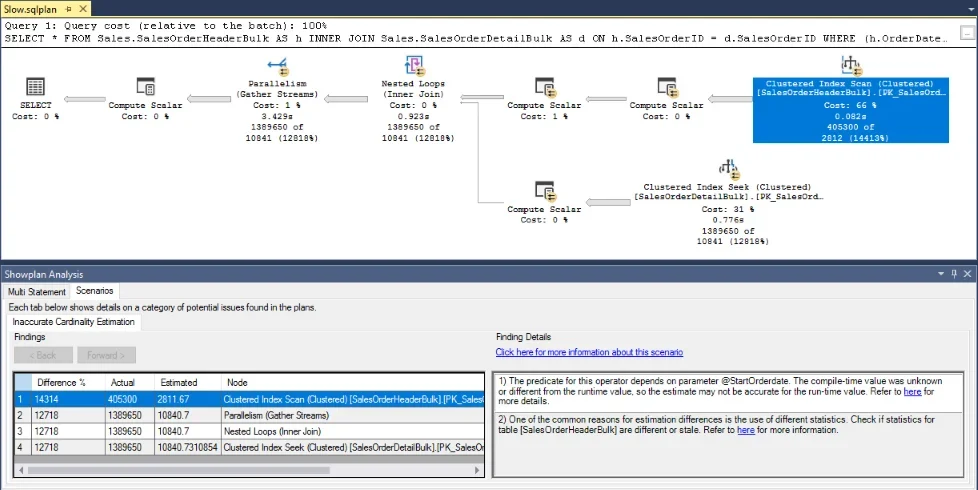
严格遵循范式虽能保障数据一致性,但在高并发读场景下会暴露明显的性能瓶颈。规范化设计将数据分散至多张表中,导致常规业务查询必须依赖多表JOIN操作。例如,获取某用户的订单详情及商品名称,需关联用户表、订单表、订单明细表与商品表。随着数据量增长,JOIN操作会引发大量的磁盘I/O与内存排序,显著拖慢响应时间。通过数据库执行计划(如MySQL的EXPLAIN)可直观评估查询成本:若出现全表扫描(type: ALL)或临时表(Using temporary),说明JOIN路径未命中索引或关联字段基数过大。规范化设计的局限在于将计算压力转移至查询阶段,导致CPU与内存资源消耗激增。建立性能评估指标时,应重点关注查询响应时间(P99延迟)、JOIN表数量、索引命中率及锁等待时间。当单表数据突破千万级且读请求占比超过80%时,过度规范化带来的查询复杂度将直接制约系统吞吐量,此时需重新审视设计策略。
根据场景实施反范式化并控制数据一致性风险
反范式化是应对高并发读场景的常见优化手段,其核心是通过可控的数据冗余换取查询性能。典型做法包括:在订单表中冗余“用户姓名”与“收货地址”,避免每次查询都JOIN用户表;引入汇总字段如“订单总金额”,由明细表实时计算后写入主表;或构建面向报表分析的宽表,将多维度属性扁平化存储。这些策略特别适用于读多写少、高频查询及离线分析场景,能大幅降低JOIN开销并提升缓存命中率。然而,反范式化必然引入数据一致性风险。冗余字段在源数据更新时若未同步,将导致数据不一致;宽表在写入时需维护多个关联状态,易引发更新异常。为控制风险,需采用异步消息队列或数据库触发器实现冗余数据的最终一致性同步,并在关键业务路径中引入版本号或乐观锁机制。同时,应明确反范式化的边界:仅对查询热点字段进行冗余,避免全量复制,确保系统仍具备可追溯的数据血缘关系。
用验证清单权衡范式与反范式化方案
在最终确定表结构方案前,需通过结构化验证清单进行多维度权衡。首先评估数据一致性要求:金融交易类核心数据必须严格遵循3NF,而内容展示类数据可适度放宽。其次量化查询频率与JOIN成本:若某查询日均调用超万次且涉及三表以上JOIN,反范式化收益显著。接着测算写入压力与存储开销:冗余设计会增加INSERT与UPDATE的CPU消耗与磁盘占用,需确认硬件资源是否充足。最后评估维护复杂度:反范式化表需配套数据同步脚本与监控告警,团队是否具备长期运维能力?常见避坑原则包括:绝不为了未经验证的潜在性能问题提前反范式化;优先通过索引优化、查询重写或读写分离解决性能瓶颈;反范式化必须配合明确的数据刷新策略与一致性校验机制。只有当性能指标明确不达标且优化成本高于冗余维护成本时,才应实施反范式化,确保架构演进始终在可控范围内。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









