

Python实现投影法分割图像示例(二)

本文基于前文绘制的水平与垂直投影图,详细讲解如何利用投影数据实现图像文本分割。通过判断像素点分布阈值确定行与列的分割坐标,进而提取文本所在的矩形区域。文章提供了完整的Python代码示例,涵盖从图像预处理、投影计算到最终框选文本块的全过程,适用于OCR前的文本定位场景。
投影法图像分割概述
在前一篇文章中,我们完成了水平投影图和垂直投影图的绘制工作。本文将在此基础上,利用已生成的投影数据执行图像分割操作。由于该方法在文本分割领域应用广泛,因此我们继续沿用之前的示例图片进行演示。
为了便于后续讲解,这里再次展示之前生成的两幅投影图。
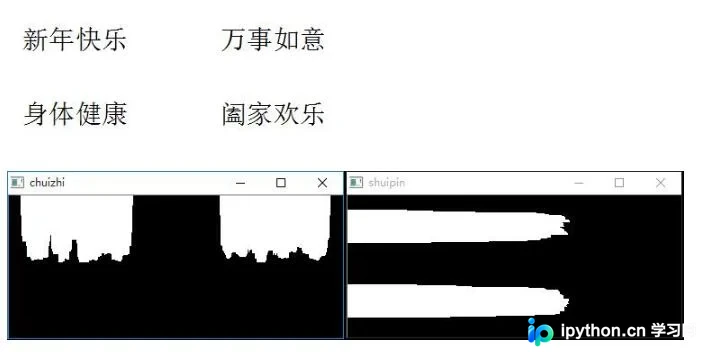
上述两张图分别展示了图像中文字在垂直和水平方向上的分布情况。我们可以将这两张图进行重叠处理(需注意调整比例),此时会形成四个重叠的白色区域。这些白色区域在原图中对应的位置即为文本所在区域。因此,下一步的核心任务是找出这些白色区域的坐标。鉴于白色区域近似为矩形,我们需要计算并确定该矩形的四个顶点坐标。
分割点确定原理与代码实现
接下来查看具体实现代码。
#根据水平投影值选定行分割点
inline = 1
start = 0
j = 0
for i in range(0,height):
  if inline == 1 and z[i] >= 150 : #从空白区进入文字区
    start = i #记录起始行分割点
    print i
    inline = 0
  elif (i - start > 3) and z[i] < 150 and inline == 0 : #从文字区进入空白区
    inline = 1
    hfg[j][0] = start - 2 #保存行分割位置
    hfg[j][1] = i + 2
    j = j + 1
确定行分割点的基本原理是判断每一行的像素点数是否达到一定阈值。从水平投影图中可以看出,白色区域代表有文字的地方(原图为黑字白底,但在绘制投影图时采用了白块黑底的表示方式)。在空白区域,灰度值为0的像素点数量N较少;而当进入文字区域时,N值会显著增大。基于这一特征,我们可以确定进入文字区的起始坐标(A1,B1)。当从文字区回到空白区域时,N值再次变小,此时记录结束坐标(A1,B2)。列分割点的确定原理与此相同。
  incol = 1
  start1 = 0
  j1 = 0
  z1 = hfg[p][0]
  z2 = hfg[p][1]
  for i1 in range(0,width):
    if incol == 1 and v[i1] >= 20 : #从空白区进入文字区
      start1 = i1 #记录起始列分割点
      incol = 0
    elif (i1 - start1 > 3) and v[i1] < 20 and incol == 0 : #从文字区进入空白区
      incol = 1
      lfg[j1][0] = start1 - 2  #保存列分割位置
      lfg[j1][1] = i1 + 2
      l1 = start1 - 2
      l2 = i1 + 2
      j1 = j1 + 1
结果展示与后续处理
最后,根据计算出的矩形坐标将文本区域在图像中框选出来。以下是完整的代码实现。
import cv2
import numpy
img = cv2.imread('D:/0.jpg',cv2.COLOR_BGR2GRAY)
height, width = img.shape[:2]
#print height, width
#resized = cv2.resize(img, (2*width,2*height), interpolation=cv2.INTER_CUBIC)
gray = cv2.cvtColor(img, cv2.COLOR_BGR2GRAY)
(_, thresh) = cv2.threshold(gray, 140, 255, cv2.THRESH_BINARY)
#使文字增长成块
kernel = cv2.getStructuringElement(cv2.MORPH_RECT, (2, 2))#形态学处理,定义矩形结构
closed = cv2.erode(thresh, None, iterations = 7)
#cv2.imshow('erode',closed)
height, width = closed.shape[:2]
#print height, width
z = [0]*height
v = [0]*width
hfg = [[0 for col in range(2)] for row in range(height)]
lfg = [[0 for col in range(2)] for row in range(width)]
box = [0,0,0,0]
#水平投影
a = 0
emptyImage1 = numpy.zeros((height, width, 3), numpy.uint8)
for y in range(0, height):
  for x in range(0, width):
    cp = closed[y,x]
    #if np.any(closed[y,x]):
    if cp == 0:
      a = a + 1
    else :
      continue
  z[y] = a
  #print z[y]
  a = 0
#根据水平投影值选定行分割点
inline = 1
start = 0
j = 0
for i in range(0,height):
  if inline == 1 and z[i] >= 150 : #从空白区进入文字区
    start = i #记录起始行分割点
    #print i
    inline = 0
  elif (i - start > 3) and z[i] < 150 and inline == 0 : #从文字区进入空白区
    inline = 1
    hfg[j][0] = start - 2 #保存行分割位置
    hfg[j][1] = i + 2
    j = j + 1

#对每一行垂直投影、分割
a = 0
for p in range(0, j):
  for x in range(0, width):
    for y in range(hfg[p][0], hfg[p][1]):
      cp1 = closed[y,x]
      if cp1 == 0:
        a = a + 1
      else :
        continue
    v[x] = a #保存每一列像素值
    a = 0
  #print width
  #垂直分割点
  incol = 1
  start1 = 0
  j1 = 0
  z1 = hfg[p][0]
  z2 = hfg[p][1]
  for i1 in range(0,width):
    if incol == 1 and v[i1] >= 20 : #从空白区进入文字区
      start1 = i1 #记录起始列分割点
      incol = 0
    elif (i1 - start1 > 3) and v[i1] < 20 and incol == 0 : #从文字区进入空白区
      incol = 1
      lfg[j1][0] = start1 - 2  #保存列分割位置
      lfg[j1][1] = i1 + 2
      l1 = start1 - 2
      l2 = i1 + 2
      j1 = j1 + 1
      cv2.rectangle(img, (l1, z1), (l2, z2), (255,0,0), 2)
cv2.imshow('result', img)
cv2.waitKey(0)
代码中包含了一些被注释掉的片段,这些部分包含了一些调试时的微小变动或用于观察中间值的代码,读者可根据需要自行查阅。
最后展示分割后的结果图像。
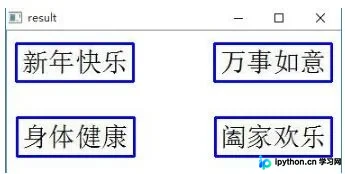
既然已经获取了文本的坐标信息,接下来可以使用PIL或OpenCV等库将这些文本块截取出来,此处不再赘述具体截取代码。
以上关于Python实现投影法分割图像的示例(二)的全部内容已分享完毕,希望能为读者提供有价值的参考。欢迎大家继续支持本站。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









