

Python Faker:伪造数据与测试填充

安装 Faker 并理解 Provider 数据生成机制
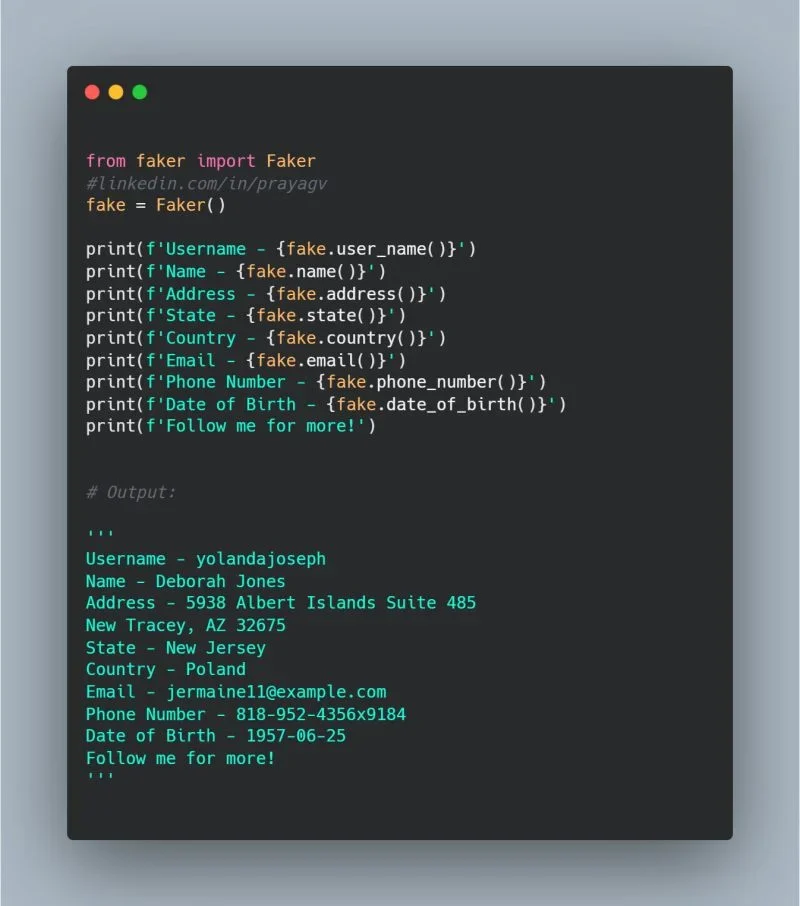
安装 Faker 只需执行 pip install faker。其核心机制基于 Provider(数据提供者),每个 Provider 封装了特定领域的数据生成逻辑。创建实例后,通过点语法调用对应方法即可获取伪造数据。例如,fake.name() 生成姓名,fake.email() 生成邮箱,fake.address() 生成地址,fake.date() 生成日期,fake.random_int() 生成数字。Faker 内部维护了庞大的词库与规则映射,调用时动态组合输出。实际开发中,建议将 Faker 实例化放在测试夹具或初始化模块中,避免重复创建开销。以下代码展示了基础调用:
from faker import Faker
fake = Faker()
print(fake.name(), fake.email(), fake.date(), fake.random_int(100, 999))
运行后会输出符合默认英文格式的随机数据。理解 Provider 的按需加载特性,有助于按需扩展自定义生成器,提升测试数据构造效率。
生成本地化数据与批量测试数据
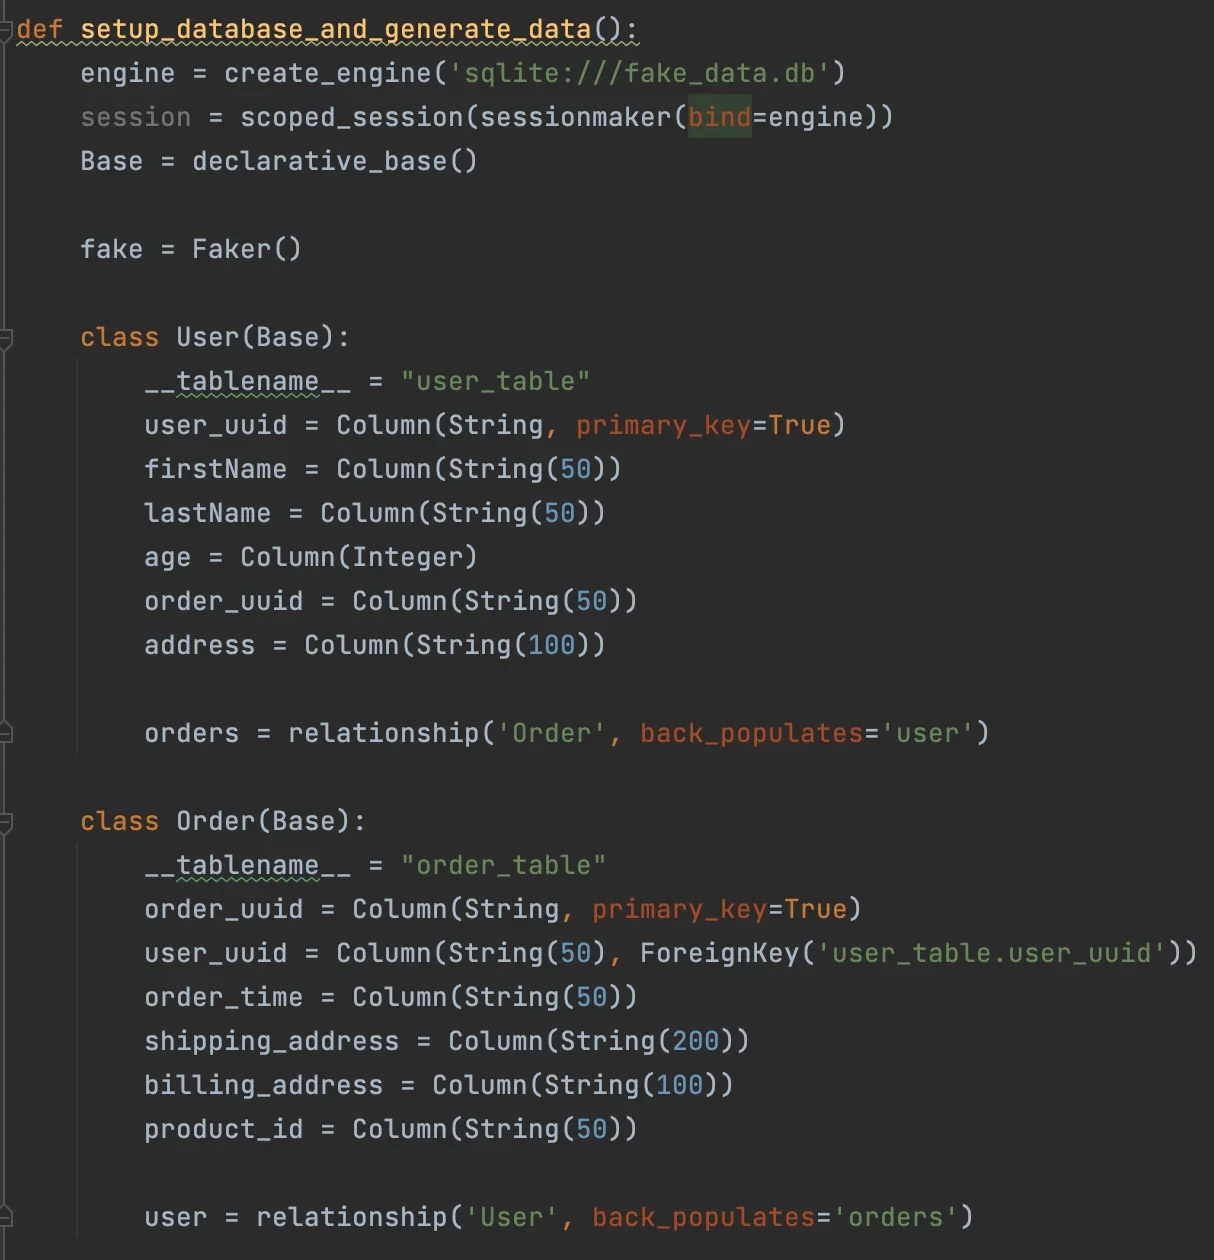
在跨国业务或多语言测试中,本地化(Locale)配置至关重要。通过传入 locale 参数,如 Faker('zh_CN'),可生成符合中国规范的手机号、身份证号与地址。批量生成通常结合列表推导式或循环实现,以快速构造用户列表或订单流水。设计数据结构时,建议将 Faker 调用封装为字典或数据模型,确保字段类型与业务契约一致。例如,生成五十条用户记录:
fake = Faker('zh_CN')
users = [{'name': fake.name(), 'phone': fake.phone_number(), 'city': fake.city()} for _ in range(50)]
该方式不仅代码简洁,还能通过去重逻辑避免重复值。批量生成时应注意内存占用,对于超大规模数据可改用生成器逐批产出,配合流式写入或分页处理,保障测试脚本的稳定性与执行效率。
控制随机性:唯一值、种子与可复现测试
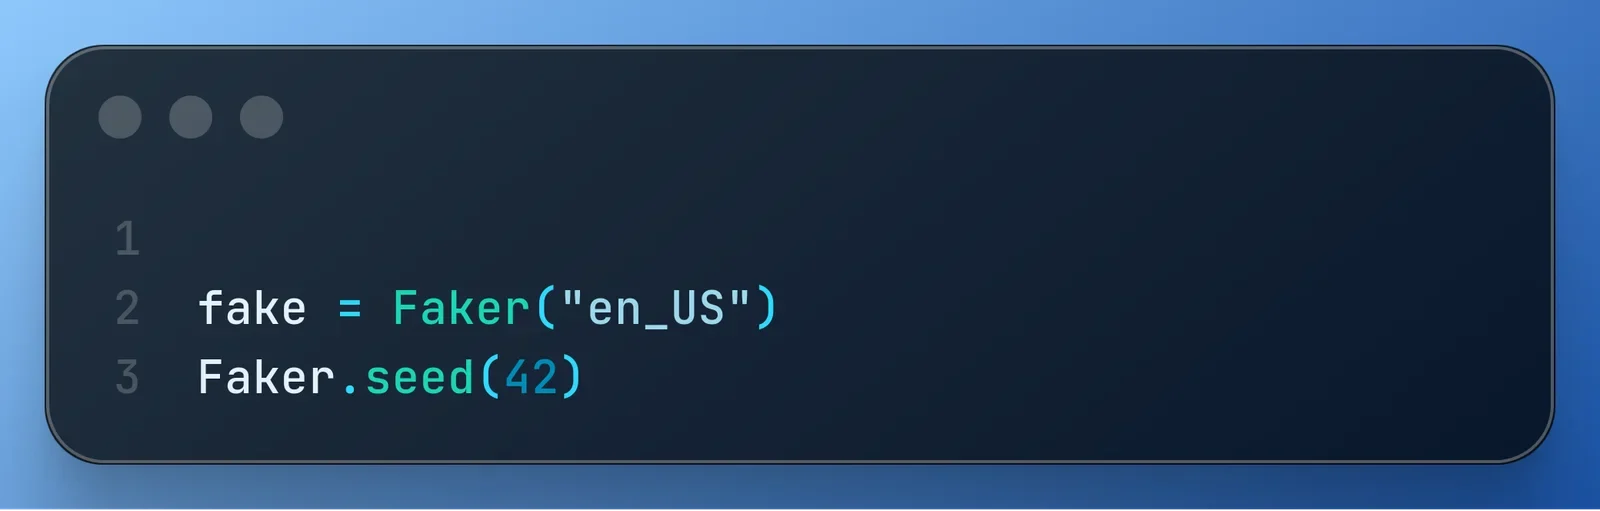
测试的可复现性依赖于对随机性的精确控制。Faker 提供 seed 方法固定随机数生成器的初始状态,确保多次运行输出完全一致,这对回归测试与持续集成流水线极为关键。调用 fake.seed_instance(42) 后,后续所有生成结果将锁定。对于需要全局唯一值的场景,可使用 fake.unique 代理,如 fake.unique.email()。但需注意,唯一值池有容量上限,频繁调用可能触发唯一性耗尽异常。合理做法是结合业务主键策略,或在测试前清理状态。示例对比:
fake.seed_instance(100)
print(fake.name())
print(fake.unique.email())
明确何时需要确定性数据用于断言校验,何时保留真随机性用于压力测试,是构建高质量测试套件的核心原则。
填充数据库并验证测试数据质量
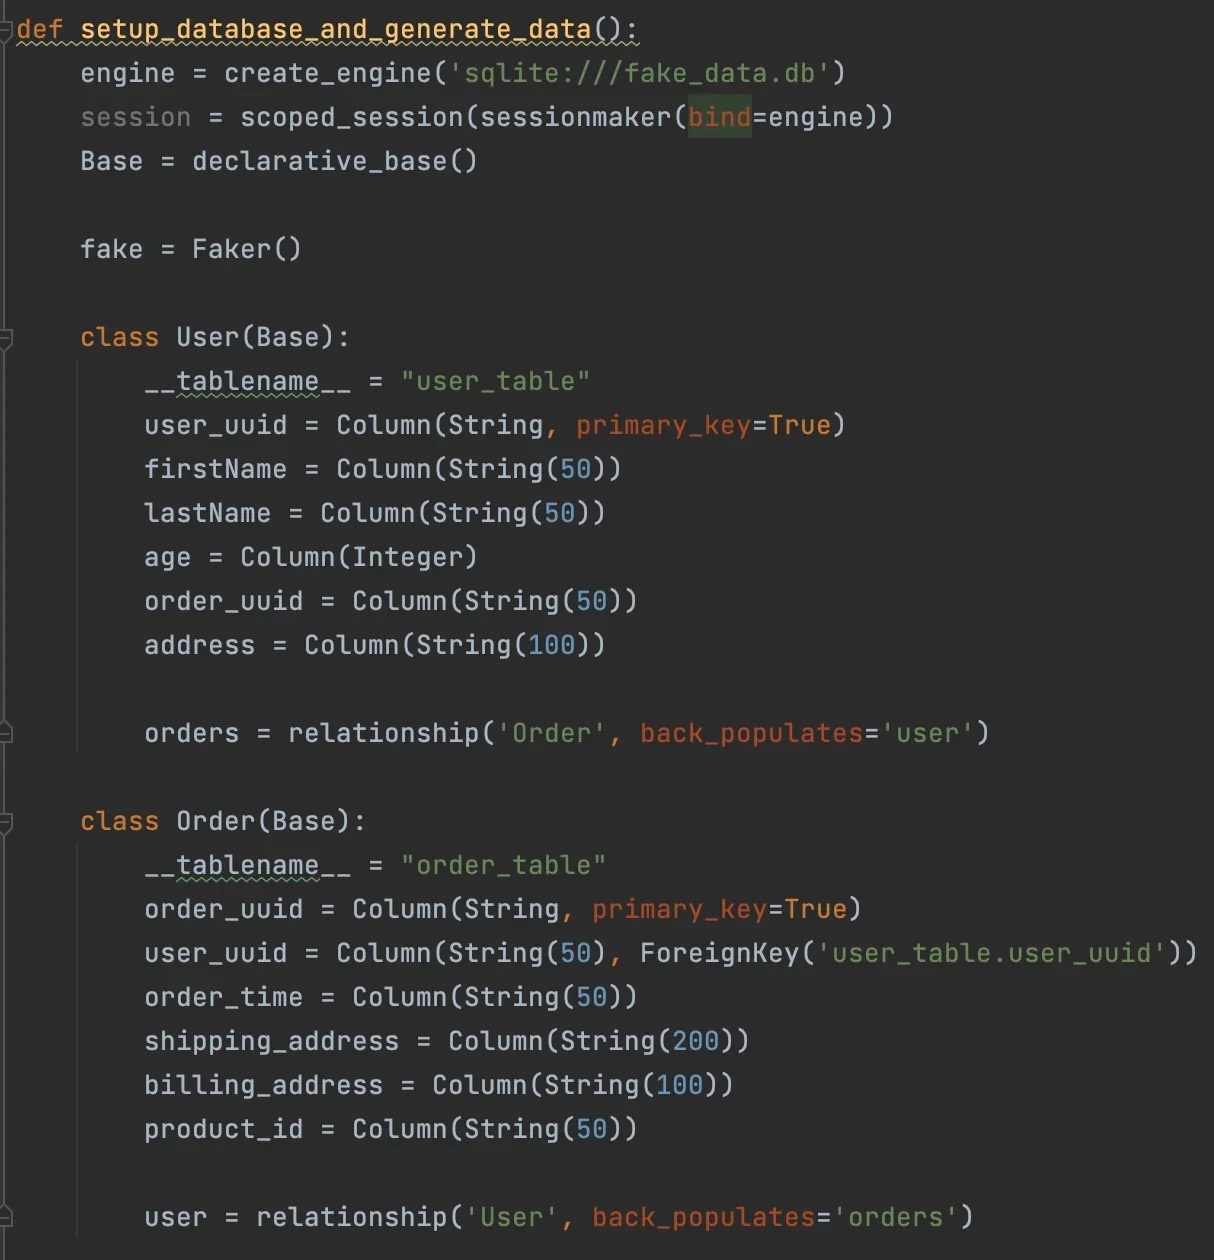
将 Faker 数据持久化至测试数据库是验证业务逻辑的关键步骤。以 SQLite 和 SQLAlchemy 为例,可先定义数据模型,再利用 Faker 批量实例化对象后通过会话批量提交。写入后需进行质量验证:检查记录总数是否符合预期、字段格式是否匹配正则、外键关联是否完整、唯一约束是否生效。例如:
engine = create_engine('sqlite:///test.db')
session.bulk_save_objects([User(name=fake.name(), email=fake.email()) for _ in range(100)])
session.commit()
验证阶段可编写独立断言脚本,查询数据库并比对数据分布。若发现空值率异常或格式越界,需回溯 Faker 的 Provider 配置。通过自动化校验脚本,可确保测试环境数据既具备多样性,又严格遵循业务规则。
常见坑与数据安全实践
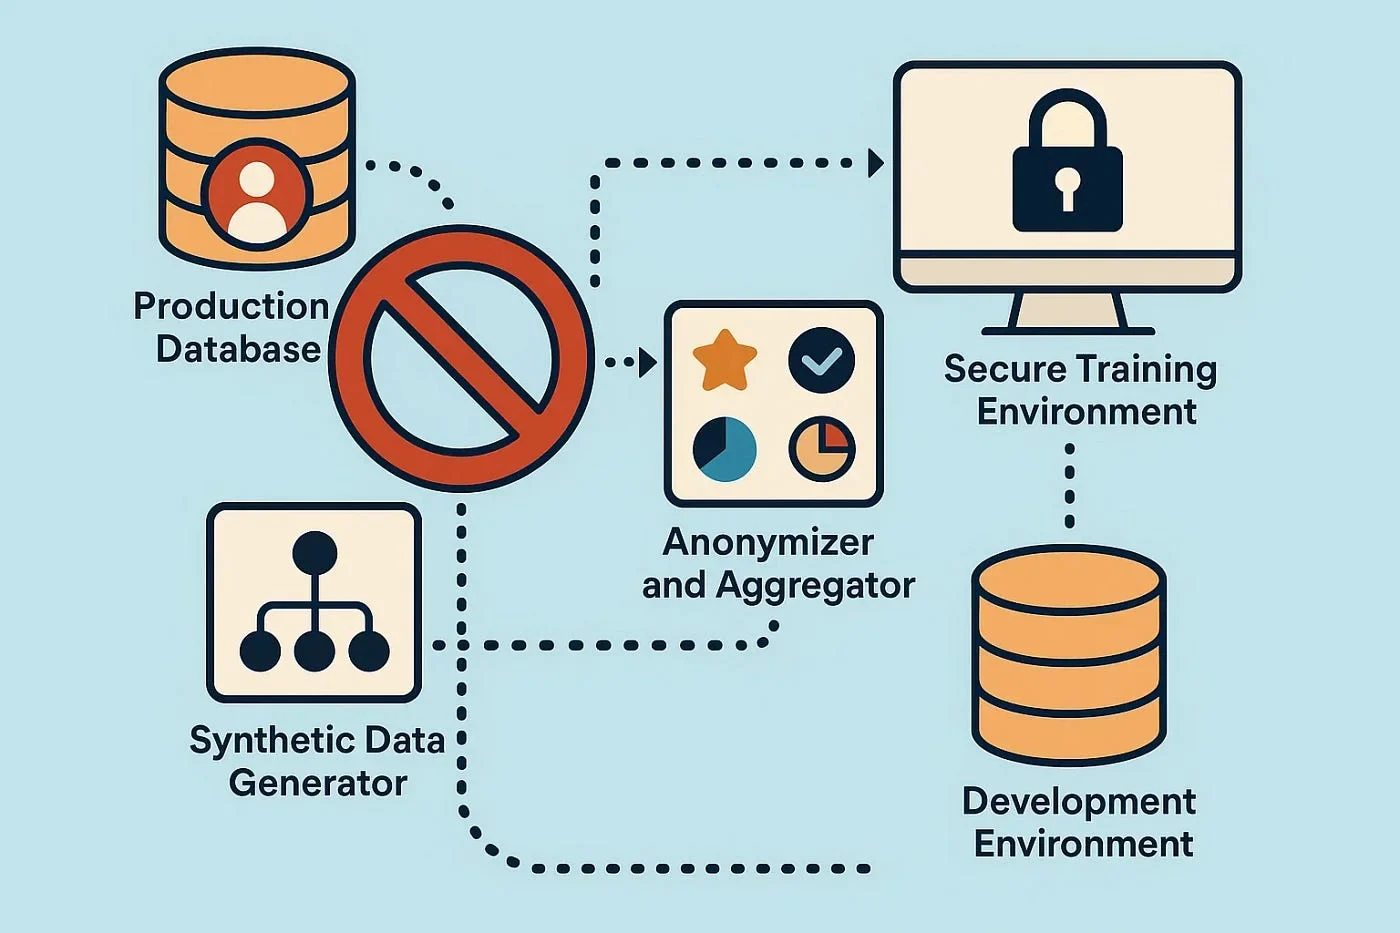
使用 Faker 时常见陷阱包括:未指定 Locale 导致地址或电话格式与目标市场不符;过度依赖随机性使断言难以稳定通过;唯一值耗尽引发异常中断流水线;以及随机种子被全局修改污染其他测试用例。更严重的是误将 Faker 生成的数据同步至生产环境,或混淆合成数据与真实用户隐私边界。最佳实践是:在测试配置文件中显式声明种子与 Locale;为唯一值生成设置合理的重试与回退策略;严格隔离测试与生产网络,禁止测试脚本直连生产库。合成数据仅用于功能验证与性能压测,涉及合规审计时,应使用脱敏后的真实数据或符合隐私规范的匿名化数据集。建立数据生成规范与审查流程,是保障研发安全与数据合规的底线。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









