

网络安全:目录遍历与路径规范化

理解目录遍历与路径解析机制
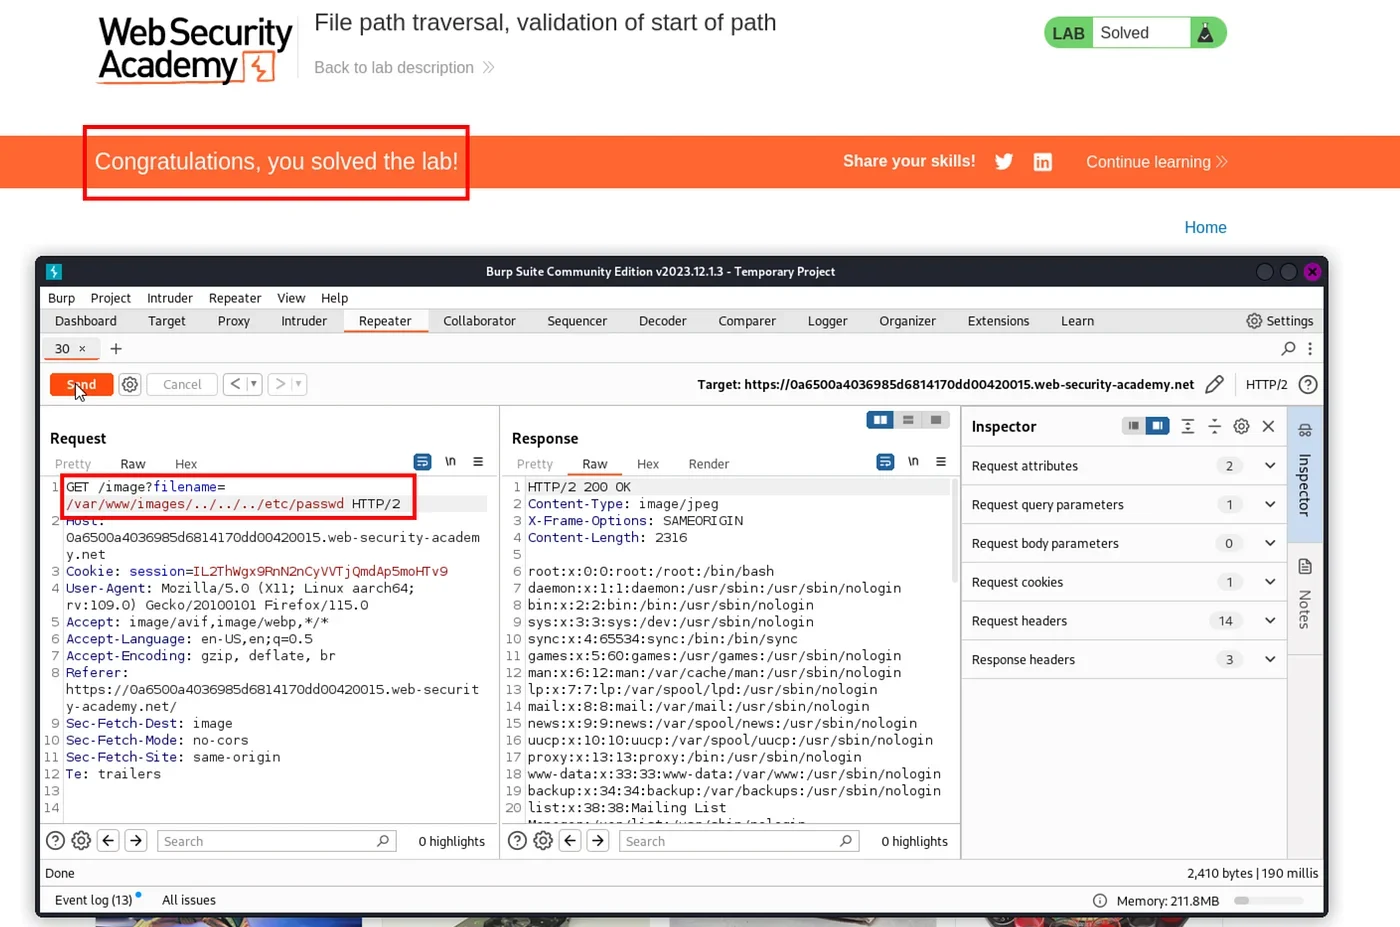
目录遍历(Directory Traversal)漏洞源于应用程序未对用户传入的文件路径参数进行严格过滤,导致攻击者可通过构造特殊字符突破预设目录限制,访问系统任意文件。在典型Web应用中,当用户请求如`/download?file=report.pdf`时,后端代码通常会将参数值与服务器基础目录拼接,随后交由操作系统文件API执行读取。操作系统在解析路径时,会逐层处理目录分隔符与相对路径符号。例如,若传入`../../../etc/passwd`,系统会依据当前工作目录向上回溯,最终定位到根目录下的敏感文件。正常文件访问严格限定在应用沙箱内,而目录遍历则利用路径解析机制中的相对跳转特性,将访问边界非法外扩。开发者需明确,任何直接信任用户输入并参与文件系统调用的行为,均可能触发越权读取风险。理解该机制是构建后续防护体系的基础。
路径规范化与危险输入识别
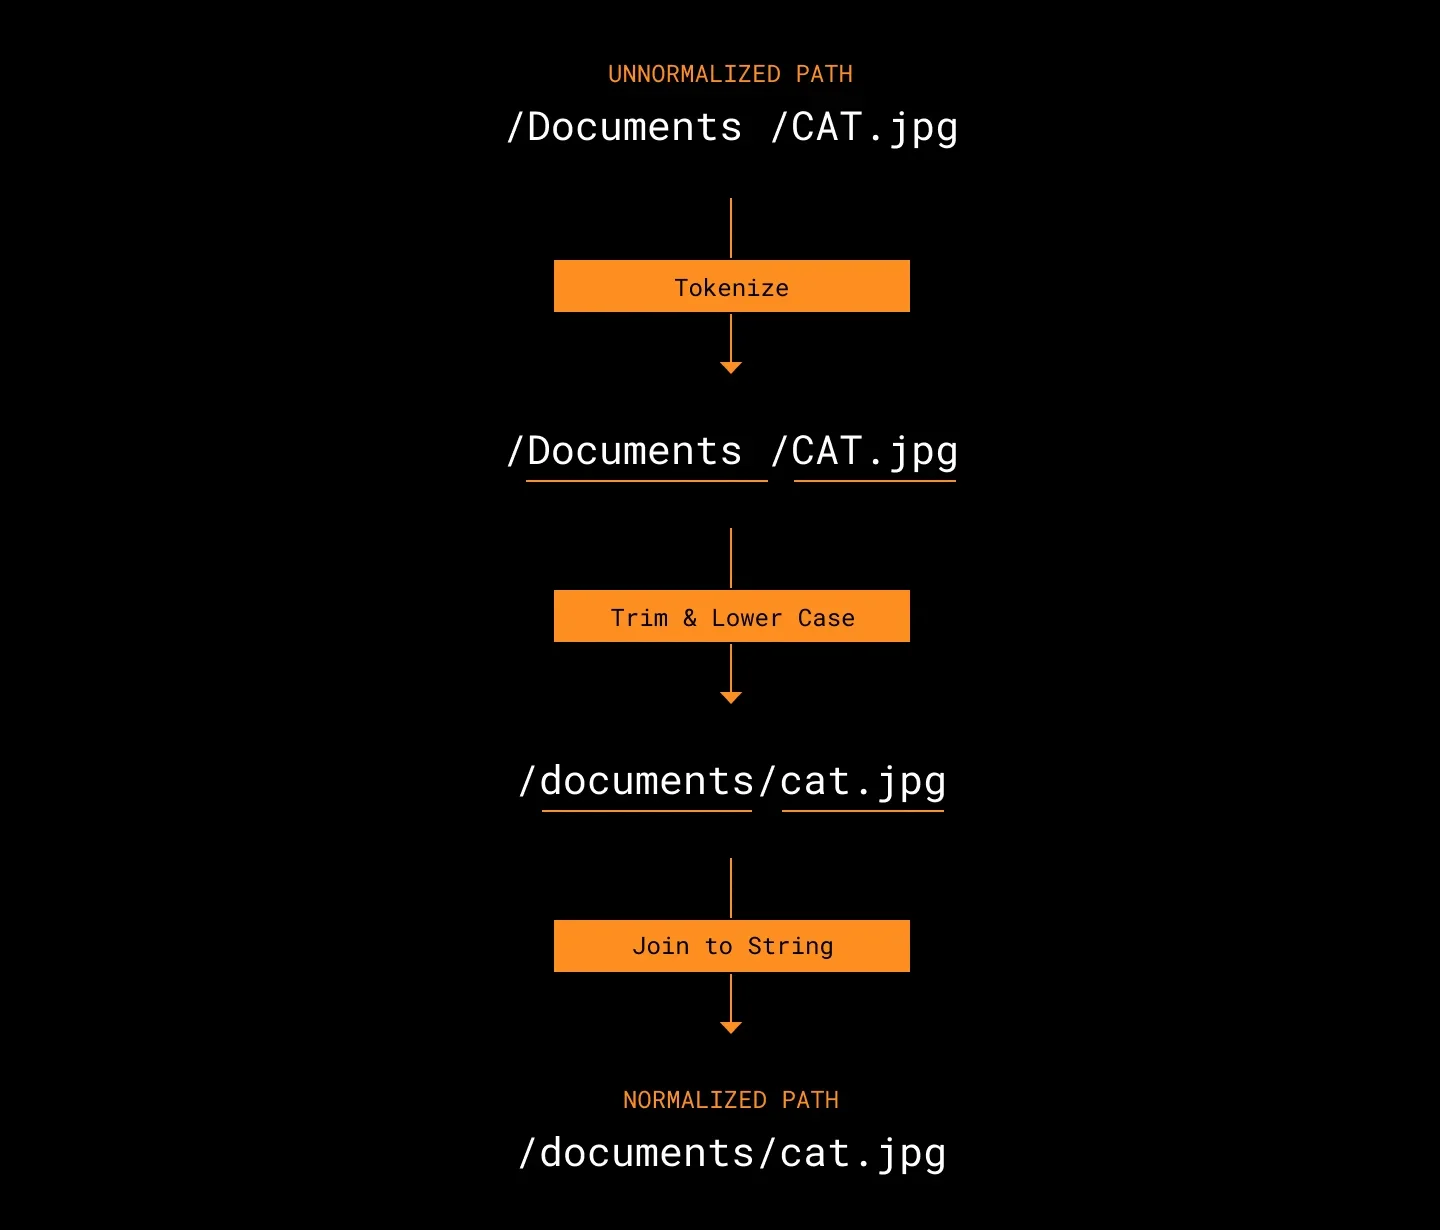
路径规范化(Path Normalization)是将包含冗余符号、相对跳转或编码字符的路径转换为唯一、绝对的标准形式(Canonical Path)的过程。攻击者常利用`../`、绝对路径、URL编码(如`%2e%2e%2f`)、双重编码或符号链接绕过基础过滤。例如,输入`..%2f..%2fetc/passwd`经URL解码后变为`../../etc/passwd`,若直接拼接至基础目录,系统解析时会将其规范化为`/etc/passwd`。仅使用字符串替换(如移除`../`)极易被`....//`或混合编码绕过。安全识别需遵循“先解码、再拼接、后规范化”原则。现代开发框架提供标准API(如Python的`os.path.realpath`或Java的`Path.normalize()`)可自动解析符号链接并消除相对路径。开发者必须在执行任何文件操作前,将输入路径转换为规范路径,并与预期基准路径进行严格比对,从而在解析阶段拦截非法跳转。
安全实现文件访问与输入校验
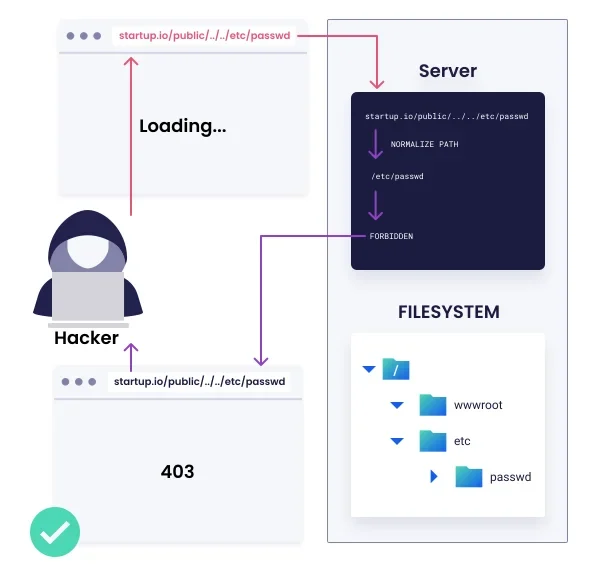
构建安全的文件访问架构需采用纵深防御策略,杜绝不安全的字符串拼接。首先实施白名单校验,仅允许预定义的文件名或扩展名通过,从根本上阻断恶意路径注入。其次,调用操作系统级路径规范化函数处理输入,确保路径处于绝对且无歧义状态。随后执行基准目录约束检查:验证规范化后的路径是否以应用指定的安全根目录(如`/var/www/uploads/`)开头。若校验失败,立即终止请求并返回403状态码。示例代码中应避免`base_dir + user_input`的写法,改用安全路径拼接函数(如`os.path.join`)结合前缀校验。此外,需关闭目录列表功能,限制文件读取权限,并在服务端统一处理路径逻辑。通过“白名单过滤+规范化转换+前缀强校验”的流水线,可有效隔离用户输入与文件系统底层调用,建立可靠的访问控制边界。
验证防护效果与常见避坑
防护方案上线前必须通过系统化安全测试验证其有效性。测试用例应覆盖正常访问(如`/docs/readme.txt`)、基础遍历(`../../etc/shadow`)、编码绕过(`%2e%2e%2f%2e%2e%2f`)、空字节截断(历史遗留问题)及符号链接越权等场景。预期结果应为:合法路径返回200及正确内容,非法路径一律拦截并返回403或404,同时触发安全审计日志记录请求源IP、原始参数与拦截原因。常见避坑要点包括:切勿依赖前端JavaScript校验,攻击者可轻易绕过;注意不同操作系统对大小写与路径分隔符的差异(Windows不区分大小写,Linux区分);防范TOCTOU(检查与使用之间的时间差)竞态条件,确保校验与读取操作原子化;定期更新依赖库以修复底层路径解析缺陷。通过持续的红蓝对抗与日志监控,可确保防护机制在真实攻击面前保持韧性。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









